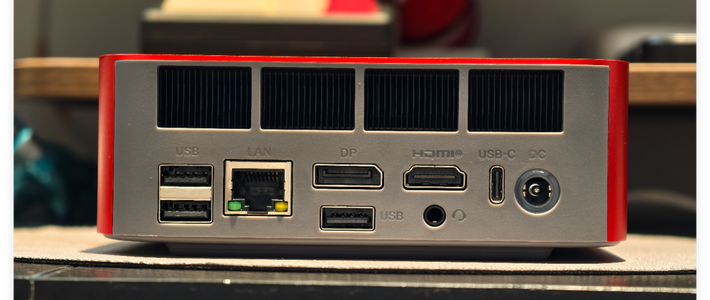
今年双十一前翻零刻的产品线,你会发现一个很整齐的现象:官方频道在讲 GTR9 Pro 495 怎么玩 AI 集群,从本地大模型部署讲到多机协同,MEPro 则和飞牛做成了联名私有云、被拿起来跑本地大模型工作流,而 7 月底上架的 SEi13 AI / SEi14 AI,直接把"为本地 AI 推理而生"写进了商品页。 四条产品线,指向同一个方向。哔哩哔哩知乎微博
但这一堆"AI 新品"里,最让人看不懂的反而是 SEi13 AI:一台 i7-13620H 的办公底子小主机,价签标到 11,895 元——多出来的钱,买的是 M.2 位上的一张"算力卡",自带 24GB LPDDR5 推理专用内存,标称 160 TOPS。它到底是本地 AI 的第三条路,还是涨价潮里的一场营销?B 站那期测评底下 215 条评论的争吵,比官方宣传页诚实得多。
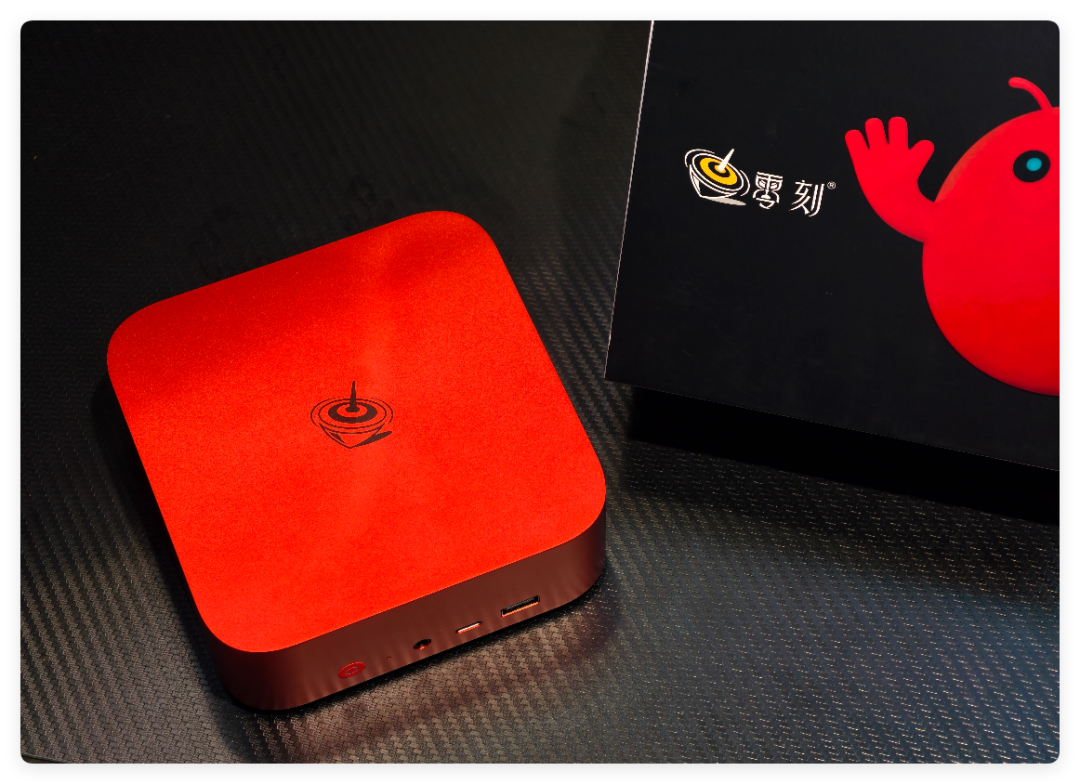
这台机器的"AI",到底 AI 在哪
先把事实摆清楚。SEi13 AI 是 X86 处理器 + 独立 NPU 的双架构:主机本身是常规 SEi 模具,i7-13620H、32GB 内存、1TB SSD,2.5G 网口;真正的新东西是插在原第二个 M.2 位上的那张卡——192bit 位宽、153.6GB/s 带宽、24GB 专用 LPDDR5。 评论区里查到卡来自后摩智能,是存算一体方案。微博哔哩哔哩
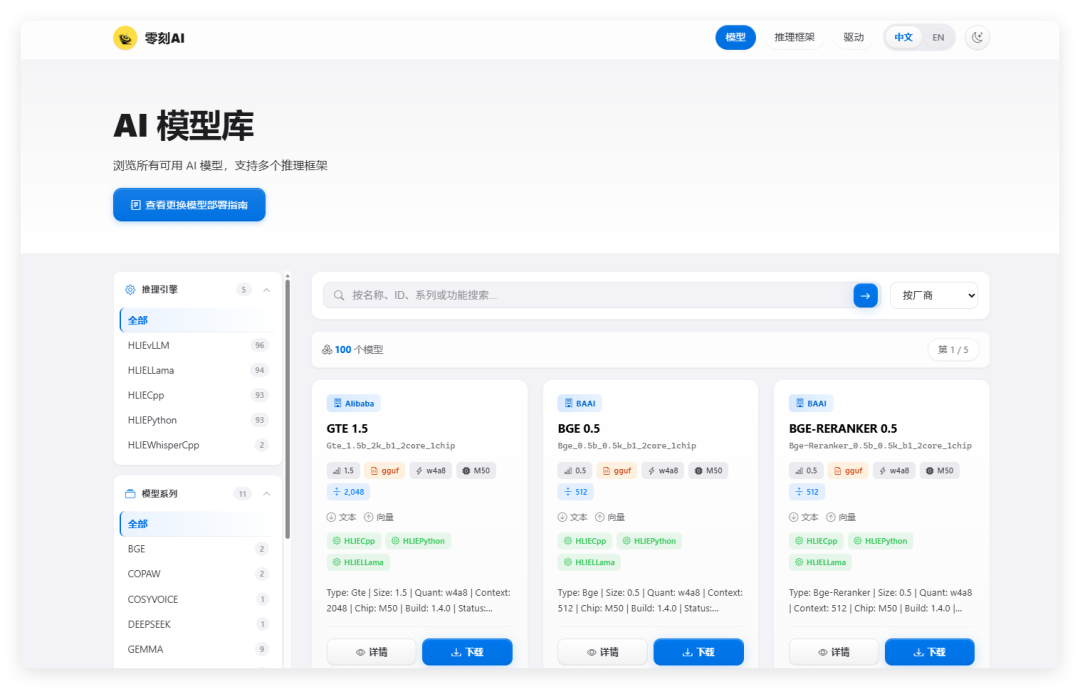
系统预装 Ubuntu 24 + llama.cpp 推理框架,默认常驻 qwen3.5-9b,桌面还有 OpenClaw 应用,开机就能跟自己的模型对话。零刻直接给了一个适配好的模型库,目前内置约 100 个模型,LLM、Whisper、OCR、embedding、reranker、ASR 都覆盖。知乎
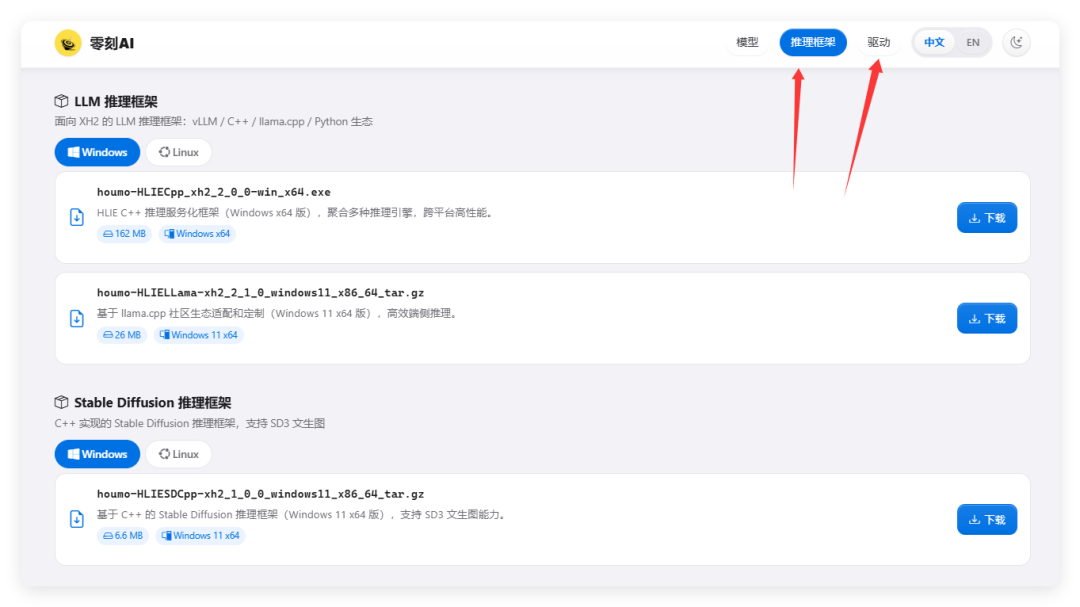
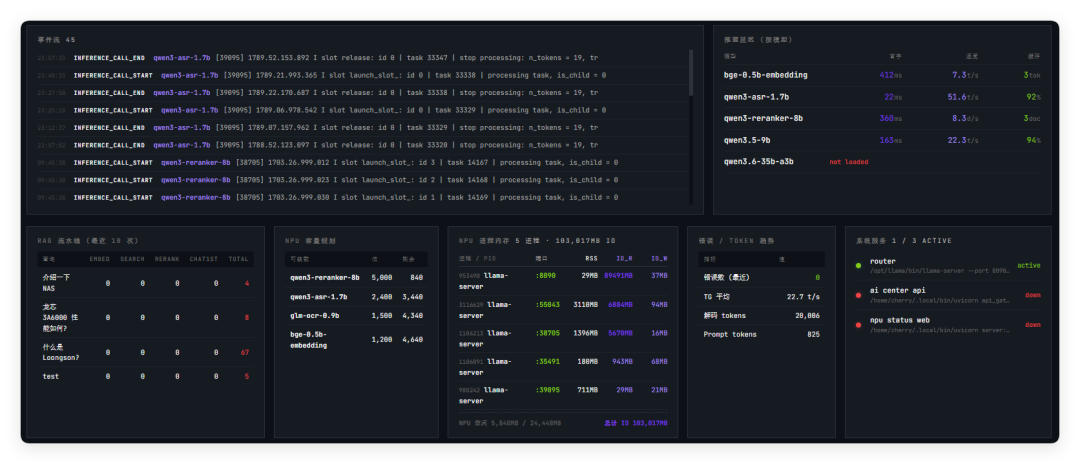
它的核心卖点叫"算、算分离",可以理解为 NAS 圈"存算分离"的翻版:CPU 只负责派活、收集、分配,真正耗算力的模型推理全部由 NPU 独立完成,不抢系统内存。跑着模型,主机照样能正常开网页、办公、跑 Agent——这是它和"CPU+核显硬跑 llama"路线最本质的区别。首发实测也提醒了两个上手细节:Ubuntu 默认只给约 100GB 空间,剩下要自己挂 LVM;用 llama.cpp 的 router 模式架多模型路由很诱人,但目前 M50 在多模型动态切换时仍存在一定稳定性问题,正式使用阶段最好保持主 LLM 常驻。知乎
实测天花板:能干什么,不能干什么
同一批实测给出的数字很一致:qwen3.5-9b 开 128K 上下文常驻,再按需挂 embedding、reranker、ASR 这类配套小模型,整套体系能顺畅运转;单模型换成 qwen3.6-35B-A3B 的 MoE 架构也塞得进 24GB,输出 23 tok/s 往上。 但 35B 会把 NPU 内存基本占满,RAG 配套模型就没地方放了。知乎
翻译成人话:这是一台适合"一个常驻管家 + 几个随叫随到的小模型"的机器,适合文档、合同、照片这类不想出门的数据做本地预处理和问答;它不是一台"随时换大模型聊天"的机器。带宽 153.6GB/s 的天花板摆在那里,评论区懂行的用户一眼看穿——点赞最高的那条只有一句话:算力太低,显存太少,但凡是个 64G 内存才能跑更能的模型。哔哩哔哩
关键问题来了:11,895 到底买了什么账
在 2026 年这个内存价格被 AI 需求顶飞的时间点,这笔账要四条路线放在一起才算得清。先对齐行情:零刻 2026 款 GTR9 Pro 换上锐龙 AI Max+ PRO 495、标配 128GB+2TB,电商首发价标到 29,998 元。 而测评区的老用户还在念叨:去年零刻 395 的 128G 版才 1.5 万不到。微博哔哩哔哩
路线 | 大概方案 | 当前行情下的问题 |
|---|---|---|
A. 核显大内存自组 | 高带宽核显机型 + 自己加 64GB 内存 | 内存/SSD 全线涨价,加条成本直接吞噬整机差价 |
B. 统一内存旗舰 | 锐龙 AI Max 395/PRO 495,128GB 起步 | 去年不到 1.5 万的 395 128G 档,今年 495 版 GTR9 Pro 首发 29,998 |
C. NPU 算力卡 | 零刻 SEi13 AI,11,895 | 推理内存焊在卡上,不碰系统内存行情;缺点是性能天花板明码标价 |
D. 自托管 + 云 API | 普通电脑装开源 Octop,接魔搭等免费额度 | 机器随便找,数据也"不出门",但免费额度越来越薄 |
C 路线最容易被低估的价值就在这:当整机厂都被内存行情逼着涨价、DIY 用户对着内存价签骂街的时候,它把 24GB 推理内存"焊"在了一张卡上——这部分容量不参与市场竞价。评论区甚至有人报出这张卡单卖约 7,000 元、多余 M.2 位可以直接插。 这个行情属于网友口径,官方店铺未见明码标价,但如果属实,等于为整机差价 5,000 元买了整套调好的系统、模型库和官方质保;而评论区那句"省流一万出头不如买 64G 的 395"的潜台词,其实是被今年行情逼出来的:395 大内存机型早就不是一万出头能拿下的东西了。哔哩哔哩
D 路线则是今年 10 月刚长出来的新变量:腾讯云开源了自托管 AI 助手平台。 它的名字叫 Octop,实测一台 i5-9400F + 16GB 内存的普通 Windows 电脑就能跑起来,聊天记录的归属权完全在自己手里。知乎知乎
但它有个致命依赖:Octop 是壳,"大脑"要外接大模型 API,而各家免费额度正在肉眼可见地收紧——DeepSeek 官方已经不送额度了,新号 0 余额;硅基流动的奖励券抵不了欠费;最后能稳定白嫖的魔搭社区按"魔粒"计费,一天签到 250 粒,而 Agent 每轮对话内部要跑上十次模型调用,平均一轮烧掉 10 粒,满打满算每天只够 20 来轮正经对话。 想 7×24 挂一个本地管家,云端白嫖撑不住,自建推理又回到前三条路线的硬件账。知乎
215 条评论吵出来的三条分歧
把 B 站那期测评的评论区翻完,反对和辩护集中在三件事上:
第一,160 TOPS 的真实性。高赞评论说得客气:“是真的,但营销意义大于实际 LLM 性能意义”;更直接的说法是——标的是稀疏还是稠密算力、什么数据类型,官方给不给算子适配文档,这三问目前都没有硬答案。哔哩哔哩
第二,带宽是不是死穴。192bit、153.6GB/s 被反复点名"不够跑更大的模型",有评论搬出了同芯片方案的上限:单芯片最大 48GB 内存,双芯能到 307G 带宽、320T INT8,纸面够了,价格也能上一个 4090 了。 这张卡的性价比成立区间,其实被带宽框得很死:9B~35B-A3B 这一档舒服,再往上就别碰。哔哩哔哩
第三,它到底算不算"国产 DGX Spark"。有人调侃这是国产版英伟达 DGX Spark,也有博主的态度在用了一个月后来了个反转:刚拿到时看配置是真劝退,放进生产环境跑了一阵又发现潜力无限。 两种说法都对,取决于你把 AI 用在哪:当玩具看参数,它全是短板;当一个不占系统资源、不抢市场内存的常驻推理盒,它目前几乎是 X86 小主机里独一份的方案。哔哩哔哩
结论:哪三类人值得进,哪三类人别碰
值得等的情况:你手里有合同、家庭照片、素材库这类敏感数据需要本地 AI 处理;你的需求恰好落在 9B~35B-A3B 这个带宽舒服区;你在等双 11 的价格信号——这台机器 7 月底的 11,895 首发价,一路撑到了双十一门口,值得盯。零刻的 5 年质保也是这类新形态机器敢尝鲜的底气,评论区就有人明说"买零刻的另一个重要原因是 5 年质保"。哔哩哔哩
别碰的情况:目标是随时跑 70B 以上或当 GPU 平替,带宽会教你做人;你已经有一台 128GB 统一内存的 395/400 系机型,这台对你没有任何增量;你只是想要"AI 概念"的桌面好看,那 EQ 系列那一档省电小机器更便宜。
继续盯四个信号
那张 M.2 NPU 卡是否正式单卖、定价是否坐实网友说的 7,000 元档——单卖价就是整机的价格锚;
双芯版本(307GB/s 带宽、48GB 显存档)会不会跟进小主机;
M50 驱动的多模型 router 稳定性修复进度,这直接决定"管家 + 工具链"工作流能不能全量用起来;
双 11 期间 SEi13 AI 是否进国补名单、直降多少——对比它 29,998 那位旗舰邻居的促销力度,就能看出零刻到底把哪条路线当走量主力。
本地 AI 这盘棋,2026 年下半年才真正开始分层:旗舰拼容量、SEi 拼专用算力卡、NAS 拼 7×24 常驻、白嫖党拼 API 额度。零刻把四条路线全摆上了货架,这本身就是最好的行业信号——接下来就看双 11 的价签,替谁投了票。