1670分登顶、成本1/10:"学霸"DeepSeek的降维打击到底是什么

源自146位全网作者

15:35

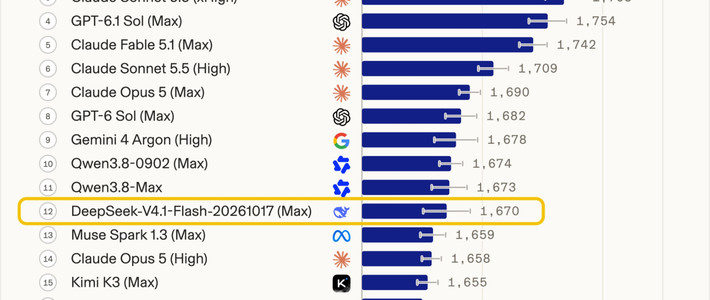
热榜里的"学霸",说的是 DeepSeek 自己:10月17日,它把 V4.1 Flash 更新到 V4.1-Flash-1017,网页端、APP 和 API 同步切换,价格一分没涨,权重照样开源。 两天后,评测平台 Arena 官宣它以 1670 分成为 Code Arena: WebDev 榜单排名最高的开源模型,综合使用成本只有同档开源第一的 Kimi K3(Max)约十分之一。 而10月17日晚上,它顺手开放了自研搜索与抓取接口,价格压到5块钱一千次。 所以"降维打击"的准确含义不是分数破了纪录,而是"榜单头部"和"价格底部"同时出现在一个模型身上,还附带一个重新定价的搜索入口。知乎·程序员鱼皮未来图灵持续降熵

这个"第一"具体是多少分

1670分是截至10月19日的 Arena 榜单数字:超过 Kimi K3(Max)等开源模型,也超过 Claude Opus 5(High)、Grok 4.7(xHigh)等闭源选项,但在同一张榜单上仍落后头部的 GPT-6 Sol(Max)12分。 真正改变竞争格局的是另一件事:官方首次发布了帕累托前沿曲线,即在这张"性能—成本"图上,暂时没有别的模型能同时做到比它更便宜、得分还更高。智东西知乎·程序员2026

价格表里藏着一个50倍的开关

按百万Token计价:高峰时段缓存未命中的输入2元、输出8元,空闲时段降到1元和4元;一旦输入缓存命中,价格直接掉到0.04元,空闲时0.02元。 对需要反复携带长上下文的 Agent 类任务来说,这个开关决定账单量级。实测也在跟进:一个"开封古城"3D场景加一个网页赛车游戏均一次性生成完成,两单合计花费约6元,画面中人物仍以多边形方块为主,细节有待完善。 "学霸"目前的能力上限大体是这个位置:能低成本把想法变成可交互的东西,离完美的成品还差一步。智东西

另一把刀砍向搜索

过去AI应用的联网搜索大多外包给第三方聚合接口,实测帖的估算,常用第三方服务的价格大约是它的十倍,还要自己处理反爬和正文提取这些脏活。 “DeepSeek对传统搜索的冲击有多大"这个问题下,10月19日的新答案称这"属于降维打击了,毁灭级的”。 社区里"敲响百度搜索的丧钟"式的判断也同步升温。 但要划清边界:按官方公告,搜索接口目前免费、11月1日才开始正式计费,长期质量与并发能力还没有公开数据支撑,"行业变天"目前是待验证的判断,不是已完成的事实。持续降熵知乎小红书

热度是真,吐槽也是真

海外讨论量级不小:截至10月19日12时,X 平台"DeepSeek-V4.1-Flash以低成本提供前沿人工智能能力"话题下的帖子已超过58.2万条。 另一面,10月中旬,针对 V4.1 Flash 容易"陷入雷霆大思考、胡乱多操作导致账单虚高"的第三方优化项目在 B 站拿到20多万播放——省钱工具的热度,反过来印证了 token 消耗的吐槽确实存在。 所以"学霸"最准确的理解是:榜单分数和成本这两个维度上它当下最强,但推理的"草稿纸"纪律和长周期稳定性,还没到无可指摘。接下来值得盯的是两个节点——11月1日搜索接口正式收费后的真实账单,以及 OpenAI、Anthropic 下一轮版本更新后,这个 1670 分守不守得住。智东西哔哩哔哩

内容由AI生成

精选参考来源

1. DeepSeek学霸的降维打击:没刷榜,在工位打游戏,模型能力却控制不住地涨

2. 夯爆,DeepSeek又拿下全球第一

3. 【中信建投:建议关注企业级AI应用、算力服务及国产芯片和超节点】中信建投指出,10月17日,DeepSeek更新V4.1 Flash,DeepSWE由74.2%升至77.0%,API价格不变,并开放搜索与抓取接口。在三方测评中,新版在Pi框架high档位下全部通过隐藏测试,平均每任务费用0.045美元,较同表GPT-5.6 Sol medium档位低77.7%。此外,智谱发布法律专用模型,阶跃披露长程Agent训练方案。国产模型能力、调用成本和工具配套改善,有望推动企业工作流应用与推理需求增长,建议关注企业级AI应用、算力服务及国产芯片和超节点。

4. DeepSeek第一,MiniMax第二,国产Flash双子星杀疯了

5. 不到72小时,DeepSeek和MiniMax双双交卷,Flash集体挑战旗舰

6. 年内第18次宕机,融资千亿的DeepSeek反而更脆弱了?

7. 这次DeepSeekV4.1的后训练算法基本没变。他们发现在当前阶段,对数据和环境流水线进行工程化改进所带来的边际收益,远远高于在后训练算法上追求创新所带来的收益。技术报告里是这么说的:“在本次发布中,我们没有引入新的后训练算法。整体方案遵循标准范式:先进行监督微调(SFT),随后进行强化学习(RL)和同策略蒸馏(On-Policy Distillation,OPD;Gu et al., 2024;Lu and Lab, 2025),在算法层面并未做出超出成熟实践范围的修改。相反,我们几乎将全部精力集中在模型训练所使用的内容,而非模型如何被优化上:我们投入建设大规模、自动化的数据合成与环境构建流水线。具体来说,这套流水线:1. 合成多样化、可验证的训练任务,并同时生成相应的参考答案和奖励信号;2. 以程序化方式构建并扩展交互式智能体环境,使得可以低成本地收集并评估模型的行为轨迹;3. 通过严格的筛选、去重和难度校准,确保数据质量以及课程学习中的难度平衡。我们发现,在采用固定且并无特别之处的优化流程时,系统性地提升合成数据与环境的规模、多样性和可验证性,几乎可以解释我们所观察到的全部性能提升。这一观察也呼应了一个更普遍的经验:在当前阶段,对数据和环境流水线进行工程化改进所带来的边际收益,远远高于在后训练算法上追求创新所带来的收益。”

8. DeepSeek 又甩下一记「便宜又能干」:V4.1-Flash-1017 已上线,权重 MIT 开源。10 月 17 日更新要点(据官方模型卡):· DeepSWE 77.0|Terminal-Bench 4.0:31.2→42.3· 输出更短、任务更快,官方称性能/成本 Pareto 改善· HF / ModelScope 可下权重;API 名 deepseek-flash 不变· 顺带开放 Search & Fetch 搜索 API点评:开源阵营继续卷「同档更便宜」。榜单多为官方自测,落地还得看你的 harness 和验收标准——别只追分,盯任务成本。来源:Hugging Face 网页链接X 话题 网页链接(约 2026-10-17~19)#DeepSeek #人工智能 #开源 #大模型 #AI #科技资讯

0
扫一下,分享更方便,购买更轻松
0评论

当前文章无评论,是时候发表评论了
提示信息

取消
确认
评论举报

最新文章 热门文章