芯片圈一个多年没人愿意戳破的真相,被英伟达自己说出来了:这些年,数据中心CPU绕了远路。
最近,英伟达Vera CPU团队接受科技媒体WCCFTech采访时罕见承认:全行业大转向的"chiplets",长期牺牲了单线程性能和IPC(每时钟执行指令数)。知乎
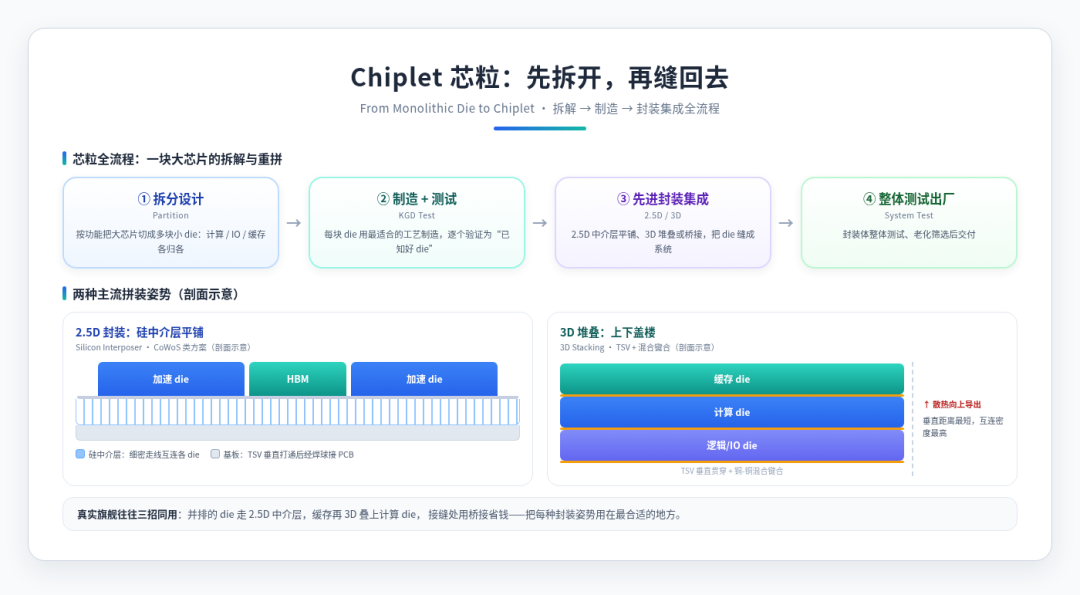
什么是chiplets?就是不把CPU雕在一整块大芯片上,而是拆成几个小芯片,造好后用封装"拼"成一颗。好处直白:良率高、成本低、核心数能像拼乐高一样往上堆。AMD带头,英特尔跟进,全行业转向。
代价也是实打实的。英伟达团队说得很直接:芯片拆成小块后,根本没留出足够空间给每个核心做精细化设计;数据要在小芯片之间来回跑,多一层延迟,内存路径也越来越绕。结果就是:核心数暴涨,单核干活的速度却常年原地踏步。NVIDIA官方博客
单核慢有什么要害?以前真不算大事——云服务、网页,都是并发生意,一个核慢就多上几个核。但智能体AI把规则改了。
AI智能体干活是严格的流水线:执行代码、调用工具、检索信息、分析结果,每一步都得等前一步,根本没有"多核同时开工"的捷径。核心再多,单个任务慢就是慢。更疼的是,CPU磨蹭的时候,旁边的GPU只能干等着空转。堆核心治不了这个病。所以英伟达做了个反行业的决定:新一代数据中心CPU Vera,把88个自研Olympus核心全部塞进一整块单晶粒芯片,不拆。微博知乎
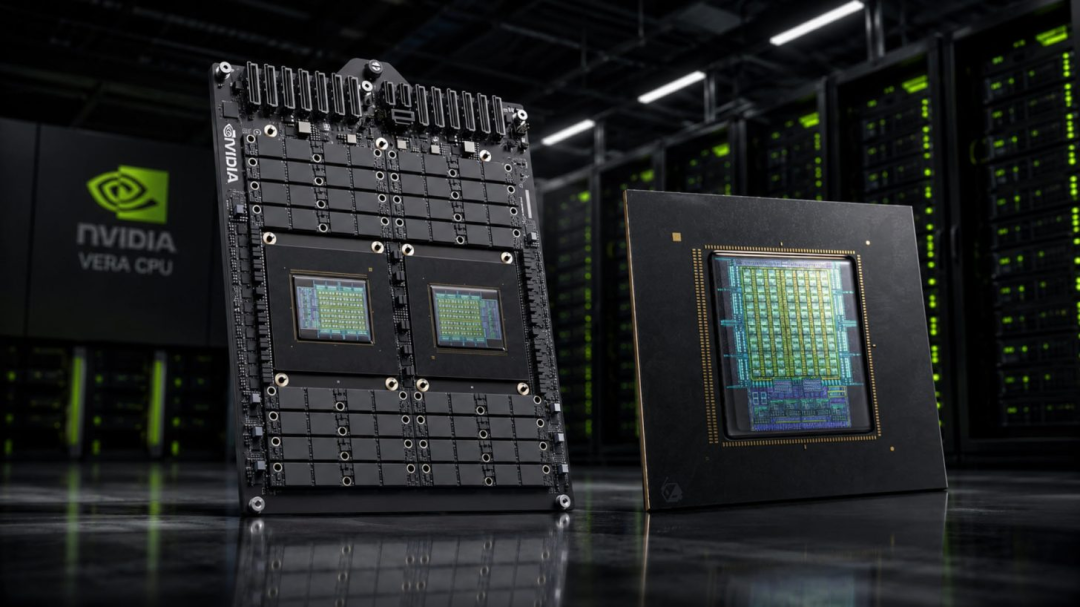
效果呢?按英伟达的说法,持续单核性能是主流x86的1.8倍,智能体编排任务比英特尔Sapphire Rapids快约2.2倍。不拆片,就没有跨片延迟,核心之间数据直通,互联带宽做到3.4 TB/s,约是顶级x86的三倍。说得更技术一点:x86的拆分方案,把一台双路服务器切成最多32个"内存街区",跨街区调用要绕路;Vera是一整块平原。NVIDIA官方博客知乎微博知乎
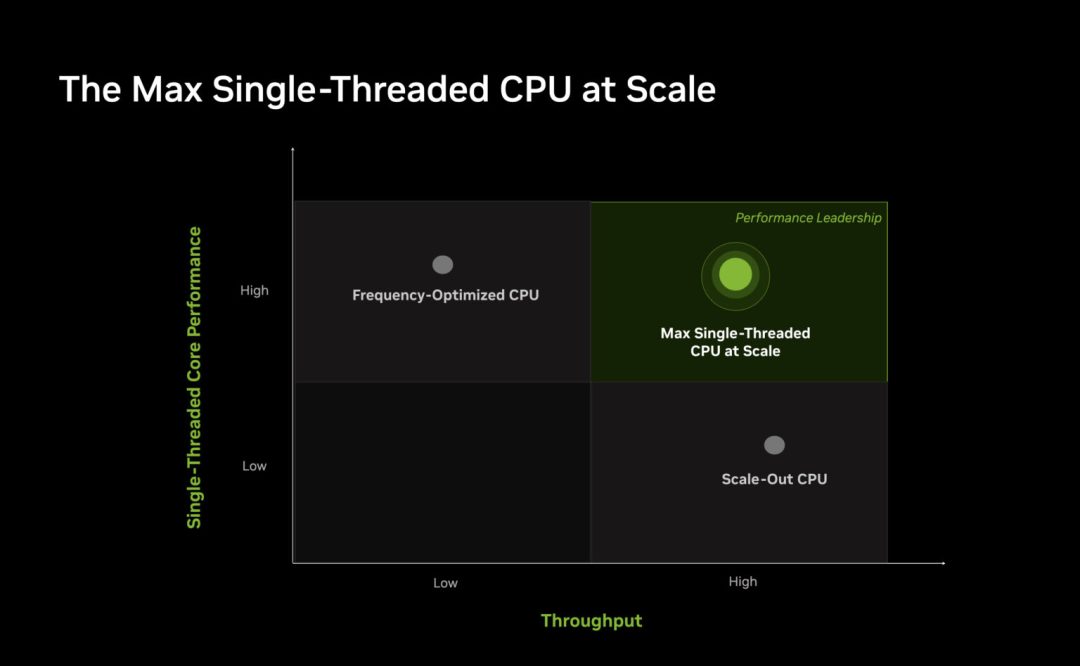
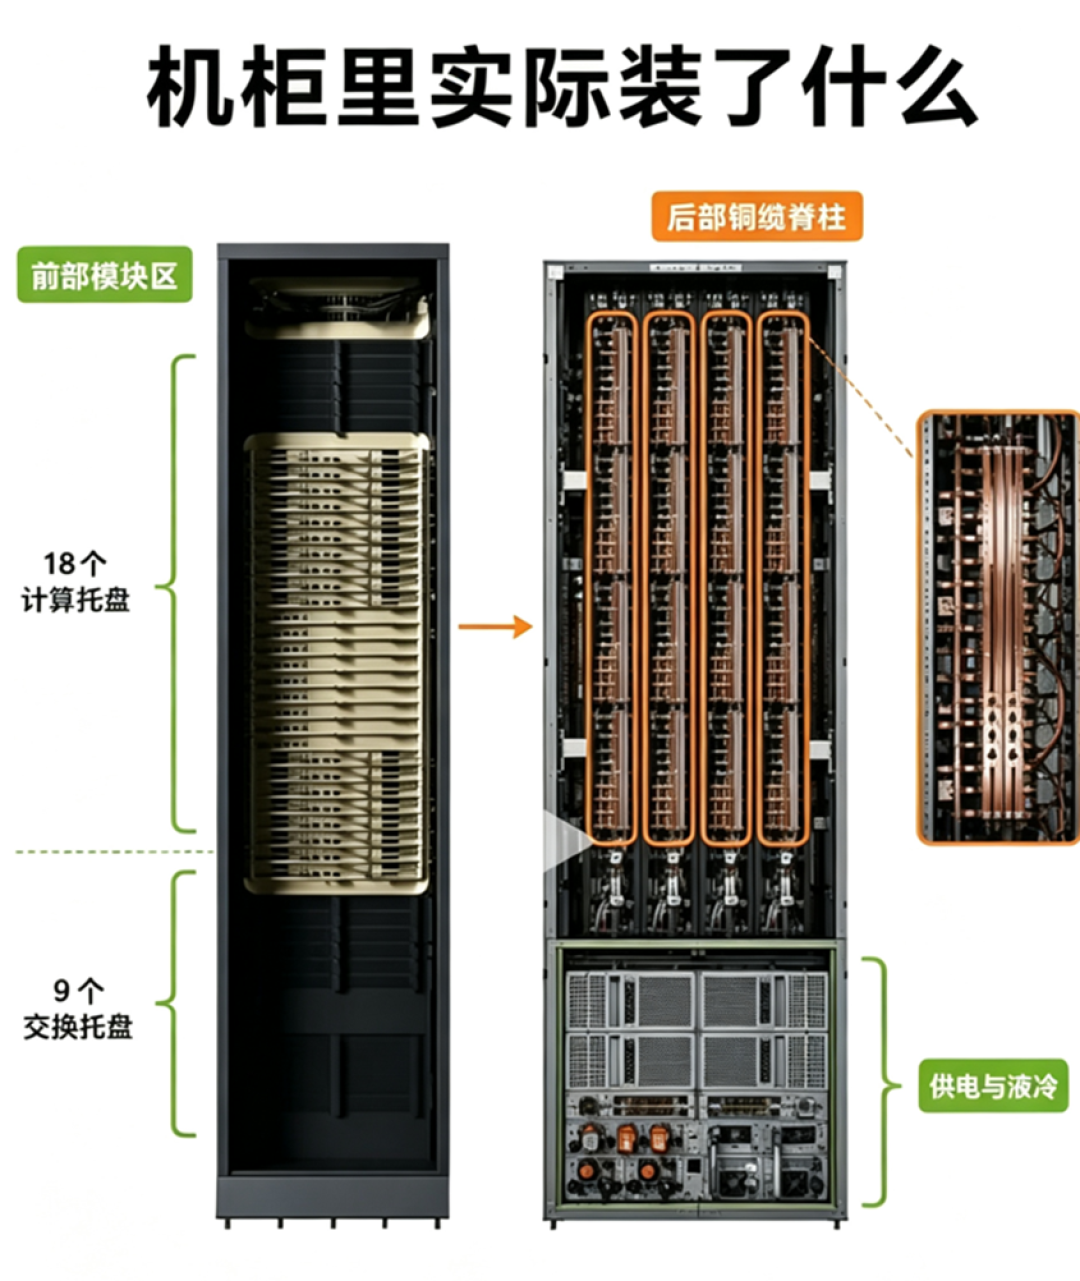
故事还没完。英伟达之前的Grace CPU只是GPU的副驾,这次Vera直接以独立CPU机架出售;数据中心里GPU与CPU的配比,正悄悄从8:1滑向4:1,未来甚至可能走向均衡。AI数据中心的账也在换算法——从"每美元买多少核心",变成"每美元产出多少Token"。CPU从配角,变成了正经赚钱的主角。知乎知乎
平心而论,英伟达没有全盘否定chiplets,合适的场景照样会用。但至少智能体AI这条赛道上,重心已经回到最朴素的问题:单核到底够不够快。
对围观的我们,这是个挺好的启示:技术路线没有高低贵贱,只看谁在为时代买单。堆核心的年代,吞吐量是钱;智能体的年代,速度是钱。而看着英伟达独自走上"复古"路,AMD和英特尔会不会跟?概率不小。