8月下旬,OpenRouter和编程平台OpenCode上突然出现一个叫"Ox-Alpha"的模型。没厂牌、没介绍,上来就干活:终结了DeepSeek在OpenCode长达56天的霸榜,单日Token处理量创下双平台纪录——后来的复盘帖说,是62T。微博
海外开发者圈集体猜谜:这是谁家的娃?
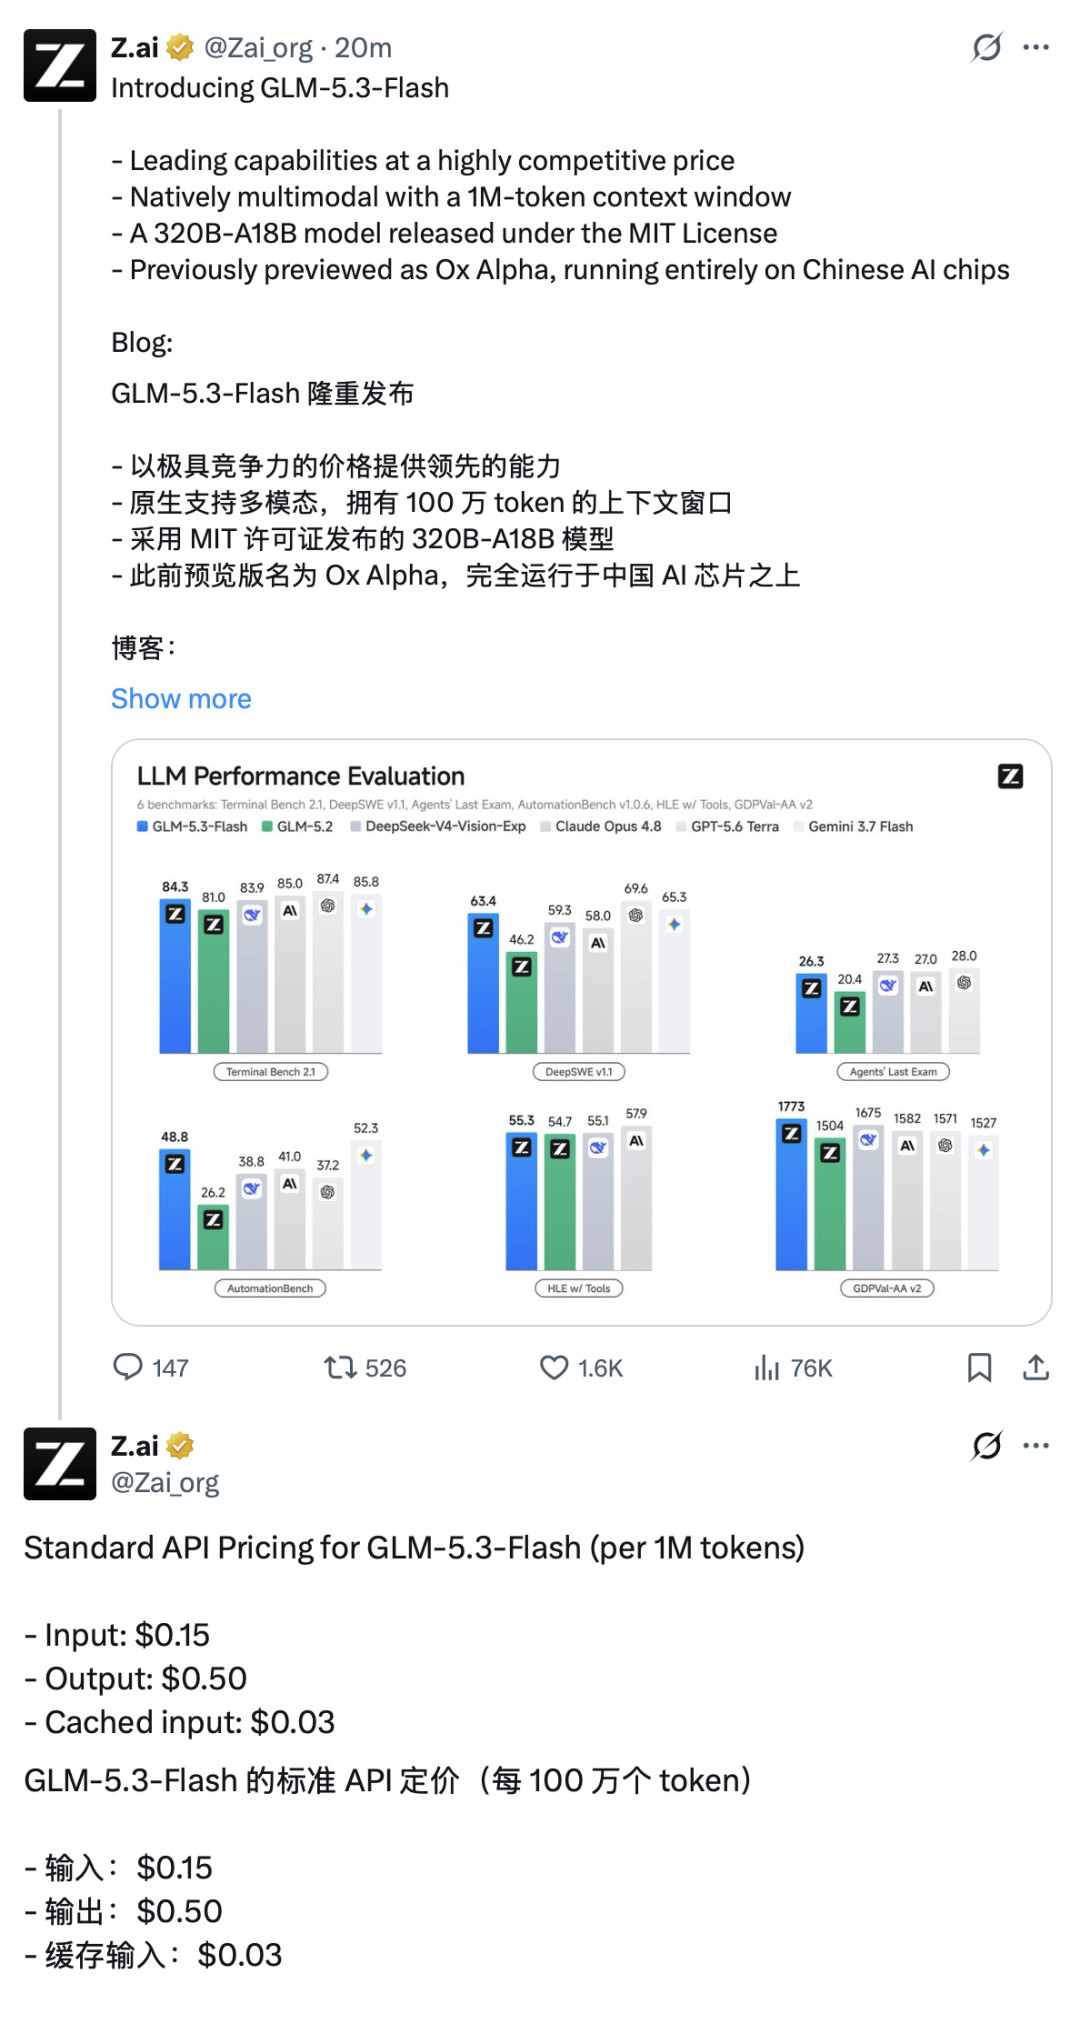
8月26日晚,智谱揭晓答案:我家的,叫GLM-5.3-Flash,顺手就开了源。总参数320B、实际激活只有18B,走的正是"吃得少、干得多"的路线。微博知乎
进Cursor,不是挂个名
10月初,正事来了:Cursor正式上线GLM-5.3和GLM-5.3-Flash。
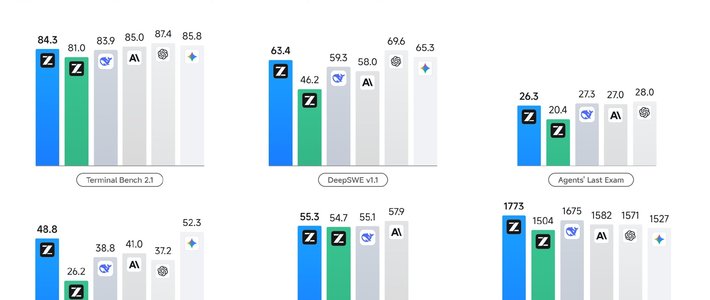
这不是往模型下拉菜单里多塞一个选项那么简单。Cursor官方表示,GLM-5.3在Max推理设置下,于其自家评测CursorBench 4.0中拿到42.6%,是开放权重模型里的最高分。这个评测用的全是真实Cursor场景的任务——多文件修改、重构、排查问题,不是那种靠刷题能刷上去的榜单。知乎微博
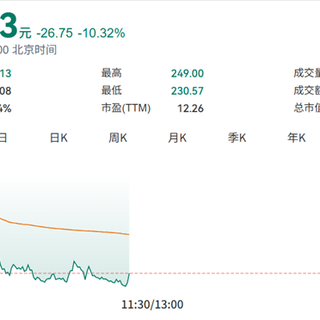
资本的反应比技术圈还快:智谱港股应声涨超5%,高盛把评级从中性上调到买入。随后GLM-5.3又上架AWS Bedrock,按调用量跟智谱分成。要知道,开源模型以前基本没有"被云厂商接进货架当API卖、原作者还能分钱"这条路。财联社微博微博微博
10月20日,分析机构SemiAnalysis又补了一刀:GLM-5.3跟上一代共用基座,这次跃升几乎全部来自后训练。受访者原话——“这对我来说是一个警醒”。微博
翻译得直白点:不用烧几十亿重新学一遍abc,后训练的GPU效率远高于从零预训练。手里有老基座、有数据、有后训练手艺,就能把模型怼到一线水平。这对没钱跟巨头拼预训练的后来者,是一条全新的追赶路径;对靠预训练建护城河的巨头,不是好消息。
对写代码的人,到底能省多少
Wagtail开源框架的核心开发者做了个实验:整个9月,日常开发只用GLM-5.3-Flash。结果认认真真干了半个月活,花了68美元。翻车反而出在自动化上——他挂通宵跑原型的智能体选错了模式,一觉醒来烧掉4.5亿Token、150美元。真正贵的从来不是模型,是人没盯住的那几个小时。知乎
评论区的海外开发者开始晒组合:GLM写方案、Flash干活、DeepSeek做备用。有人趁机退订了美国那两家的订阅,一个月省下几十美元;还有人说,开放权重模型能在自己买得起的硬件上跑起来,这才是大家兴奋的真正原因。
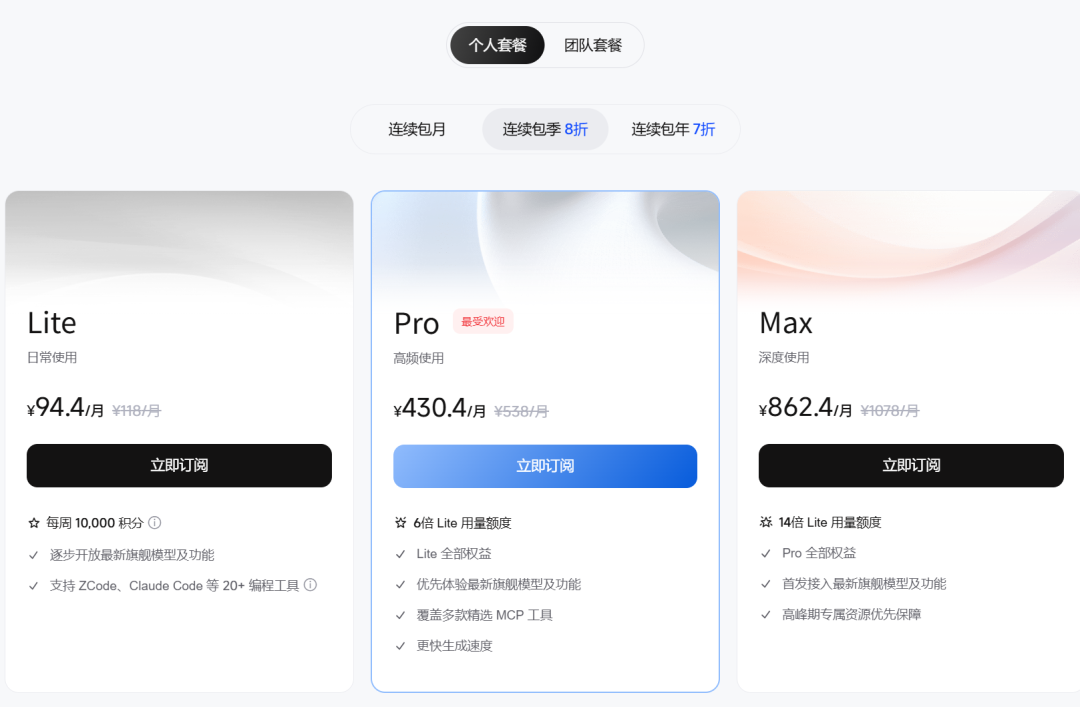
国内的路径更直接:智谱Coding Plan的Lite档118元/月,积分制,GLM-5.3和Flash都支持。百元出头的价格买到一线开源编程能力,搁两年前想都不敢想。知乎
先别急着封神,三盆冷水
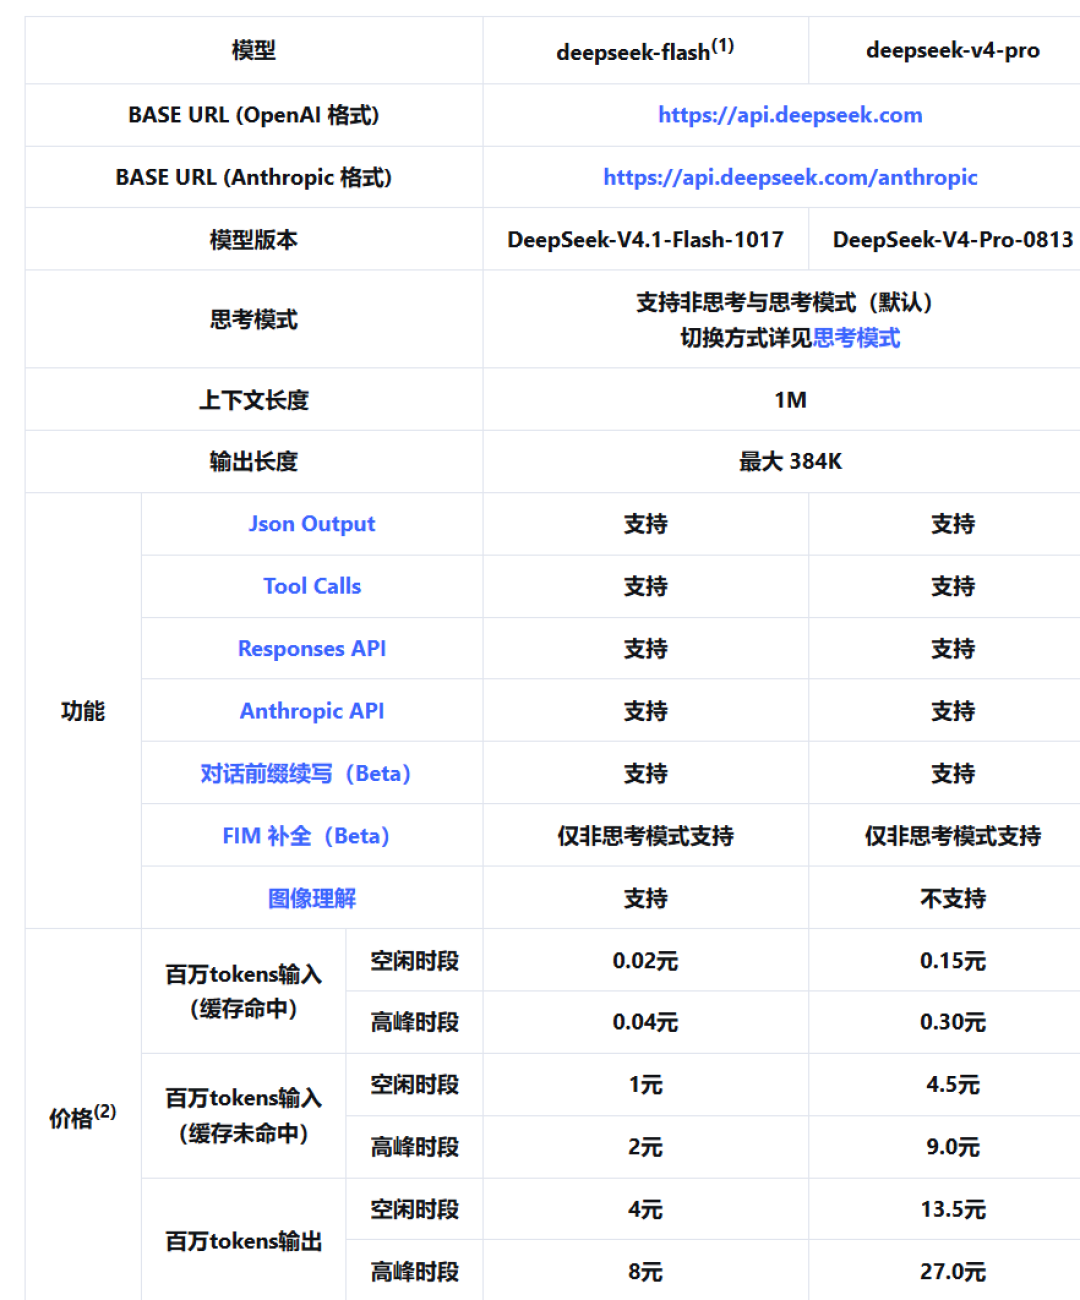
一是榜首坐不稳。10月17日DeepSeek悄悄把V4.1 Flash更新到1017版,网传实测在Terminal-Bench 4.0上反超了GLM-5.3。开源圈现在是混战,榜单按月轮换,今天的最高分就是明天的追赶对象。微博
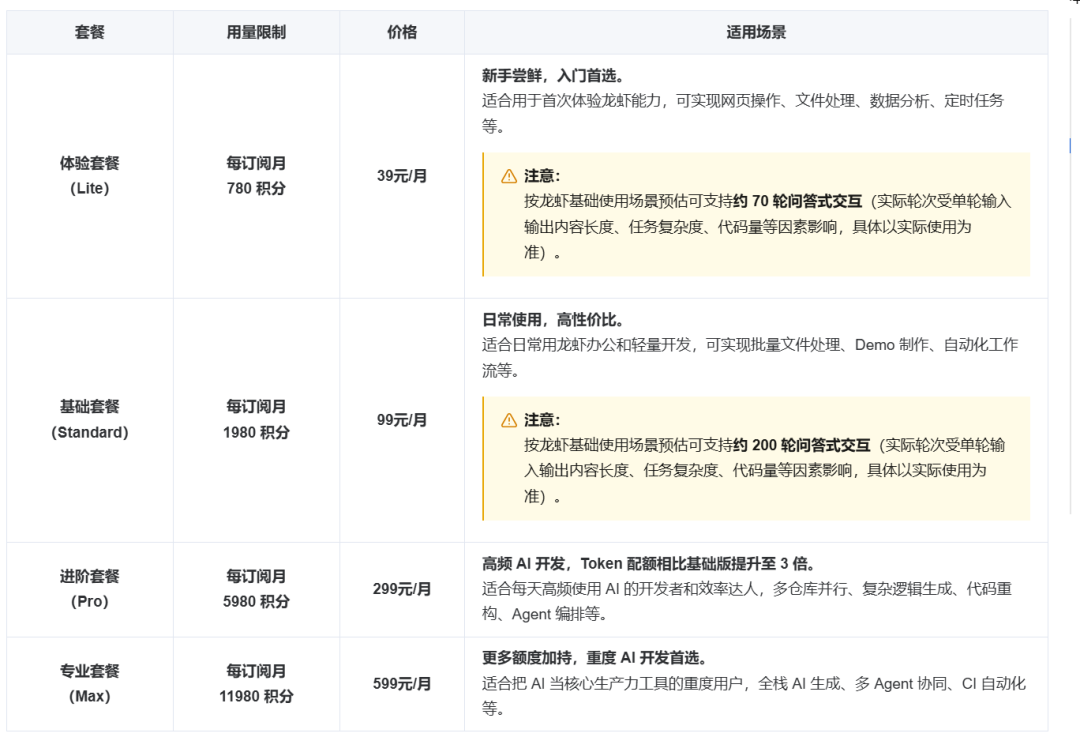
二是积分制的账不好算。长任务跑下来,读文件、调工具、失败重试,背后都是好几轮模型调用,积分消耗远比想象快,重度用户订阅前先算清自己的用量。知乎
三是爆红的代价:Wagtail那位就碰到过高峰期算力顶不住、速度肉眼可见变慢,只能临时切别的模型救急。好在切换也就是改一行配置的事。知乎
说到底,这场混战对打工人是纯利好:以前认真用AI编程,基本等于每月几十美元的订阅起步,用狠了还限速;现在百元出头就有一线选项,还随时能换。省钱是小事,有得选,才是真正的底气。