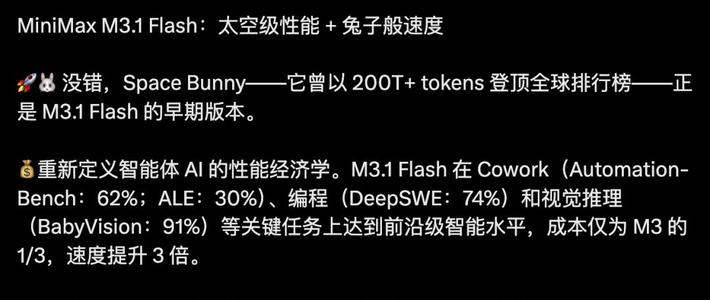
10月19日,MiniMax正式发布M3.1 Flash,并认领了此前匿名霸榜OpenRouter近10天的"太空兔"(Space Bunny)。官方的三大卖点——线上推理速度较上一代M3提升近3倍、使用成本降低70%、每百万Token输入1元——都是白纸黑字。但把发布说明、第三方评测和一批社区实测放在一起看,3倍和70%各有统计口径,默认参数可能让你花得更多,长文本和复杂任务的交付稳定性还没跟上跑分。如果你正考虑把它换进Agent或编码工作流,这份避坑清单比跑分表更值得先看。智东西知乎
3倍提速、70%降本:数字都对,前提要记清
先看官方数字的确切含义。"速度提升近3倍、综合使用成本降低70%"的比较对象是MiniMax自家的上一代M3;70%也被官方限定在智能体任务的整体使用成本,与API单价是两回事,不能拿其中一个直接替代另一个。10月23日权重开源时披露的底座是:总参数4280亿、每个Token激活约230亿参数的MoE架构,配合全模型稀疏注意力、量化感知训练和功耗感知调度三项优化。这就是"快"和"便宜"的来源。知乎智东西
单价层面确实砍到了新低:输入每百万Token 1元、输出4元、缓存读取0.1元,且100万上下文全程同价。作为对照,上一代M3在512K以内输入0.30美元、输出1.20美元,超过512K还要翻倍。也就是说,单价约降一半、长文不加价,再叠加缓存读取0.1元和effort降档,Agent链路的综合成本才真正落下来。智东西知乎
速度则要分清楚口径。官方称典型输出可达每秒200个Token以上、中位数170以上,这是典型场景的口径;第三方机构Artificial Analysis的独立测量为每秒104.7个Token、首Token延迟1.28秒,约是官方数字的一半。OpenRouter免费通道实测中位数更低,只有每秒64到65个左右。免费通道限速排队不能拿来评估付费API,官方的"200+"也要按自己链路的实测修正;而且模型输出快了不等于整件事等比例变快——任务总耗时里还有工具执行、页面加载这些环节,不会因为文字出得快就自动消失。知乎知乎
长文本:1M上下文是真优势,“读得完"不等于"读得稳”
百万上下文敢卖这个价,靠的是架构上的取舍:M3.1 Flash把M3最后保留的三层全注意力也换成稀疏注意力,整个语言模型用动态检索重要历史内容的方式来压低长文推理开销。实测里它有高光时刻:一项实际输入超过10万Token的档案整合测试中,要求跨段选出有效政策并计算多笔订单,正式版两轮的四订单金额、分流和必需证据全部正确。知乎知乎
但坑同样具体。同一题集里,正式版的最终JSON围栏问题仍在,max复杂稿仍常截断,要求严格格式或完整成稿的任务反复翻车。用户端反馈更直观:有开发者晒出用它做论文转文字时反复循环读取两页内容的现场。Trae社区对长期项目的顶帖评价是"前面刚看完后面就忘,最终输出产物错误率差不多一半"。结论是:1M上下文解决的是"装得下",跨段一致性、格式严格性和收尾完整度,仍要你在验收环节自己把关。知乎小红书知乎
复杂任务:跑分贴近旗舰,交付还没跟上
厂商自测的成绩单确实亮眼:软件工程基准DeepSWE v1.1拿到73.7%,只差Claude Opus 5的74.0%零点三个百分点;Automation-Bench在max档62.8%,高于DeepSeek V4.1 Flash 1017的60.5%。但注意,发布时没有技术报告,这些分数均为厂商自测,评测脚手架与样本量未公开。智东西
独立复测给出另一面:同一套七类代码、工具和写作短题、每题两轮的受控测试里,DeepSeek V4.1 Flash 1017交付11/14,M3.1 Flash正式版只有8/14,甚至低于旧预览版的9/14——正式版没有全面补上旧问题。用户案例同样不客气:普通编码任务确实快,但任务一复杂"不仅速度慢,有时候还交付不出解决结果";有人让它清理磁盘,6个多小时最后只交出脚本要求手动执行,同平台另一模型两个多小时就完成了。还有个容易忽略的变量:同一道Three.js题,官方Agent环境58分钟交卷,换到OpenCode跑了4小时33分,差了近4.6倍——执行框架带来的效率差,有时比调模型档位更决定体感。知乎知乎知乎
可靠性上最扎眼的是幻觉口径。第三方AA-Omniscience知识测试里,它的正确率56%,高于同场DeepSeek 1017的43%。而刷屏的"幻觉率93%“不是九成回答都错,指的是它面对不确定的问题时几乎不会说"我不知道”,而是倾向生成一个看起来确定的答案。知乎知乎
翻译成工程规则:批量格式化、可回滚草稿、模板化代码这类高容错环节,尽管用它提速;数据库写入、工单触发、对客回复这类动作,不能把它的输出直接接到任何不可逆的环节上,外挂校验的成本要算进总拥有成本,而不是被每百万Token的低价掩盖。知乎
准备切换前,先把这四个坑绕开
第一,思考常开、默认最高档。effort参数可取low、medium、high、xhigh、max五档,调节思考深度,省略时默认使用max档位。官方文档写明,发送thinking disabled或effort none会直接返回400错误。从别的模型迁移、脚本什么都不改,账单和延迟都可能超预期。务实做法是先用max跑通、量清每一步真实需要,再把字段提取、状态确认这类环节降到low或medium。一道复杂调度题在max档两轮没交付,改成low后,正式版一个独立样本通过了全部13项功能检查。低档不必然更差,但降档前得用自己的任务验证。知乎知乎知乎
第二,模型名和字段要迁移干净。配置里还写着带Preview旧名的,要顺手改掉。思维链走独立的reasoning_content字段返回,官方提醒接入方要容忍该字段偶尔缺失,别把它当稳定字段解析。知乎知乎
第三,管住账单再谈降本。降本公告说的是官方口径,你实际付的是真实Token账单——同一个目标、同样的验收要求,最后完成没有、用了多少Token、中间人工接手几次,这四个数一起看才算数;接入前先设好余额告警和任务级预算上限。
第四,两个"待观察"。开源权重已可下载,开发者除API、订阅产品外还可从Hugging Face、魔搭社区下载模型自行部署。但428B总参数、约23B激活的MoE自部署仍是重资产,硬件投入、运行速度和维护成本都要一起算,“开源"不等于"自部署更省”。官方同时预告了追求更高能力上限的Pro版本,极限推理需求可以先观望。另外,围绕跑分曾有一项未证实的质疑:有研究者对已公开评测题轻微修改条件后,其他模型按新条件作答,它仍输出原题答案;该指控无公开证据、厂商未回应,独立复现之前只宜存疑。智东西
总的判断:M3.1 Flash把"快和便宜"推到了第一梯队——第三方独立评测给出智力指数42至43、每任务成本约0.22美元的成绩,在同月发布的四款模型里成本最低。但"稳"还是它的短板,当高速流水线用、关键环节留人核对,是眼下最合适的打开方式。开发者报告MiniMax Code订阅用户的M3.1 Flash免费额度用到10月25日,之后回归正常计费。先白嫖验证、再决定是否长期接入,试错成本最低。知乎哔哩哔哩