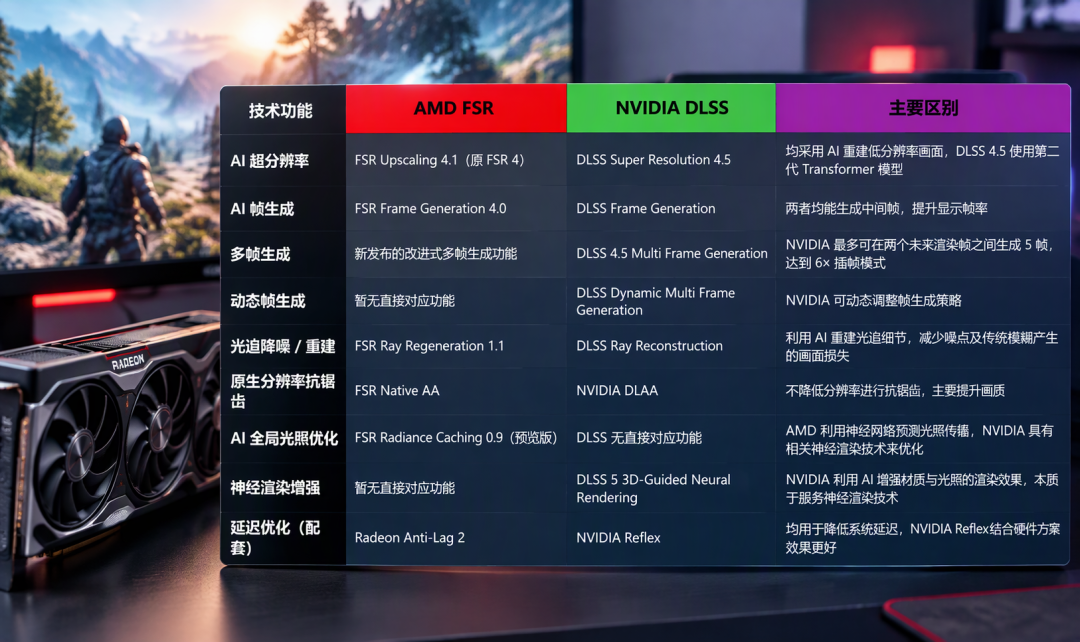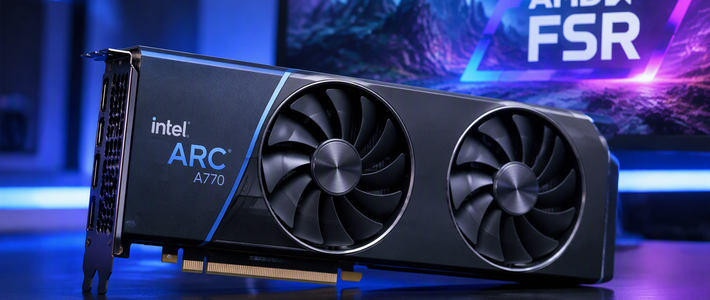
这些年显卡圈的"跨界移植",方向一直是单向的:A饭一边刷B站教程、一边嫌AMD软件慢,然后把英伟达的DLSS往自己A卡上装。但这一周出了件反过来的事——英特尔锐炫的用户,把AMD最新的神经超分模型FSR 4.1.2装进了自家显卡,跑在自己的XMX矩阵核上,测出来的耗时和英特尔自家的XeSS打了个平手。
这回,A饭坐到了围观席。
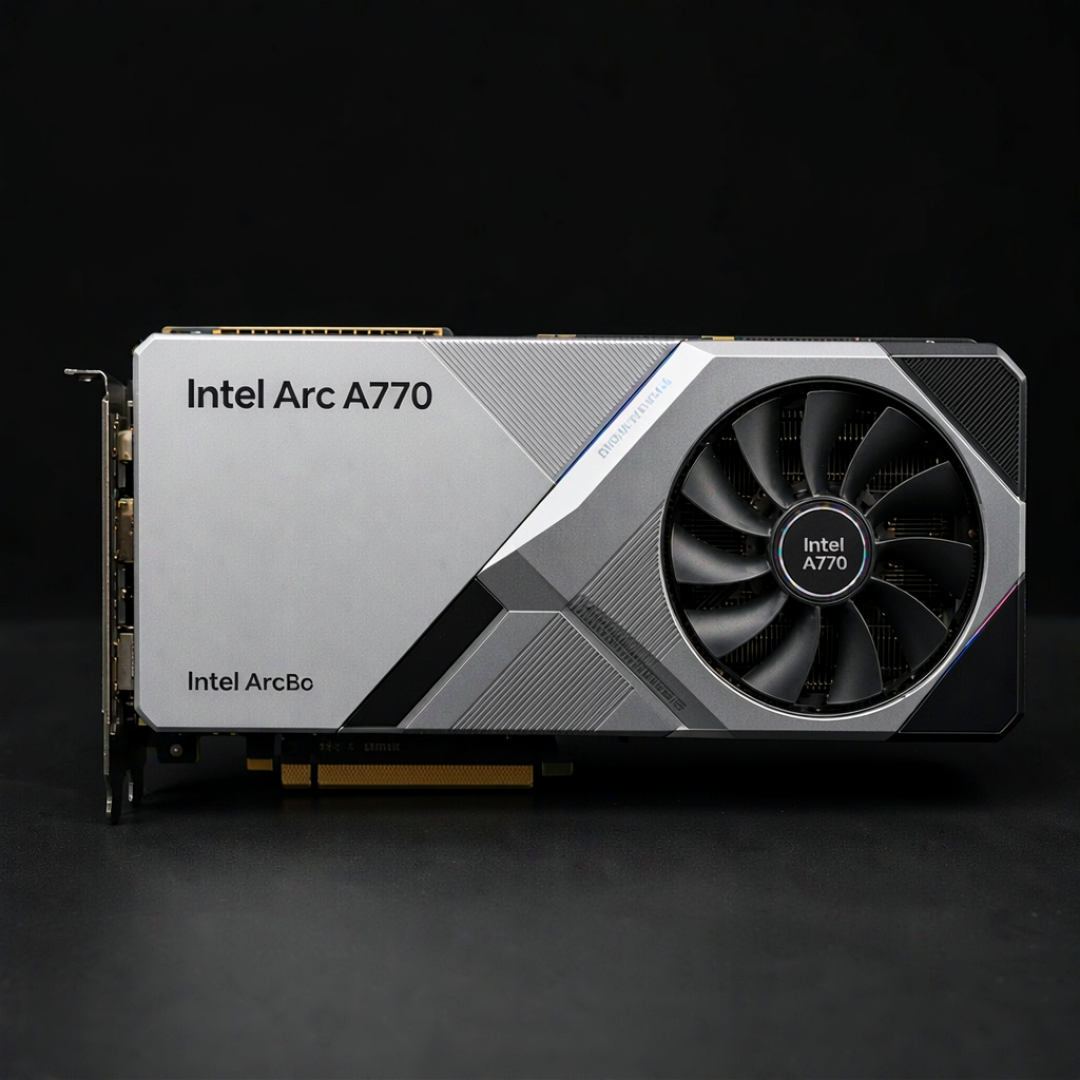
先说事实:社区把FSR 4.1.2搬上了Arc卡,XMX硬件加速,接近原生速度
10月23日,科技媒体Wccftech发布博文,OptiScaler模组社区将AMD最新的FSR 4.1.2神经网络超分辨率模型移植到了Intel Arc显卡,并借助Arc的XMX矩阵加速核心实现硬件加速。 本次非官方移植针对Intel XMX硬件,重点优化了FSR 4的INT8 DLL。 相比靠通用着色器硬跑,XMX加速能明显压低超分耗时,让AMD的AI超分在英特尔平台上更接近原生体验。IT之家知乎知乎
社区公开了两组基准数据,我把它们整理成表(注意:均为非官方社区测试,只在这些具体游戏、具体档位和具体卡上成立)。知乎
显卡 / 游戏 / 档位 | 方案 | 平均帧率 | 超分耗时 |
|---|---|---|---|
Arc A770《巫师3:狂猎》次世代版 1080P 质量档 | 原生XeSS SR | 101.1 FPS | 0.84 毫秒 |
同上 | FSR 4.1.2 Lite(XMX加速) | 101.5 FPS | 0.75 毫秒 |
同上 | FSR 4.1.2(XMX加速) | 98.6 FPS | 1.11 毫秒 |
同上 | FSR 4.0.2(XMX加速) | 98.0 FPS | 1.17 毫秒 |
同上 | FSR 4.0.2 XMX修改版 | 97.2 FPS | 1.18 毫秒 |
Arc B580《光与影:33号远征队》 平衡档 | 原生XeSS SR | — | 0.58 毫秒 |
同上 | FSR 4.1.2 Lite | — | 0.59 毫秒 |
同上 | FSR 4.1.2 | — | 0.85 毫秒 |
同上 | FSR 4.0.2 | — | 0.87 毫秒 |
看点就一句话:Arc B580跑《光与影:33号远征队》平衡档时,FSR 4.1.2 Lite的超分耗时约0.59毫秒,几乎追平原生XeSS SR的0.58毫秒。 “跑别人家的模型跑出比亲儿子还快的成绩”,这句话前几年只属于A饭的幻想,现在在英特尔卡上先成真了。知乎
把时间线拉长:一周之内,超分模型"搬家"了三次
单独看这条新闻是个趣闻,把10月20日到26日摆在一起看,就是一场三方大流窜:
10月20日:AMD正式发布Adrenalin 26.10.1驱动,将最新的FSR 4.1 AI超分辨率技术扩展到了RX 6000系列显卡——从RX 6950 XT到入门的RX 6400都在名单里,原本这个功能要等到2027年初,现在提前了好几个月。 同时获得驱动支持的还有Ryzen AI Max 300/400系列和Ryzen AI 9 300/400系列核显。知乎
10月23日—24日:就是上面这条,OptiScaler社区把FSR 4.1.2移植到Intel Arc并激活XMX加速。
同一窗口:开发者Daniel Blanco更新了DLSS-NR-on-AMD项目,让AMD显卡也能尝试运行英伟达DLSS的一系列技术,包括DLSS 5神经渲染、超分辨率、帧生成以及光线重建。 A卡强开DLSS 5能白嫖几帧、哪张卡不能抄、反作弊红线在哪儿,前面两篇已经拆过账,不重复。
10月24日:《血源诅咒》非官方PC移植分支BloodborneX发布1.0.0,本次更新最核心的技术突破在于原生集成了英伟达最新的DLSS 5神经渲染技术,移动版RTX 3070 Laptop(8GB显存)在开阔场景跑出45到47帧的稳定帧率,176MB整合包已在GitHub开源并附完整源代码。知乎
10月24日—26日:《塞尔达传说:旷野之息》静态重编译移植Savage Wind公布首份基准测试报告,在锐龙5 5600X处理器与蓝宝石Pulse Radeon RX 9060 XT 16GB显卡的组合下,该游戏在4K超高清分辨率下成功实现了最高63 FPS的流畅运行,项目仍处于早期Alpha阶段。 B站则出现了"A卡OptiScaler中文版DLSS-NR-on-AMD 0.8.0+FSR4.1.3+30倍帧生成"的使用教程视频,上传半天播放量破两千、评论区70条全是交作业的。哔哩哔哩
DLSS、FSR、XeSS三家模型,在一周里互相跨过"厂商墙"流窜,搬家的全部是MOD玩家,没有一家厂商是主角。
为什么搬得动?又为什么厂商自己不搬?
搬得动的技术前提很朴素:FSR本来就是开源的模型+SDK,DLSS的神经资产也被社区拆得动;而Arc的XMX、N卡的Tensor Core、RX 9000的RDNA4专用AI加速器,本质上都是矩阵乘加单元,算法天然具备"换个矩阵核重编译"的便携性。社区做的事,就是把FSR 4的INT8模型重新编译到XMX指令上。
厂商不搬,是利益问题不是能力问题:超分是显卡生意所剩不多的体验护城河,“我的模型在你卡上跑得一样快”,等于亲手拆SKU差异化。所以EULA、驱动策略、反作弊一起设卡。社区先一步破防,被挤压的不是某家厂商的利润表,而是"买谁卡就只能用谁超分"这条延续了十年的购买逻辑——护城河从"算法绑定"往回退,退到硬件矩阵算力、驱动与游戏认证、以及官方下放速度(RX 6000吃到FSR 4.1是社区给不了的,这是厂商唯一的优势项)。
三条边界:这事跟谁有关、能走多远
英特尔Arc用户:受益最直接。 带XMX的锐炫卡(A750/A770/B580这类)等于白嫖了一个"XeSS平替",单机游戏里画质党可以拿FSR 4.1.2和XeSS对比着开。但它是非官方移植:没有驱动和游戏更新保障,网游别拿去碰反作弊,把它当尝鲜玩具,别当日常配置。
A饭:情绪价值大于实际收益。 自家技术被对手阵营抢着装、还测出打平原生的成绩,这是AMD软件这边年最扬眉吐气的一刻。RX 6000车主其实用不着折腾MOD——官方26.10.1已经给了FSR 4.1,但记得前面算过的账:以RX 6950 XT为例,1440P分辨率、FSR质量档位,开启FSR 3.1时平均帧率为82.3 FPS,换成FSR 4.1后平均帧率下降到了74.4 FPS,性能损失约为10%,4K下平均性能损失则达到约24%,老卡开新超分是用帧数换画质,不是免费午餐。知乎
N卡用户和双11动手党:影响购买权重,不改变清单。 如果你之前为"DLSS生态更强"支付溢价,这轮移植说明"算法强"和"绑定强"之间差距比营销话术小;双11选卡可以更放心地把权重放在价格、显存和这一轮内存涨价的大环境上。但反过来,也别因为这条新闻去收一张Arc当主力——社区基准是单源、少量游戏、非官方驱动的,证据覆盖到哪儿,结论就只能到哪儿。
接下来盯什么
这篇不做强结论,给四个可验证的观测信号:一是AMD对FSR被"他家用出成绩"的表态——是顺势扩大跨平台授权,还是收紧分发和EULA;二是OptiScaler后续版本会不会把XMX加速推广到更多模型与游戏组合;三是英特尔驱动层对第三方超分是放行还是设卡,以及反作弊厂商何时开始发布警告;四是英伟达如果继续给DLSS 5加密封装,跨界潮的成本会重新抬高,风向可能反转。
一句话收束:这一周测出来的不是技术上限,而是厂商对用户体验的优先级排序——当社区能把别人家的模型跑出接近原生的成绩,"买卡送超分独占"这件事,已经开始从卖点变成历史了。