这周本地推理圈的人,大概率都在说同一个词:Strata。这个把大模型装进你自己电脑的开源工具,18小时里连发三个版本,最炸的消息是:一张12GB显存的游戏显卡,配上64GB内存和普通固态,就能完整跑起DeepSeek V4.1-Flash——数据一个字节都不出本机。哔哩哔哩哔哩哔哩
有人已经给Strata封了"真神"的称号,喊出token自由。另一派直接泼冷水:“家用电脑就别想了”。小红书哔哩哔哩
先别急着装,也别急着换卡。算完三笔账再说。
 Strata三连发版本拆解
第一笔账:239GB的模型,12GB怎么装得下?
不是魔法,是数学。V4.1-Flash是MoE架构:总共24576个专家,每个字只唤醒10个,真正参与计算的参数只有约2%,平均每个字实际只需要搬约4GB数据。Strata把显存、内存、固态做成三层调度仓库,显卡不用干等,还叠加了内存当显存、跳过没用的层、小模型帮忙猜这类工程手段。所以门槛不是"显存有多大",而是"内存够不够、固态快不快"。哔哩哔哩哔哩哔哩
同门小模型Qwen3.8-Flash-Next甚至已经有社区大佬做了Strata硬件计算器:选好显卡+内存+上下文长度,直接告诉你能跑哪档量化——日常聊天Q2_0档8GB显存就能跑,高质量推理IQ3_XXS要32GB以上内存,想追极致上UD-Q4_K_XL最好备64GB内存。小红书
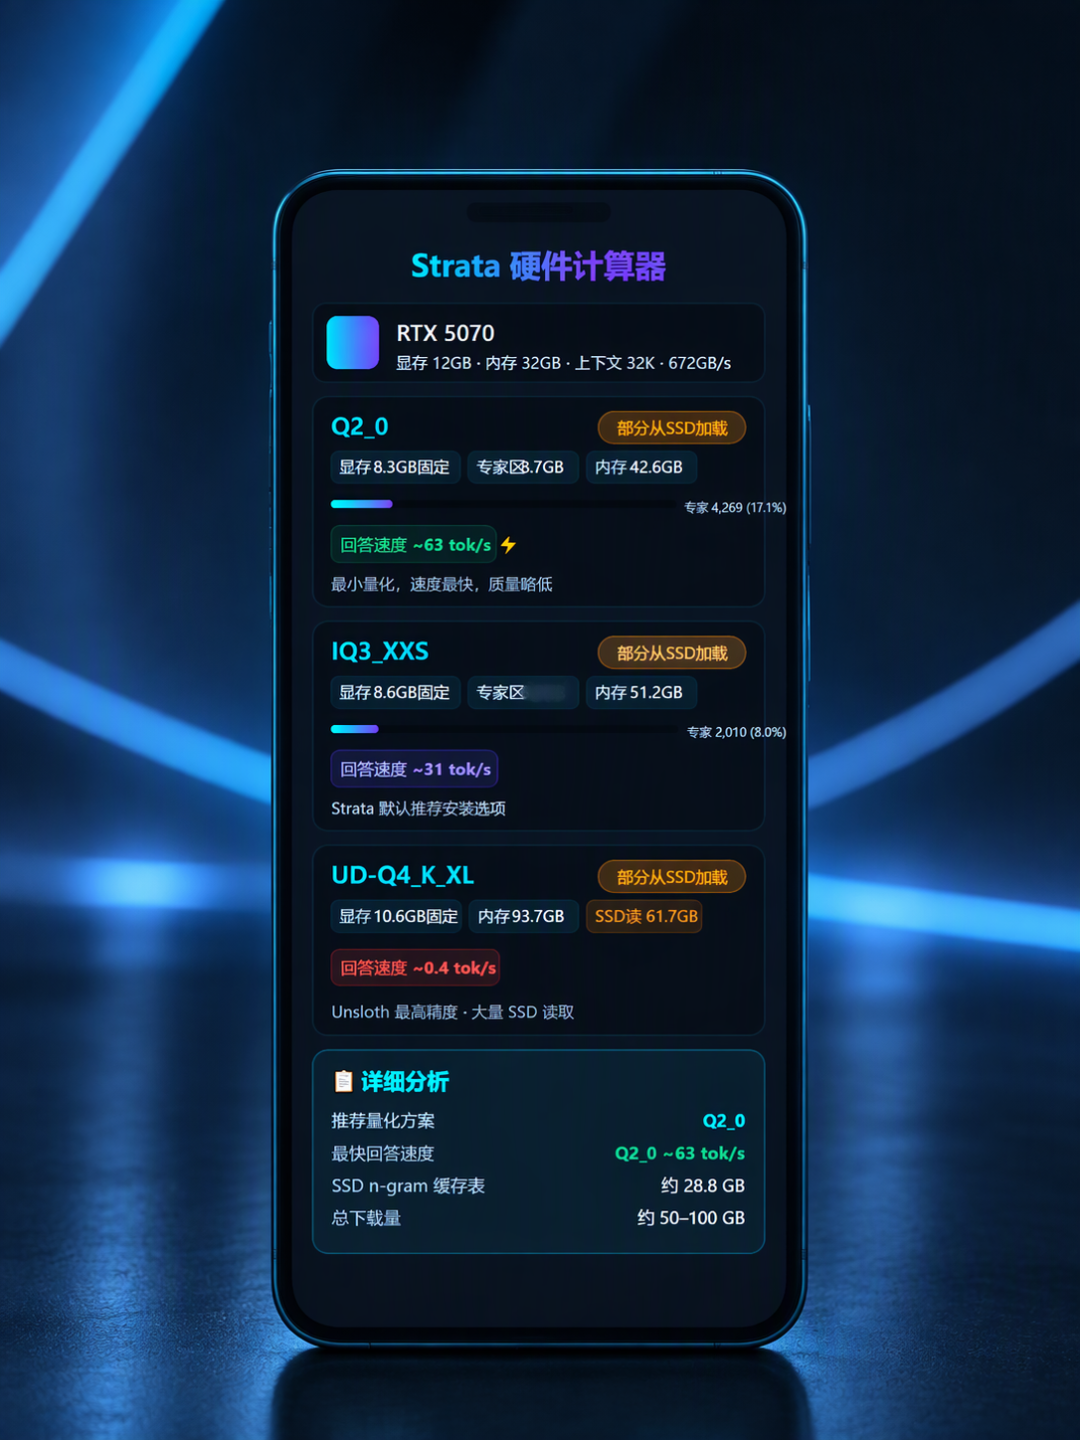 Strata硬件计算器量化档位
第二笔账:到底跑多快?
官方口径的数字相当克制:3060约8-10 tokens/s,5070写代码约5 tokens/s,四张R9700堆到31,开草稿模型(小模型提前猜一串token、大模型批量验收)能上55+。有个反直觉的细节:3060反而比5070快——本地推理撞上的硬限制不是算力,是内存带宽。哔哩哔哩哔哩哔哩
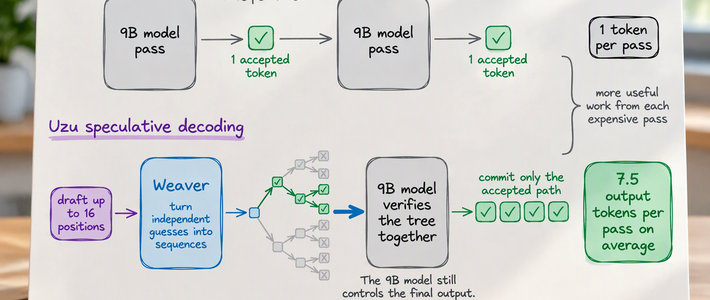
Mac圈刚验证过同一件事:基础款M5 MacBook上,llama.cpp只有22 tokens/s,用树状推测解码的Uzu飙到92 tokens/s。结论先行:本地推理买的是隐私和可控,不是快,它是可用的备选,还不是无感的替代。指望它无痛替代API的,劝你先缓缓。知乎哔哩哔哩
第三笔账:你的"本地",到底是不是本地?
这是这两天爆出来的新坑:有人晒"本地部署DeepSeek v4.1",实际是在用API+DSH套壳冒充。验证其实不难:模型生成时盯着任务管理器,看显存和内存有没有被真实占用、网络流量有没有安静得反常。数据不出本机,才是本地推理一切价值的起点。哔哩哔哩
最后,现在该不该上车?
版本快,也是风险:有人刚撞上安装程序一个字符一个字符读表读崩了的bug,还有硬核玩家复盘自己推倒7B本地推理栈时沉淀出的19个独立的坑。哔哩哔哩知乎
建议拆开看:天天处理敏感资料、长文档重度用户,现在就可以上车;纯尝鲜党可以再等等,评论区已经在传DeepSeek晚点会出一个家用机能直接跑的模型。与其现在硬跑,不如等更顺的那版。哔哩哔哩
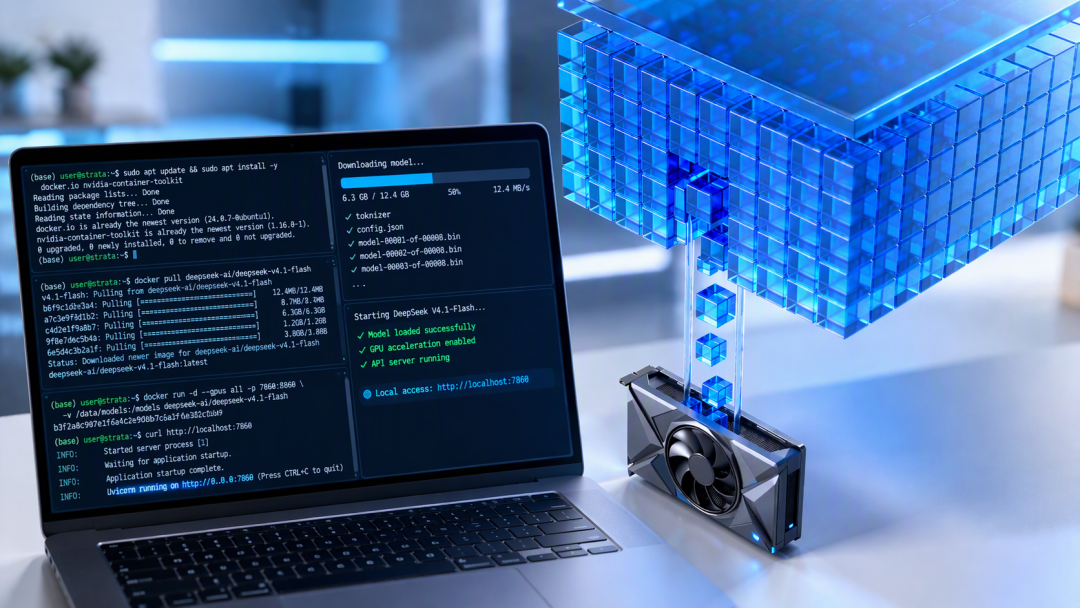 本地推理全流程装机示意
本地推理这玩意儿,以前是极客玩具,现在离生产力只差"算账"这一步。你的电脑跑不跑得动,跑的不是模型,是一个选择。