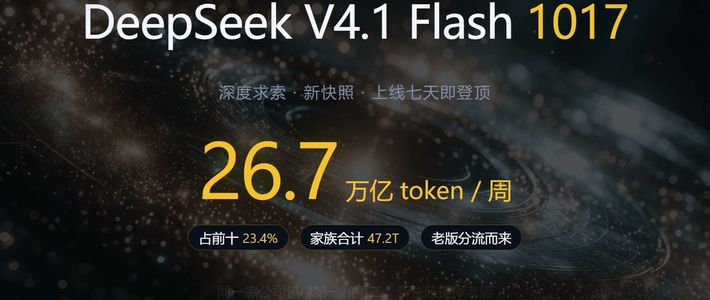
10月26日,OpenRouter公布了10月19日至25日的周度调用量数据:10月17日刚上线的DeepSeek V4.1-Flash-1017以单周处理33.6万亿Token、环比增长801%空降第一,DeepSeek旗下模型已连续三周位居该平台周榜第一,经济日报次日也援引这组数据作了报道。第一财经知乎专栏
但这个“全球第一”的尺子是单一的——一个API聚合平台上流过了多少token,它既不是能力榜,也不是用户人数榜,更不是收入榜。能力这边,Artificial Analysis刚更新的智能指数v5.0上,10月28日发布的Gemini 4 Carbon以59分登顶,Claude Opus 5.5和GPT-6 Astra以58分、57分紧随其后,头部仍是海外前沿模型。 收入那边,OpenRouter按不同任务花费占比统计的另一个榜单里,海外模型依然绝对领先——调用量第一、赚钱第一、能力第一,是三件事。知乎专栏
调用量第一也不等于虚火:33.6万亿Token是开发者用真金白银投出来的,它赢下的是“被使用”。怎么读懂这个第一?先把榜单上的数字拆开。
801%、16%、224%,三个数都对,量的却不是同一件事
801%量的是新版的Token增幅。同一张榜上,第二名也是DeepSeek——旧版V4.1 Flash当周处理18万亿Token、环比下降45%。新升旧降,说明激增里相当一部分是用户跟着10月17日的版本切换迁移而来;何况新版刚发布,拿来环比的基期本来就短,涨幅天然醒目。知乎专栏
16%量的是“被叫了多少次”。OpenRouter按厂商统计文本请求,10月19日起的完整周里DeepSeek请求数比前一周增加16%,份额26.5%,高于谷歌的20.1%和OpenAI的18.5%——使用确实在涨,但远比Token涨幅温和。知乎专栏
224%量的是换了窗口的同一件事。OpenRouter周榜是滚动七日统计:截至10月27日,新版处理37.3万亿Token、较前一个窗口增长224%,仍居第一。窗口移动,增长率就变,用量更高与增速更低可以同时发生,两个数不能互相加减,更不该被读成“降温”。知乎专栏
Token不按人头发,用量榜自带放大机制
先说计量单位。OpenRouter把输入和输出Token一起计入总量,模型变体分开汇总,设为私密的请求不在这组统计里。知乎专栏
这个单位在智能体场景里会被放大:平台自己提醒,不同模型的冗长度和分词方式会影响Token量,这份用量榜不能直接替代准确率、推理能力或收入的比较。一次任务拆成多次请求、长上下文反复读取、试错重试持续消耗,都会把Token堆高——一位公开了自己网关账单的用户测算,缓存读取占单次成本的70%到87%,越是“让模型反复读材料”的用法,Token越多。知乎专栏知乎
再说渠道。OpenRouter是开发者通过统一接口调用各家模型的平台,这张榜统计的是经过它的流量,不是DeepSeek所有渠道的总账——API直连、其他云平台、私有化部署和官方网页、App都不在表内。 在这块阵地上登顶,和在全球市场登顶,是两回事。知乎专栏
能力榜上,DeepSeek到底在哪
综合智能确实不在头部:Artificial Analysis在10月中旬单独实测1017版,智能指数45分,高于GLM-5.3-Flash的41.8,单题评测花费约0.26美元——与57到59分的前沿梯队之间,差距肉眼可见。知乎
但分数的内部结构值得细看。官方更新日志里,它的Terminal-Bench 4.0(终端编程)从31.2涨到42.3,HLE纯文本子集从39.1涨到44.0;只是官方数字用的是自家选择的评测框架,与第三方统一口径的结果不能直接对标。知乎
短板同样具体。AA的知识测试量的是“会不会硬编答案”:在不会答的题里,有多大比例编一个答案出来而不是老实说不知道——旧版V4.1 Flash的这项幻觉率高达96.5%,尽管它的答对率其实高于同档对手。写代码、读文档、跑智能体,事实由工具喂给它,无伤大雅;把它当不联网的知识源,该怕的就是这个数字。知乎
真正解释调用量暴涨的,是“性价比×零迁移”。有作者逐字节比对了新旧两版模型仓库:张量键名、分片归属、总字节数完全一致,架构、参数量、推理代码一个字节没动,只是同一副骨架重新过了一轮后训练;官方API调用方式和价格不变,用户切换没有任何成本。 而同一位网关用户自算的账单显示,同样的工作量,DeepSeek月费1549元、Opus要31149元,差出20倍——省下的不是幻觉率,是预算。知乎专栏知乎专栏知乎
这张榜,普通用户到底怎么用
对行业,这确凿是好消息:全球周调用量前九里中国模型占六席,总量93.54万亿Token、美国近22.5万亿,中国已连续26周超过美国——国产模型真实进入了开发者工作流,性价比这局赢得扎实。但能力冠冕(v5.0榜首57到59分档)和收入冠冕(花费份额)仍在海外手里,只取用量榜会高估格局。第一财经
对选模型的人,“NO.1”其实是三件不同的事,那位翻完自己账单的用户结论很干脆:按能力榜排,DeepSeek已经不是第一;按成本榜排,它也不是最便宜的,但它是最不容易选错的默认选项。 不必因为谁登顶就连夜换掉整套流程:交一件熟悉的活试试结果,编码、智能体、批量文档这类场景它的性价比真实存在;涉及事实准确的任务,要么核验,要么换前沿模型。知乎
最后留一条边界:调用量增长对应了多少完成的任务、多少耗在重复尝试里,平台没有拆账,公开数据也回答不了。下次再看到“暴涨登顶”,先问这把尺子量的是Token、请求次数还是花费——先问尺子,再下结论。