这周用 Claude Code 的朋友,先别急着骂"额度不经用",先看一眼日历。
三件事正好撞在了一起。
第一,官方账号 ClaudeDevs 宣布,Claude Code 周额度 50% 的提升(覆盖 Pro/Max/Team/Enterprise)延长到 8 月 31 日——原本 8 月 19 日就该结束的,同时官方补了一句"希望最终能永久保留,但短期内容量可能仍然紧张"。小红书小红书
第二,8 月 15 日,Anthropic 发了一篇官方博客,专门讲 Claude Code 怎么把会话用出性价比,这两天正在被技术社区密集翻译转述。知乎
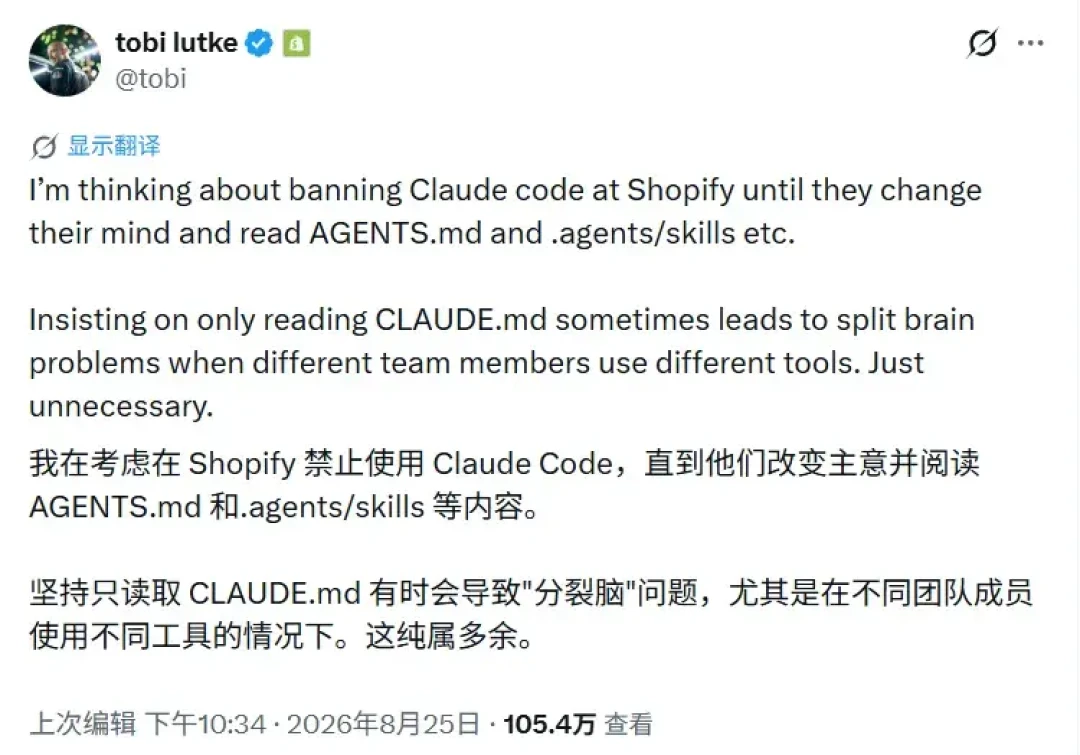
第三,就在今天(8 月 26 日),Shopify CEO Tobi Lütke 公开向 Anthropic 施压:在 Claude Code 支持读取 AGENTS.md 之前,他正考虑在 Shopify 内部禁用它。知乎而 Claude Code 团队的回应被总结为一句话——“坚持 CLAUDE.md,是因为模型系列不能互换”。知乎
表面上三件事互不相干,其实指向同一个事实:AI 编程已经进入"按任务计价"的时代,你的订阅费被每一次请求、每一个被读进上下文的文件、每一行啰嗦的命令输出慢慢吃掉。这篇把官方指南里的成本逻辑和行动清单拆给你,顺手排掉几个已经过时的"省钱技巧"。
先搞懂钱花在哪:同一个任务,为什么有人 5 次请求搞定,有人要 18 次
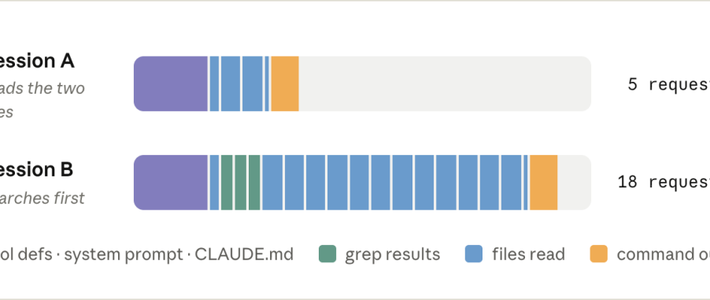
官方blog开头举的例子很扎心:同样是修一个失败的测试,一次会话只读两个文件,5 次请求结束;另一次先全仓库搜索,读了十几个文件,绕到 18 次请求才完事。结果一样,token 消耗完全不同——而且后一种情况下,模型在后续每个回合里,还要反复处理那些早就没用的文件。知乎
差距为什么能这么大?记住三个变量就够了。
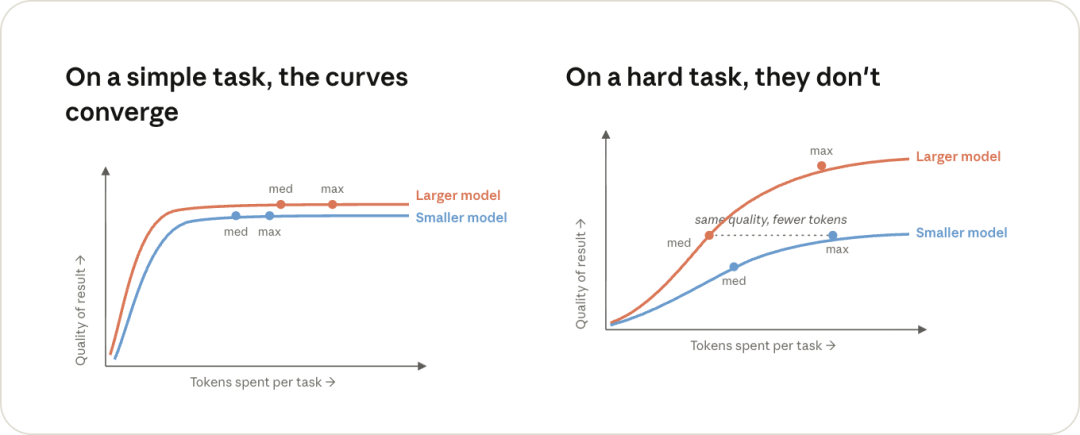
变量一:模型大小。 更大的模型读输入、生成输出都要做更多计算,单价更高。难且模糊的任务上大模型,范围明确的机械活交给小模型——别让最贵的模型长期干重复劳动,也别一刀切换最小。知乎
变量二:输入和输出不是一个价。 一次请求在 GPU 上分两步:prefill 阶段一次性读入全部历史(系统提示词、CLAUDE.md、你的消息、之前读过的文件),decode 阶段再逐字生成回复。逐字生成占 GPU 的时间更长,所以当前 Claude 模型的输出价格大约是输入的 5 倍。知乎更隐蔽的是:模型"心里想"的思考 token,你看不到,照样按输出计费。知乎省钱的本质就六个字:让它少想、少说、少返工。
变量三:缓存。 如果这次请求的开头和服务器刚处理过的完全一致,公共前缀可以按 0.1 倍的缓存读取价复用,Claude Code 自动管理,不用你操心。知乎
真正要防的是打断前缀的操作:会话中途切模型、切 effort、重写对话,都会让后面的内容重新按全价预填充。所以切换的便宜时机是新会话刚开或 /clear 之后,最贵的时机是长对话进行到一半。知乎
还有一个很多人没意识到的事实:每一轮请求,都携带着截至目前的完整对话。Claude 读过的文件、跑命令打出来的输出,会在之后每个回合被重新发送,直到会话结束。知乎缓存让这些重发便宜,但便宜不等于免费——它们占着上下文,让模型每次思考都多处理一遍。"越聊越贵"的机制就在这。
行动清单:今天做、本周做、长期做
官方给了 6 个习惯,社区这两周的实操又补了几刀。知乎知乎按执行成本排个序:
今天就做(5 分钟级)
新任务开工前先 `/clear`。一个长会话的成本,高于把同样工作拆进几个短会话——第 40 个回合还在重新读取前 39 个回合。知乎
会话开局检查 `/model` 和 `/effort`。这两个设置会"记住"上次选择并变成下次的默认值,别等聊到一半才发现自己一直挂着不合适的组合;纯机械活可以 `MAX_THINKING_TOKENS=0 claude` 单次关闭思考(Fable 5 除外)。知乎
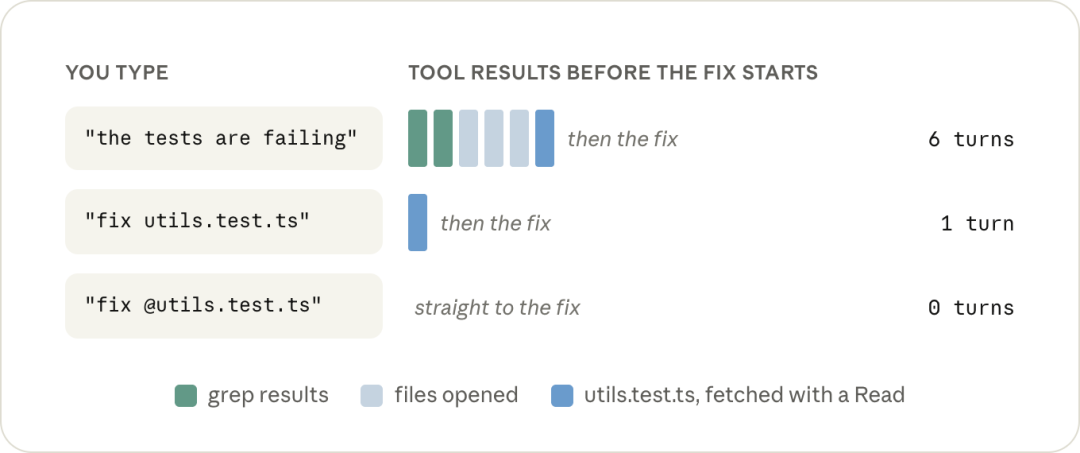
引用文件用 `@`。"修复 @utils.test.ts 里失败的测试"比"测试失败了"能省掉一整轮搜索,连 Read 调用都能跳过。知乎注意同一个文件后续回合再 @ 会附加副本,提一次就够。
本周做(设置级)
给 CLAUDE.md 瘦身。 只留每次都必须的明确指令,特定工作流移进 Skills 按需加载,用不到的 MCP 服务器用 `/mcp` 关掉;在新会话里跑一次 `/context`,看看启动内容占了多大空间。知乎
管住话多的命令。 命令输出会像文件一样追加进对话、全程跟随;超过 30,000 字符的输出会被自动写入文件只留预览(阈值可用 BASH_MAX_OUTPUT_LENGTH 调),但低于阈值的噪音更容易溜进来——测试运行器打 400 行"通过"就是典型。把每天必跑的两三个命令连同静默参数写进 CLAUDE.md,比如"用 npx vitest run
--reporter=dot 跑单测",一次配置,每次会话都能省下一个回合和数百行输出。知乎 回退用 `/rewind`,别急着 `/compact`。 最近几轮跑偏时,/rewind 只截掉对话末尾,前面内容仍能命中缓存;/compact 是重写整段对话,成本高得多。知乎确实要 compact 时,明确告诉 Claude 哪些内容必须保留;用 1M 上下文模型的话,`/autocompact 200k` 可以把自动压缩线设回 200K(需 v2.1.221+)。
长期习惯
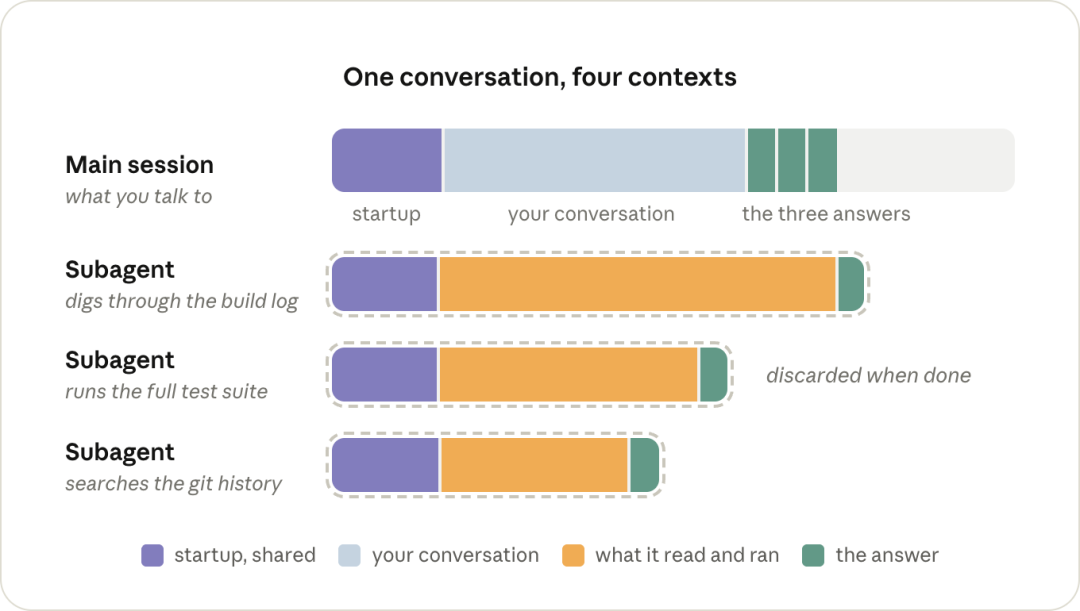
吵闹的大输出任务丢给子 Agent。 比如分析构建日志:子 Agent 有独立上下文,跑完只把答案带回主会话,中间产物不污染你的对话。某类任务要反复委派,可以建专门的子 Agent 定义并指定 model: haiku 或 sonnet;但小任务别这么干,隔离只在产生"大量无需保留的输出"时才划算。知乎
小心 `/loop`。 它每次触发都携带当前完整对话,隔太久还会撞上缓存失效;定时循环放到另一个终端的新会话里跑。知乎
用"时间差"对齐 5 小时窗口。 Claude Code 的订阅额度按 5 小时滚动窗口计:从你发第一条消息开始计时,5 小时后重置,不是整点重置。小红书社区有人把窗口边界和作息对齐:早上花一句话点亮第一个窗口,午休再开一个,下午和晚上两个忙碌时段就各有一个满额窗口可用。知乎也有 Max 5x 用户晒出自己一天挂五六个会话、靠习惯养成再没撞过限额,那条笔记拿了 2400+ 收藏。小红书
养成看 `/usage` 的习惯,额度花在哪,先看得见,才谈得上省。
避坑:有的"省钱技巧",自己先过期了
省钱技巧的传播速度赶不上产品更新速度,三件事需要澄清:
“省 50%”"省 80%"这类固定数字别全信。 实际消耗和模型、上下文长度、工具调用、套餐机制都有关,社区核查的结论是:大部分流传技巧方向有用,但具体百分比普遍没有官方依据。小红书
"聊满 20 句必须换窗口"也是迷信。 该看的不是消息条数,而是前面的内容对当前任务还有没有用;一个主任务配一个主会话,任务明显变了再换。小红书
"避开高峰时段错峰用"这类技巧,用之前先看版本。 它曾经有依据,但官方额度规则一直在调整,同一份核查已经点出,流传技巧里"还有1条已经随着Claude更新而过时"——教程不是错,是过期。小红书
有句话说得准:真正该优化的不是 token 本身,而是有效结果 ÷ token 消耗。官方自己也强调,省 token 的目标不是让模型少干活,而是让算力花在真正需要完成的任务上——这个边界,值得所有"极限压缩"流派记住。知乎
今天这场吵架,其实也关乎你的账单
Shopify CEO 和 Anthropic 这场 AGENTS.md 之争不是小打小闹,Lütke 的原话是:“我正在考虑在Shopify禁用ClaudeCode,直到他们改变主意,愿意读取AGENTS.md、.agents/skills等文件”。36氪
补个背景:AGENTS.md 由 OpenAI 在 2025 年 8 月推出,到当年 12 月,已有超过 6 万个开源项目和智能体框架采用这种格式,Codex、Cursor、Gemini CLI、GitHub Copilot、Jules、VS Code 都已支持,后来这一格式被移交给了 Linux 基金会旗下的 Agentic AI Foundation。36氪
而 Anthropic 这边,Claude Code 团队成员 Thariq 的最新回应是:会提高可定制性,但现阶段你得自己在 CLAUDE.md 里写一行 @AGENTS.md 来导入;理由是不同模型需要的上下文和指令并不完全相同——他们为最新一代 Claude 5 模型删掉了约 80% 的 Claude Code 系统提示词。36氪
去年 8 月就有开发者提过原生支持 AGENTS.md 的 feature request,拿了近 5000 个赞,最后等来的是"不予修复"。36氪
但站在省钱视角,这场架暴露了一个普通用户平时看不见的账:CLAUDE.md 这类指令文件位于请求前缀的最前端,你还没发第一句话,它就已经被加载了,而且每次会话都加载。知乎塞得越满,固定成本越高。更麻烦的是,如果"每种模型配一份专属指令文件"的逻辑成立,项目里就得同时养着 CLAUDE_FABLE_5.md、CLAUDE_OPUS_5.md 一排文件,模型每隔几周更新一次,评测和改写都要真金白银的 token。36氪所以无论标准之争谁赢,你的动作是一样的:今晚把越写越长的 CLAUDE.md 删一遍,只留每次都必要的,剩下的移进 Skills。
分人群判断:谁该现在动手
Pro + 高频用户:最该紧张的就是你。如果现在刚好踩着 +50% 的加量额度在用,9 月一旦回调,同样的用法相当于额度缩水三分之一。上面的清单,本周能执行多少执行多少。
Max 用户:额度缓冲大,不必焦虑,但命令静默、CLAUDE.md 瘦身这些习惯依然值得做——上下文更干净,模型走神的概率也更低,省的不只是钱。
API 按量付费用户:这套成本模型直接对应账单,减少 token 对 API 用户表现为费用下降,对订阅用户表现为额度更耐用,每一项习惯都是即时返现。知乎
想因额度问题换工具的人:社区对比实验确实显示,同一模型放进不同编码框架,token 消耗差距巨大——有对比实验里,同一任务的 token 用量最多差出 30 倍。知乎但这类对比对任务类型和提示方式高度敏感,别拿单次测试当结论。更何况换工具还有账号、网络、迁移的隐性成本。先把省的技巧用尽,再谈换药。
值得继续盯的三件事:8 月 31 日之后周额度基准的官方说法("永久保留"目前只是愿望);AGENTS.md 兼容之争的走向——它可能直接改变 Claude Code 加载上下文的方式;以及你自己 /usage 曲线在调整习惯前后的变化,那是这份清单对你是否有效的唯一证据。