10月27日,谷歌 DeepMind 发布了世界模型系列的第四代产品 Genie 4,它第一次把音频生成做进了实时交互模拟:环境声、类似音乐的声效、能回应用户输入的人物对话,都随画面同步生成。谷歌 CEO 皮查伊亲自站台,称这是「谷歌迄今最逼真、最具互动性的世界模型」。知乎微博
一句话回答标题里的问题:Genie4 能「脑补」现实,不是因为它把画面做得更像照片,而是它换掉了生产方式——不再生成一段给你看的视频,而是持续预测一个供你走进去的世界的下一个状态。声音、物理、进环的「导演」,都是为这件事服务的;这次发布的所有短板,也恰恰来自同一件事。
它不是渲染视频,是预测世界
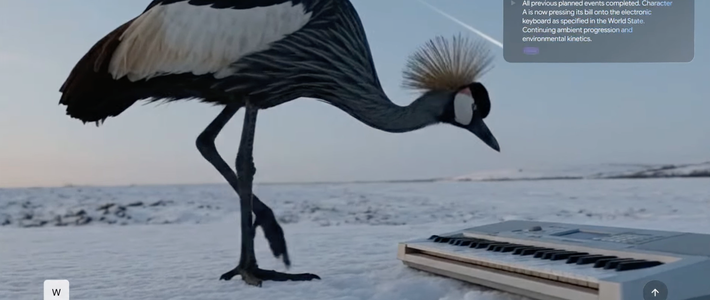
理解机制,第一步是把 Genie4 和文生视频模型区分开。视频模型吃一段提示词,一次性吐出一部成片,中途不能停、不能改;Genie4 给的是一段边玩边长的世界——你按住 W 键往前走,画面就跟着你实时生成,演示里的每一帧都不是预先渲好的。DeepMind 研究副总裁 Raia Hadsell 把分工讲得很直白:语言模型处理知识和语言,世界模型面对的是一个具体环境,既得记住世界此刻的样子,还得算出物体碰撞在一起、你迈出一步以后,世界会怎么变化。「记住 + 算出下一步」,就是脑补的技术定义:镜头里没有出现过的部分不存在任何素材,全靠模型按它对世界运转规律的理解现场补出来。知乎
交互能力的代差也在这里。去年 8 月的 Genie3 第一次做到逼真、3D、实时;今年 1 月上线的试玩网站 Project Genie,单次体验最长只有 60 秒,基本只能走走跳跳。Genie4 则允许你在模拟运行的过程中直接输入提示词修改场景:换天气、加角色、挪镜头,不用停下重来。连续互动时长最长约两分钟,是上一代的两倍。知乎微博知乎
三层支撑:底座、物理直觉和进环的导演
Genie4 的底座是谷歌视频大模型 Gemini Omni,画面和声音由同一个模型一起生成。现实世界的视频本来就带着同步的声音,模型学到的就是一个有声的世界,所以它脑补场景时,声音是跟着一起补出来的。官方演示里,骑着巨龙掠过山谷,耳边是振翅声和呼啸的风声;输入「站务员提醒乘客」,80 年代车站的制服站务员走到镜头前,开口提醒小心站台边缘。知乎微博
物理直觉决定脑补像不像真世界。花园石台上摆着西瓜,输入「把一尊沉重的白色大理石像砸到西瓜上」,石像落下、西瓜当场炸开,红瓤和碎皮溅出石台。碰撞、空气动力学等物理表现和人物动作的拟真度,也被认为比前代有肉眼可见的提升。知乎微博
最关键的一层是导演进环。为了保证实时性,DeepMind 选择 Gemini 3.8 Flash 当导演:Genie4 生成画面的同时,Gemini 一直在观察、把目标拆成小步骤、确认每一步有没有完成,你中途插手就当场修改计划,演示界面右上角的「推理步骤」面板就是它实时列出的计划。用官方材料的话说,这是一个在循环中的引导智能体,持续观察生成画面、拆解任务、检查执行情况,并动态调整后续模拟。知乎微博
谷歌还用此前发布的 Gemini 4 Argon 测试了更难的长任务:Argon 把「下一盘西洋跳棋」拆解成 20 多步文字指令,Genie4 生成画面,人形机器人隔着桌子和真人对弈,伸手、捏住棋子、落子。知乎
脑补的反面:它记住的是画面,不是事实
Genie4 的强和弱来自同一个机制。它靠逐帧预测维持世界,而不是像游戏引擎那样维护一份世界状态账本:镜头移开之后,模型「记得」的是一幅画面而不是一组事实,镜头转回来,它还得重新脑补一遍。这一代世界模型已经能让你走进一个场景并即时改变它,但还不能替你记住那个场景。知乎
官方没有回避这一点。DeepMind 在公告里坦言:细节和物体永久性会随时间漂移,模拟跑久了,或者你反复用提示词改场景之后,你走出去的那个房间,回来可能就不是原来那个了。发布当天 Hacker News 上 650 多分、约 400 条评论的讨论,最集中的也不是像不像真的,而是演示里那些前后不一致:骑龙飞行时镜头转回,城堡旁多出一座原本不存在的城堡;火车站的旅客走过镜头后换了模样;香港摩托车后座的人先是没戴头盔,回画后戴上了。微博知乎
连 DeepMind 自己的访谈都小小的翻了个车:在生成出的餐厅后厨里,两个长得一模一样的厨师并排站着,嘉宾当场接话,让主持人转个身「还能再冒出三个」。DeepMind 研究总监 Tejas Kulkarni 说得更直接:要让虚拟世界完全保持一致,即使仅维持两分钟,也需要模型真正理解日常世界的物理规律——两分钟能做到的事情终究有限。还有一点容易被忽略:这次发布没有公开分辨率、帧率、延迟、基准测试这类可量化数字,连价格都没标,好与不好暂时只能对着官方 demo 和定性描述判断。知乎知乎微博
「最强」的边界,和谷歌的补课计划
所以「最强」要拆开看。400 多条评论的争论背后其实是评价标准之争:如果标准是「让人相信这是一段真实影像」,它今天已经很强;如果标准是「在镜头之外维持一个自洽的物理世界」,它还差得远。谷歌自己给出的下一步,正对着这个缺口:计划中的「混合世界模型」要让代码和像素合体——现在最强的编程模型已经能写出一整个 3D 游戏,DeepMind 打算让代码在后台记住世界状态,像素负责那些说来就来的变化。真到那一步,「脑补」才算有了记忆兜底。知乎知乎
现在能拿来干什么,你能不能玩到
先把状态说清:Genie4 目前是研究预览版,不是已经上线的产品,只向一小批受信任的测试者开放。接入路径上,官方称它很快会上线 Project Genie 并优先面向 AI Ultra 会员,Gemini API 和 Google AI Studio 的早期合作伙伴也能用上——这是 Genie 系列第一次开放 API;据报道上线时间是未来几周,具体日期没有公布。微博知乎
用途方向要按官方口径来读:列出的是测试者正在试的方向,反馈来自受信任测试者的有限样本,不是已经验证的成熟能力——电影创作者把它当「草稿模式」,实时换机位、灯光、台词跑几遍「拍摄」;游戏开发者在写引擎代码之前先试美术风格和交互。机器人训练数据是另一个主要方向:谷歌 AI Studio 产品负责人 Logan Kilpatrick 描述过真实实验室里的繁琐——摆姿势、调试、暂停、重来,一遍遍像拍电影;同样的场景放进 Genie4 模拟,快得多,也便宜得多。知乎知乎
但同一套演示,换个场景容错标准完全不同:在草稿阶段,多出一座城堡只是废掉这一条,重跑一遍就是;在新闻现场或工业仿真里,同样的错误就是结论错误。知乎
值得留意的还有一个细节:官方为 Genie4 生成的所有视频和音频都带 SynthID 水印,让产出可被识别为 AI 生成。知乎
把这轮发布从头看到尾,Genie4 真正的进步不是「画面更真」,而是「脑补」成了一个可玩的循环:一句话搭台子,键盘推进剧情,声音补齐世界,Gemini 把握方向,物理给出后果。而镜头转回去多出来的那座城堡也在提醒:世界模型刚攻下「镜头内的世界」,「镜头外的世界」仍在路上。之后再看同类演示,用一个简单的办法就够了——找一段镜头移开又转回来的视频,出画的物件回画时还是不是原来那个,就是 AI 到底有没有「理解」世界的现成标尺。