11月3日下午,DeepSeek在两个多小时内连续中断两次。官方状态页记录,16时58分起网页与API服务部分中断,对话、V4 Pro、V4.1 Flash三条服务线同时受影响,聊天界面反复弹出"服务器繁忙,请稍后重试"。经修复一度恢复后,18时25分官网再次公告部分中断,最新状态为已实施修复、正在监控,但截至发稿,V4 Pro与V4.1 Flash的API及对话服务仍未完全恢复正常。第一财经华尔街见闻
反复崩掉的原因,不是某台机器出了偶然故障。据媒体统计,这次已是DeepSeek年内至少第19次大面积异常,且10月以来呈密集态势:10月2日中断约2小时,10月12日单日两次故障,10月15日大规模中断近三小时。把这条时间线拉长看,真正的答案是三重错配:token需求正以倍数增长,芯片、服务器和电力却只能以年为单位扩容,而DeepSeek的极致低价策略又把天量流量进一步压到一套弹性有限的集群上。华尔街见闻
需求先爆掉了:token正在吃掉算力
中国日均token调用量已从2024年的1000亿狂飙至500万亿,涨了三个数量级以上。聚合平台上的竞争更加直观:10月19日至25日当周,全球大模型总调用量188万亿token,DeepSeek刚上线一周的V4.1-Flash-1017单周调用量33.6万亿token,环比增长801%,空降榜首。需要说明,这类平台只统计经由其路由的流量,不等于全貌,但趋势足够尖锐——中国模型已连续26周在该平台周调用量上超过美国。中国新闻网第一财经
DeepSeek自己披露的账本更大。10月20日其开源推理框架时,技术报告给出了一个此前从未公开的自报数字:单一集群每天服务155万亿token。这一数据至今没有第三方在统一硬件、模型与流量条件下复现过,只能当量级参考。更要命的是增量结构:11月1日DeepSeek开源Super-agent架构,让AI给AI派活,一次智能体任务背后是几十上百次模型调用。知乎36氪
还有一个反直觉的机制:省算力不等于少用算力。DeepInfer报告披露的96%输入缓存命中率,让大量重复计算根本不用重做,token边际成本越降,被激发的用量就越大——经济学里的杰文斯悖论正在大模型行业重演。36氪
服务器的真相:同样的钱,买不到同样的卡
用户看到的是"崩",DeepSeek看到的是"贵"。10月30日外媒The Information披露,DeepSeek最新一轮融资扩大至1055亿元人民币,投后估值6155亿元,投资方近30家,覆盖宁德时代、中国移动、长鑫存储、中芯国际、vivo、美的、立讯精密、吉利、美团、小红书等。36氪
这轮融资的起点本不是这个数。据The Information被广泛转述的另一处细节,最初目标为500亿元,过程中直接翻倍,原因之一是高端芯片采购成本上涨:一台搭载八颗B300的服务器报价从1500万元涨到约1900万元,涨幅约26.7%。报道还称这一报价是同类机器在大多数国家售价的五倍多——不过该比价未披露配置口径,只能作参考。翻译过来就是:原本预算的卡价涨到不够用,只能把融资规模翻倍。知乎
涨价的不只是卡。供给缺口是整条链的:据央视财经报道,2026年国产AI芯片需求规模约400万颗,实际交付约300万颗,存在百万级产能缺口,部分智算中心在手订单已排到三年后。内存同样在收紧:行业测算显示2026年一季度服务器DRAM合同价单季上涨约九成,而一台八卡GPU服务器的内存容量是普通服务器的几十倍。至于英伟达高端卡,本就买不到——研究机构EpochAI统计显示,截至2025年中,美国约占全球GPU集群算力的四分之三,中国约占15%,国产替代成为现实路径:梁文锋在今年7月的内部会议上直言,国产芯片硬件和生态都不存在问题,唯一的问题是产能不够。中国新闻网36氪
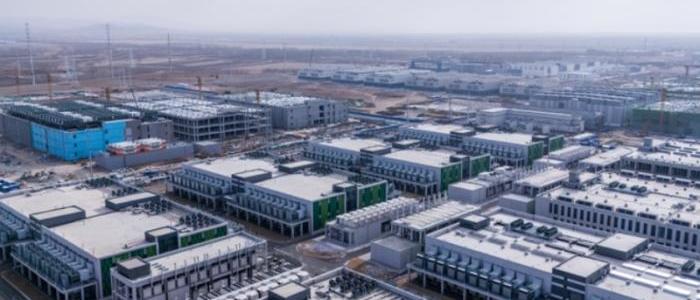
最后一道闸门是电。国家能源局10月底预计,"十五五"时期全国算力用电量年均新增1000亿千瓦时以上,到2030年达8000亿千瓦时,约占全社会用电量6%;截至9月底,我国智能算力规模2592EFLOPS,同比增长146%。所以服务器的真相不是"多买机器"四个字:训练与推理集群是算、存、连、管、供五位一体的工业系统,机柜功率上百千瓦必须液冷,枢纽节点扩容以年计,而token需求以月计。乌兰察布们正在补课——截至10月已累计签约算力中心项目109个、机架规模超700万架,但远水解不了当下的近渴。中国新闻网
为什么偏偏总是DeepSeek
把三重错配收敛到一家公司头上,是因为它自己主动站在了浪头最前面。第一,它是中国AI流量的最大公约数:免费加低价,用户拿它改文章、写代码、写论文,调用量连续数周登顶OpenRouter,任何一波需求洪峰第一个拍到的就是它的集群。第二,它骨子里是"小集群办大事"的路线——当年用2048张卡、约560万美元就训出了V3,效率惊人,但冗余余温也薄,没有为突发流量预留的缓冲。第三,大模型服务有个放大器:界面一提示"服务器繁忙",成千上万用户的重复刷新和自动重试会形成"重试风暴",把本已饱和的集群瞬间推得更深——11月3日一天之内修复后又二次中断,正是这种踩踏的典型形态。华尔街见闻援引分析人士的说法点破了本质:频繁中断的核心症结在于算力供需严重失衡。36氪华尔街见闻
对普通用户和开发者,意味着什么
把"DeepSeek又崩了"当笑话看,会错过它真正值钱的部分:它把整个国产算力供给的缺口,用宕机的形式提前暴露了出来。对重度用户和开发者,直接的行动是别把生产流程押在单一模型上——备用模型、退避重试(失败后间隔递增再试,而非疯狂刷新)是当下最便宜也最有效的稳定性方案;对企业,模型API的价格优势需要和可用性放在一起算总账。
接下来值得盯三个信号:一是1055亿资金到位后,扩容能否让宕机频率从"每周见"降下来,注意卡价、交付周期和国产芯片适配都会拖慢兑现速度;二是国产算力能否从"能用"真正跨到"好用",寒武纪、摩尔线程、壁仞等厂商营收的爆发式增长已经在验证需求侧;三是"算电协同"这类制度性供给能否接住年均上千亿度的算力用电增量。只要token增速继续跑赢基建增速,热搜上的"DeepSeek又崩了"就不会是最后一次——每一次宕机,都是中国算力体系在被使用强度提前体检。