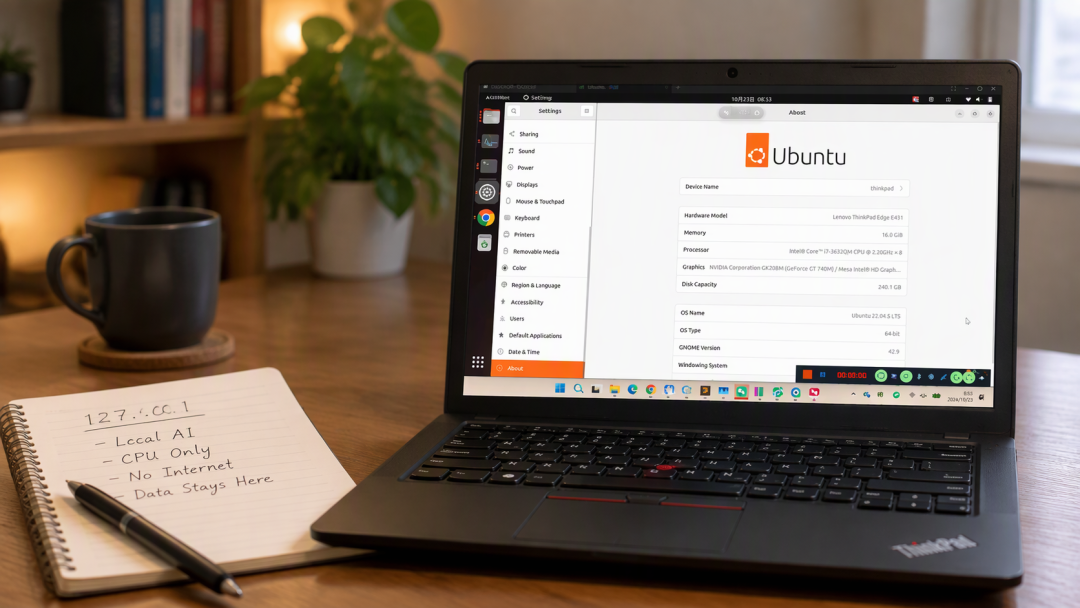
10 月 23 日,B 站有个不到千次播放的视频,被收藏的次数比点赞还多。标题起得很响:一台 2014 年的 ThinkPad,让 UP 主实现了「Token 自由」——纯 CPU、不联网、花费 0 元。视频内容朴素:一台 ThinkPad Edge E431,三代酷睿 i7-3632QM 八线程、16G 内存、Ubuntu 22.04,跑一个本地决策应用,从提交到出一张打分表约 4 秒,服务地址 127.0.0.1——请求物理上出不了这台机器。 UP 主还在简介里挂了招募:评论区报上旧机器型号和内存大小,他来评估能不能跑。哔哩哔哩
这不是一个人的孤例。同一周,低配笔记本就能跑起来的大模型视频拿到 1.9 万播放、2900 多次收藏。 另一条 4GB 显存跑起 70B 大模型的实测播了 5.6 万次。 知乎问题"很多人认为本地部署一个大模型,就实现token自由,就可以干活了,真的吗"累计 139 万浏览。 用旧笔记本跑模型、把大模型费用打到零,正在变成双 11 硬件圈的一股暗流。哔哩哔哩哔哩哔哩知乎
ThinkPad 用户看到这股潮流,第一反应往往有两个:家里吃灰的 E431、T430 真能干这个?新机都挂着 AIPC 标了,为什么反而看旧机?这篇把三个账算清楚,再对着 2026 年的小黑产品线画一条分界线。
第一本账:速度账——本地跑模型的闸门是内存,不是认证标
先看一台现代轻薄本的天花板。知乎专栏 10 月 20 日的纯 CPU 实测:i7-1260P、16G DDR4、无独显,用 llama.cpp 跑 16B MoE 模型的 Q4 量化版(文件约 10GB),生成速度约 6.7 tokens/s,冷启动 11 到 12 秒,模型加载完,系统剩余内存只剩 0.3 到 0.6G。 这是 2022 年的 12 核处理器,2013 年平台的三代 i7 只会更慢,能跑的是更小的模型。知乎
为什么内存是主角?10 月 23 日 B 站一条硬核讨论给的口径很直接:解码速度由内存带宽决定,与算力无关——同一 Blackwell 架构,1792GB/s 带宽的卡比 273GB/s 的快 5 到 6 倍。 7 月工信部公布首批国标《人工智能终端智能化分级》L3 级名单,Think 家族 14 款 AIPC 通过。 但那次测评看的是感知、认知、执行、记忆、学习五项能力分级,不会给你的本地模型多吐一个 token。换句话说,AIPC 认证和小红点一样是身份标识,本地推理的性能门票在内存容量和带宽上,NPU 帮不上大忙。哔哩哔哩微博
第二本账:成本账——想省 token 钱,你其实不需要换机器
知乎 10 月 20 日有人把 API 账单拆成了计算器:主流接口输入单价 0.8 到 8 元每百万 token,输出 2 到 16 元,缓存命中只有输入价的十分之一;按每天 500 次、单次输入 2000 加输出 800 的中度用量,最贵的通用对话模型月账单 324 元,轻量小模型只要 37.2 元。知乎
再对照今年换硬件的价格:16GB DDR5 内存条去年四百多块,现在一千八,涨了三倍。 36 氪 10 月的报道标题写得更直接:“内存涨价潮余波蔓延:Ultra机型相继被取消,旗舰越来越难卖”。 上一轮低价时 64G DDR5 只要一千多块——那是去年,不是今年。算到这里,结论反常识:纯粹为了省 API 账单去买一台 64G 的新小黑(T14p 2026 的 Ultra X9/64G 版公示价 23999 元),这笔账怎么算都回不来。旧机党"Token 无限量、花费 ¥0"的真实含义是:吃灰成本已经付过,边际成本归零,代价是 6 秒一句话的速度和更小的模型。省钱的正确姿势从来不是换机,是把云账单上的模型档位降一级。知乎36氪知乎
第三本账:数据账——本地路线真正赢的地方
那什么场景值得折腾?前面那篇实测文列了四类:公文合同不能上云的政企办公、断网内网、数据主权、高频使用的长期成本。 E431 视频里那句"请求物理上出不了这台机器",是任何云端 API 给不了的承诺。这也解释了为什么那个视频收藏远大于点赞——收藏它的人,多数是真的有数据不能出门。知乎哔哩哔哩
但要防另一个坑。知乎上"本地部署大模型有必要吗"的高赞回答说得直白:要最强的能力,同价位下在线大模型还是压本地小模型一头,本地赢在地理位置和成本,不赢在智商。 Token 自由是真的,模型能力自由不是。知乎
落到产品:2026 年,哪台小黑配得上"跑本地模型"这个需求
把社区经验(旧机党标配是 16G 双通道,天津机友给 T430 升了 35W 顶配四核 i7-3632QM 加满 16G 内存)对到 2026 年新品,分界线只有一条:内存形态。哔哩哔哩
X1 Carbon、X13:焊死在主板的 LPDDR5X,买定就改不了。想跑本地模型,容量必须当场买够,而今年大容量版本的溢价里塞着翻倍的内存条成本。
E14、E16:两条 DDR5 插槽,官方口径"可自行加装或替换",是新品小黑里少数留着后路的选择,官网公示价 12999 到 13499 元。
T14 2026:部分配置是插槽,下单前必须逐条核对;上一代 T14 Gen5 被 Notebookcheck 实测确认恢复了两个 SO-DIMM 插槽。
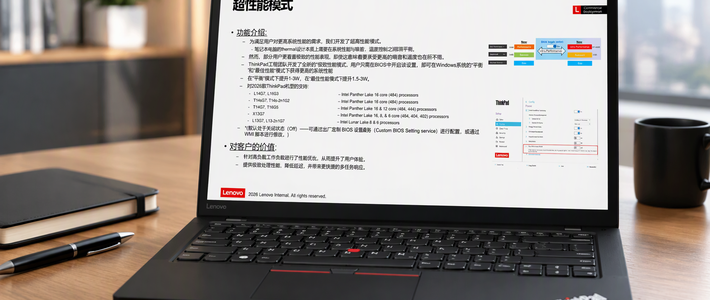
T14p 2026:用的是 LPCAMM2 内存模组,能换,但那是专用模块不是普通内存条,价格和渠道都不一样,32G 版 12999 元、64G 版 23999 元,别把它当 E14 那样的扩容机。
二手老款(E431、T430、X230 这一代):DDR3 插槽、内存便宜,16G 双通道就能进本地模型的门,唯一代价是 2013 年平台的速度和没有现代编解码的屏幕接口。
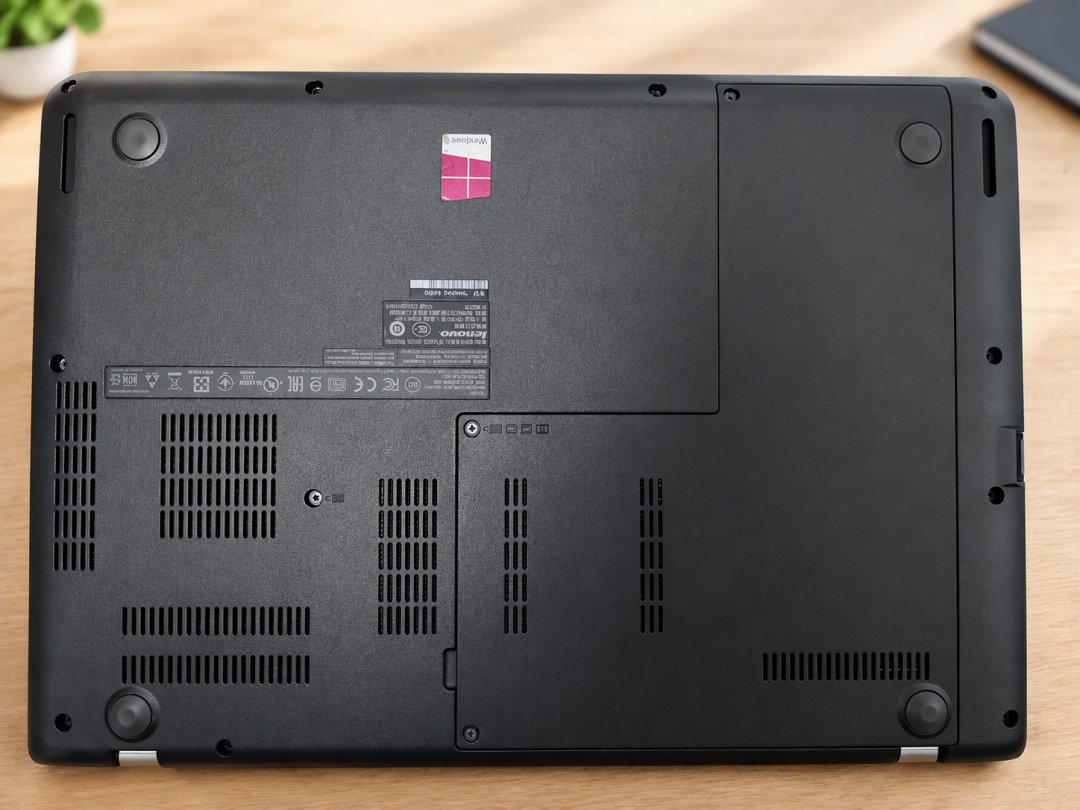
自查方法一句话:打开规格页搜"内存"两个字,写 LPDDR5x、写"板载"的,容量当场定终身;写 DDR5 插槽、SO-DIMM、CAMM2 的,才有后路。知乎
谁该出手,谁该观望
数据不能出电脑的人,按上面的分界线买,内存 32G 起步,插槽形态优先——"Token 自由"对你们是伪需求,"数据不出门"才是真需求。家里正好有台 16G 老小黑的,今晚就能零成本试水:Ubuntu 加 llama.cpp 或 Ollama,从 4B 到 7B 的 Q4 量化小模型跑起,以"加载后剩余内存"为准判断天花板。唯一动机是省 API 钱的,按兵不动,37 到 324 元的月度区间里,云端比硬件便宜。追最强智力的,继续用云。
值得继续盯的信号也有两个:一是内存条价格曲线,DDR5 若从 1800 元跌回四位数,插槽机"以后再补一条"的期权立刻重新值钱;二是 LPCAMM2 模块的第三方供货渠道,它决定 T14p 用户的后路是真是假。
垃圾佬圈量小黑,历来看拆件和配件供应;这波本地 AI 潮给了同一批机器第二把尺子:决定你能不能"Token 自由"的,不是 CPU 的年代,也不是机身上的认证标,是那条内存插槽——或者那块焊死的板子。小红点是身份徽章,但对跑本地模型的人来说,真正的身份徽章是联想还给了你亲手换内存的选择权。翻出你吃灰的那台,看看 CPU 第几代、内存多大,再对照 6.7 tokens/s 和"剩余 0.3G"这两把尺子——评论区聊聊,你的老黑能跑到哪一档。