






















21
29
这也太强了!细数 10 个 DeepSeek 顶级开源项目
2026-10-22 22:12:40
1点赞
1收藏
0评论
点击上方蓝字关注我,加个🌟标不迷路。
各位小伙伴们大家好,我是 cxuan。
xdm,我宣布,这两周是属于 DeepSeek 的时刻。
先是 DeepSeek-V4.1-Flash-1017 基于 V4.1-Flash 做了后训练发布;然后没两天又把 DeepSeek 的线上推理框架 DeepInfer 开源了。
我这两天分配了大概 50% 的人类精力在 DSH + DeepSeek-V4.1-Flash-1017 上,我发现 DeepSeek-V4.1-Flash-1017 这个版本,回答明显更加谨慎,比如我让它跑了一个 3D 鹈鹕的复刻,它很大方的承认复刻的不如 Opus 5.5 ,但我觉得还原度大概 80% ,很不错了。
 image-20261021194337738
Opus 5.5 版 3D 鹈鹕

DeepSeek-V4.1-Flash-1017 版 3D 鹈鹕
而原来的 DeepSeek-V4.1-Flash 却很大胆,这是不是从侧面说明大肥鱼成熟了?
不过 DeepSeek 在 GitHub 上扔了一堆开源模型,从底座模型、底层算子到存储系统、Agent 套件,以至于很多人包括我都有点懵逼 DeepSeek 到底都开源过哪些项目?
这篇文章我们就系统性盘点一下 deepseek 开源的最有价值的 10 个顶级开源项目。
内容推荐的指标为综合了开源影响力、受众范围、Star 数量、repo 质量等范围,不能作为唯一推荐指标,请大家理性看待。
10. DeepSeek-Math
虽然这个 repo 只有 3K + Star,但在大模型技术演进史上,它的权重和影响力甚至不亚于很多百亿级的大模型。
2024 年 2 月发布时,行业主流还在迷信海量 SFT 数据堆叠,对于大模型到底能不能脱离外挂求解器、单纯依靠模型内生逻辑进行深度推理,业内争论不休。
 image-20261021202303995
DeepSeek-Math 7B 从 DeepSeek-Coder-Base 启动,利用自研的无监督与弱监督清洗流水线,从 Common Crawl 中筛出了一个 120B Token 的高纯度数学语料库(DeepSeekMath Corpus)。
 image-20261021202351406
这项工作证明了一个关键事实:高质量代码和数学语料的连续预训练,是激活大模型深度逻辑推理能力的基石。
除此之外,这篇论文首次提出了 GRPO(Group Relative Policy Optimization,组相对策略优化)。后来震动全球的 DeepSeek-R1-Zero 和 R1,算法底层完全脱胎于 Math 提出的这套 GRPO。
这个 repo 是理解今天大模型强化学习必读的第一堂课。
9. DeepEP
这是 DeepSeek MoE 的通信库,是 2025 年 2 月 DeepSeek 开源周第二天放出的硬核杀器。
在拥有数百个稀疏专家的现代 MoE 架构中,单张 GPU 根本装不下所有专家,必须将不同的专家分散在成千上万张显卡上。
此时,每一个 Token 在经过门控路由时,都必须跨卡甚至跨物理节点发送给指定的专家,专家计算完毕后再跨网络把激活结果汇总回来。而这两次 All-to-All 集合通信,是制约 MoE 模型训练和推理速度的最大瓶颈。
DeepEP 是业内极少数将底层通信协议与具体硬件拓扑彻底焊死然后开源的底层通信库:
• 机内用 NVLink,机间用 RDMA:同一台机器里的显卡走高速互联,不同机器之间走低延迟网络,让 Token 更快地送到对应专家,再把结果收回。
• 通信与计算重叠:传输数据的同时,安排不依赖这些数据的计算,减少 GPU 停下来等网络的时间。
• 支持 FP8 数据分发:用更紧凑的 8 位浮点格式传输数据,减少需要搬运的数据量,缓解网络带宽压力。
凡是想自建大规模 MoE 生产集群、优化分布式训练调度的人,DeepEP 是唯一的工业级参考标准。
8. 3 FS
2025 年开源周最后一天压轴登场的系统项目 3FS ,Star 刚过万,它是 DeepSeek 所有万卡集群能平稳吞吐海量数据的底层命脉。

一般来说,大模型预训练和超长上下文推理有两大致命 IO 场景:
1. 预训练海量小文件并发吞吐:数千个 Rank 节点每秒以极高并发请求不同领域的文本、代码数据,稍有阻塞就会导致算力空转。
2. 极速 Checkpoint 刷盘与 KV 状态换入换出:几百 GB 的权重断点保存必须在数秒内完成,否则故障恢复和训练推进的代价无法承受。
3FS 完全丢弃了传统 POSIX 复杂的历史包袱,专为 AI 工作负载重新设计了存储路径:
• 存算分离:GPU 节点负责计算,存储节点把大量 SSD 组成共享存储池。计算节点可以统一访问这些数据,不必把所有训练资料都放在本机。
• CRAQ 强一致复制:同一份数据保留多个副本,让不同副本共同分担读取压力,同时通过复制协议保证数据一致。
• RDMA 高速访问:让计算节点和存储节点通过高速网络交换数据,减少数据传输开销,提高训练数据读取、模型断点保存和推理缓存访问的吞吐。
不过 3FS 的源码 ,C++ 加 Rust 几十万行,读完人也差不多没了,千万别读,看看 README 和设计文档就行了。
7. FlashMLA
这是专门针对 NVIDIA Hopper 架构(H800/H100)优化的 MLA 解码高性能算子库。
DeepSeek-V2 和 V3 之所以能把推理成本降到不可思议的程度,核心功臣是 MLA(Multi-Head Latent Attention)。MLA 把庞大的 KV Cache 压缩到了一个极小的维度,显存占用骤降 90% 以上。
 image-20261021231819628
FlashMLA 早期 Hopper 版本的思路,就是围绕 MLA 的压缩缓存,把解码阶段的计算性能提升:
• 直接适配压缩后的 KV Cache:在压缩表示上完成注意力计算,减少把缓存展开后再读写显存的开销。
• TMA 与流水线调度:利用硬件提前搬运数据,并把数据搬运、矩阵计算等任务交错安排,尽量让 GPU 少等数据、多做计算。
• 支持变长序列与分页缓存:不同用户的上下文长短不一,缓存也可能分散在不同显存块里,算子能按实际长度和缓存位置处理,适应多请求一起推理的场景。
FlashMLA 核心逻辑不过几百行,对于想学习现代 GPU 架构硬件流水线、异步内存拷贝与汇编级算子调优的开发者来说,这是市面上最纯粹、最现代的高性能 Kernel 教材。
6. DeepInfer
10 月 16 日建仓,才五天,已经 1.86 万 star 了。 这是 DeepSeek 每天支撑数以亿计生产请求的同一套底层引擎。
 image-20261022001855411
vLLM、SGLang、TGI 等通用开源推理框架的目标是尽可能适配所有的模型架构和硬件环境,因此不可避免地引入了大量的抽象分层、调度胶水代码和通用显存管理。
DeepInfer 的做法,是围绕 DeepSeek 模型和实际部署硬件,把算子、并行策略和调度一起优化。它最初也是在 vLLM 的基础上构建的,关键优化有这几项:
• 定制高性能算子:把 FlashMLA、DeepGEMM、DeepEP 等组件接进执行流程,分别优化注意力计算、矩阵运算和专家之间的数据通信。
• MoE 专家并行与负载均衡:把专家分散到不同设备上,并调整专家负载,减少部分设备忙不过来、其他设备却在空转的情况。
• 异步调度:GPU 计算当前批次时,CPU 同时准备后续批次,减少调度带来的等待。
• 投机解码:通过 DSpark 先生成候选 Token,再批量验证,并根据置信度安排验证过程,提高生成效率。
这个要看的话,需要去对比阅读 DeepInfer 与 vLLM 的执行流水线。你会深刻理解:当抛弃了大而全的框架包袱、把每一条算子和调度流水线完全为自家模型量身定制时,能压榨出多么恐怖的吞吐和资源利用率。
5. DeepSeek-OCR
开创上下文光学压缩技术路线,把数十页文档压缩进少量视觉 Token。

以往大模型在面对数百页财务报表、密集论文、工程图纸或长代码库时,传统方案是用 OCR 将其强行转录为纯文本喂进 Context 窗口。这种做法有两个致命缺陷:
1. Token 爆炸与算力激增:几十万字的纯文本会急剧撑大 KV Cache,导致注意力计算成本呈二次方飙升;
2. 结构信息灾难性丢失:表格的排版对齐、双栏混排、缩进、流程图以及图文混排的相对空间关系,在转录为扁平字符串后变得不能看了。
DeepSeek-OCR 换了一个极具想象力的视角:为什么一定要先转成字符文本?
它采取了直接将文档高保真渲染为高清图像的思路,通过专用视觉编码器(Vision Encoder)进行 Patch 细粒度切分与光学特征提取,于是一整页密密麻麻、可能包含数千个文本 Token 的文档,经由光学压缩后,只需要几十甚至几百个 Token 就能完全表征。
4. DeepSeek-Coder
这是国产 Coding 大模型的奠基之作,一路进化出全球首个超强开源 MoE 代码旗舰 Coder-V2。
2023 年 10 月发布第一代,那是很多人第一次真正认识 DeepSeek 的起点。
在 2023 年下半年,开源社区的代码模型基本处于辅助补全单行代码尚可,处理复杂工程一塌糊涂的状态,全球开发者只能依赖闭源的 GPT-4。而 DeepSeek 决定从零预训练一个专门的代码基座。
• 在 2 万亿 Token 上从头预训练,训练语料为 :87% 为覆盖 80 多种主流语言的源码,10% 为技术文档与中英文代码答疑,3% 为高密度数学逻辑语料。
• 在预训练阶段就引入前缀、后缀与中间留空的双向掩码训练,使得模型不仅能向前续写,更能根据光标前后的代码上下文精准进行局部重构与行内补全。
• 支持 16K 乃至更大上下文,针对大型工程的项目依赖结构进行了针对性训练。
2024 年 6 月演进出的 DeepSeek-Coder-V2 更是成为全球第一个开源的 MoE 代码大模型(236B 总参数 / 21B 激活)。不仅将支持的语言拓展到 338 种、上下文撑到 128K,而且在 HumanEval、SWE-bench 等核心测试集上正面迎战并超越了 GPT-4-Turbo,彻底打破了写代码只能用国外闭源模型的固有偏见。
3. DeepSeek-R1
大模型强化学习与深度推理的工业革命,打破了 OpenAI o1 垄断的神话。
2025 年 1 月 20 日,DeepSeek 正式发布 R1。仅仅一周之内,因其展现出的颠覆性成本与算力重构效应,在资本市场掀起滔天巨浪,一周后英伟达单日跌 17%,蒸发近 5900 亿美元。一个开源模型能做到这个份上,前无古人。
 image-20261022002818110
在此之前,推理模型被普遍认为是极少数硅谷巨头依靠海量人工标注思维链(CoT)和不计成本的过程奖励模型(PRM)才能构筑的绝对护城河。高昂的训练成本与黑盒的算法细节,让推理能力成为极度昂贵的奢侈品。
R1 技术报告 给出了一条以强化学习为核心的推理训练路线,关键有四点:
• R1-Zero 用纯强化学习探索推理:直接从 DeepSeek-V3-Base 出发,不先做监督微调。对数学题检查答案,对代码题运行测试,再用这些反馈训练模型,逐渐激发出自我检查、反思等行为。
• GRPO 降低强化学习开销:让模型对同一道题生成一组答案,根据组内得分比较哪些回答更好。这样省去了 PPO 中通常需要的独立价值模型,减少训练时的显存和计算开销。
• R1 用多阶段训练提高可用性:先用少量冷启动数据规范输出,再进行推理强化学习;随后筛选优质答案做监督微调,最后继续强化学习,兼顾推理能力、可读性和通用任务表现。
• 蒸馏让小模型也能学会推理:把 R1 生成的优质推理数据用于微调 Qwen、Llama,得到 1.5B 到 70B 的多个蒸馏版本,降低部署门槛。
2. DeepSeek-V3
2024 年 12 月发布,总参数 671B,每个 Token 激活 37B,在 2048 张 H800 集群上仅耗费约 557.6 万美元的训练成本,就在各项基准上追平并局部超越了世界顶级闭源大模型。
 image-20261022002910899
传统的 Transformer 架构在越过几千亿参数规模时,面临着算力成本指数爆炸、显存墙难以逾越、长文本 KV 缓存挤爆硬件等一系列死胡同。DeepSeek-V3 是将系统级硬件考量深度反哺到算法架构设计的先锋。
V3 技术报告里最值得记住的是这四点:
1. MLA:把 KV Cache 压小。用更紧凑的表示保存历史上下文,减少推理时的显存占用,让长文本和更多并发请求更容易跑起来。
2. MoE 与无辅助损失负载均衡:按需调用专家。每个 Token 只调用少量专家,同时通过动态调整路由偏置,让任务尽量分配均匀,减少专家忙闲不均造成的浪费。
3. FP8 混合精度训练:降低计算和存储开销。大部分矩阵运算使用更紧凑的 FP8 格式,数值敏感的部分保留较高精度,在提高效率的同时维持训练稳定。
4. MTP 多 Token 预测。训练时增加后续 Token 的预测目标,帮助模型学习;推理时也可以利用 MTP 模块先生成候选 Token,再通过投机解码验证,加快输出。
可以去读仓库里的 inference/model.py。没有任何臃肿冗余的第三方框架依赖,仅仅用了 800 余行极度精简、纯净的 PyTorch 代码,就把 MLA、MoE 动态路由、RMSNorm、RoPE 全部刻画得清清楚楚。哪怕不跑模型,单把这一个文件彻底读懂,对现代大模型工程架构的理解就能超过绝大多数人。
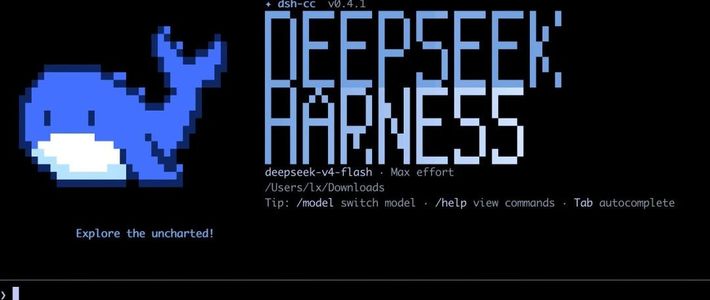
1. DeepSeek Harness
DeepSeek 2026 年最炸裂的开源项目 --- DeepSeek Harness 。
基于 Cordis 微内核构建的原生下一代 Agent 运行底座,全面拥抱一切皆插件与驾驭工程(Harness Engineering)。

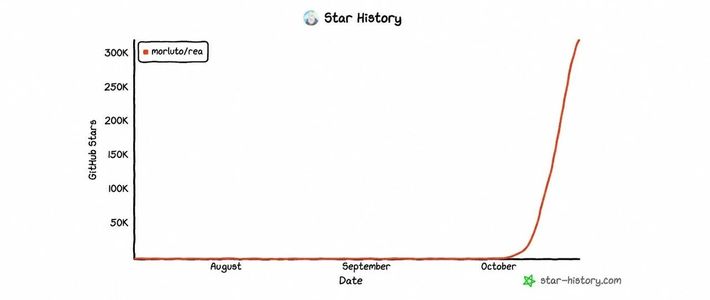
2026 年 8 月 13 日正式以 MIT 协议开源,仅仅两个多月,Star 数突破 25 万,一举成为整个组织乃至 GitHub 上最具统治力的明星级 Agent 基础设施。
 image-20261022003901087
很多人以为 DSH 的爆发纯靠 DeepSeek 的品牌号召力,但只要你去翻过它仓库下的 .agents/notes/ 目录,就会被其工程文化彻底折服。
 image-20261022004112003
在崔添翼带领的工程团队手里,每一篇系统演进笔记都带着真实的思考日期、当时面临的方案选型、不同硬件平台下的 Trade-off,以及被放弃的技术路线。这种将真实系统架构设计过程全景留痕、毫无保留地向全世界公开的治学与开源态度,远比几万行代码本身更加稀缺和震撼。
写在最后
复盘完这 10 个项目,你会发现 DeepSeek 的开源轨迹与其他 AI 公司有着本质上的不同。
大部分厂商开源,往往是我做了一个产品,开源一个精简的推理 Demo 供大家围观测试;而 DeepSeek 的开源,它是自上而下的全链路解剖。
• 在算子层,它用 FlashMLA 压榨 Hopper 架构的 TMA 与显存带宽极限;
• 在通信层,它用 DeepEP 解决跨机 MoE 专家并行的 All-to-All 吞吐阻碍;
• 在存储层,它用 3FS 依托全闪和 RDMA 构建支撑万卡吞吐的 IO 动脉;
• 在模型层,它用 DeepSeek-V3 和 R1 证明了 MLA、无辅助损失 MoE、纯强化学习 GRPO 能跑赢昂贵的算力堆叠;
• 在服务层,它把线上同款的 DeepInfer 推理引擎毫无保留地开源。
• 在应用层,它用 DeepSeek Harness 定义了下一代 Agent 的驾驭工程范式。
做算子看 FlashMLA,自建集群看 DeepEP 和 3FS,学架构看 V3,搞强化学习看 Math 和 R1,做线上生产看 DeepInfer,搞 Agent 工程化看 Harness。
不私其技,愿与天下共之。这种敢把核心生产力拆解到极致的从容,才是一家顶尖科技公司真正让人肃然起敬的地方。
在若干年前三连还需要特意在文章最后呼吁一下,但就像是 Skill 被刻进模型的系统提示词一样,这次的点赞、在看和转发,也早就写入各位人类读者的 Harness 里了,所以各位,不用我再特意提醒了吧?









