

跑分第一却还没上榜:这个11月的Arena榜单,快追不上模型发布了
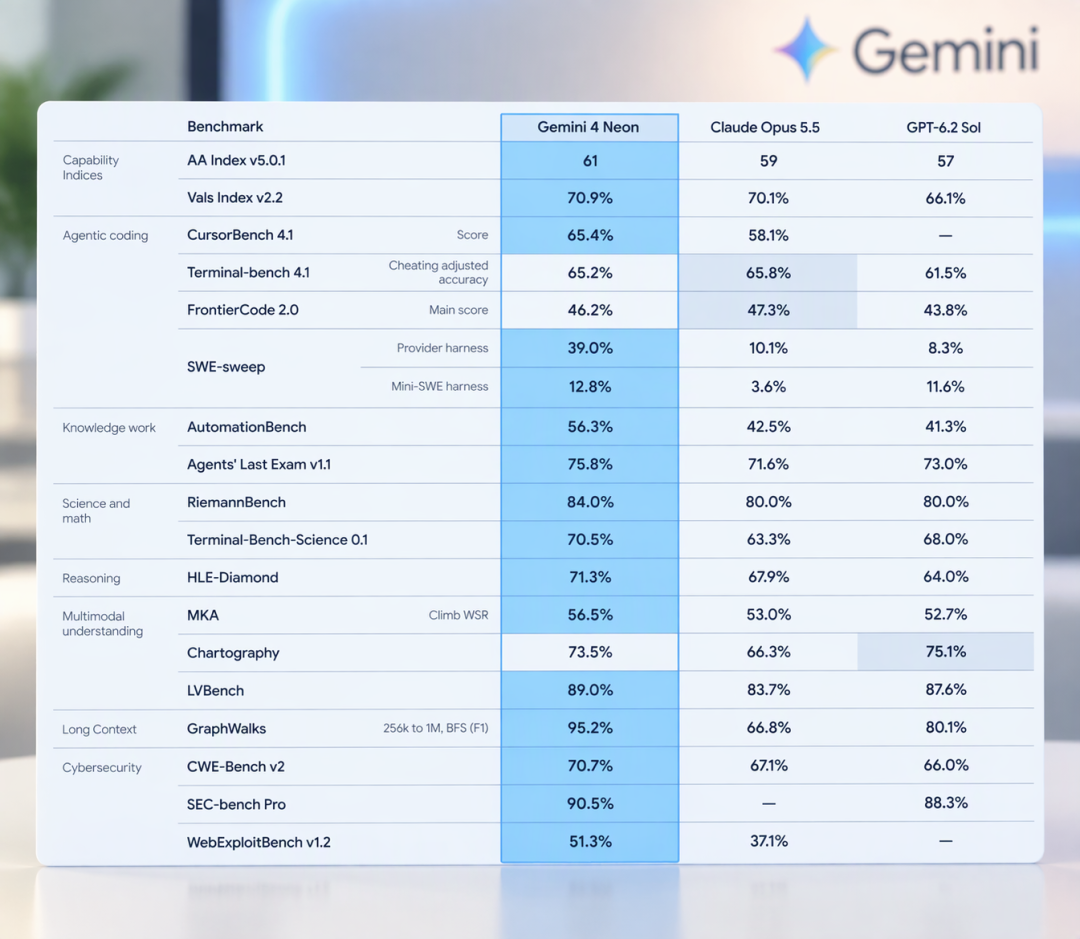
11月18日,谷歌把 Gemini 4 Neon 一发出来,隔天就有第三方追踪发现:它已经杀进了 Arena 的 Agent Arena 榜——全球第二,只比 Claude Fable 5.2 Max 低 1 分。微博小红书
而另一边,Fable 5.2 就有点尴尬了:综合跑分第一、Agent 榜第一,但在 Arena 的"聊天榜"(Text Arena)上,目前连个条目都还没有。小红书微博
模型在冲刺,榜单是后视镜。这个11月的 Arena,最有意思的不是谁登顶,而是榜单是怎么"漏掉"新模型的。
四连发,榜单怎么跟得上?
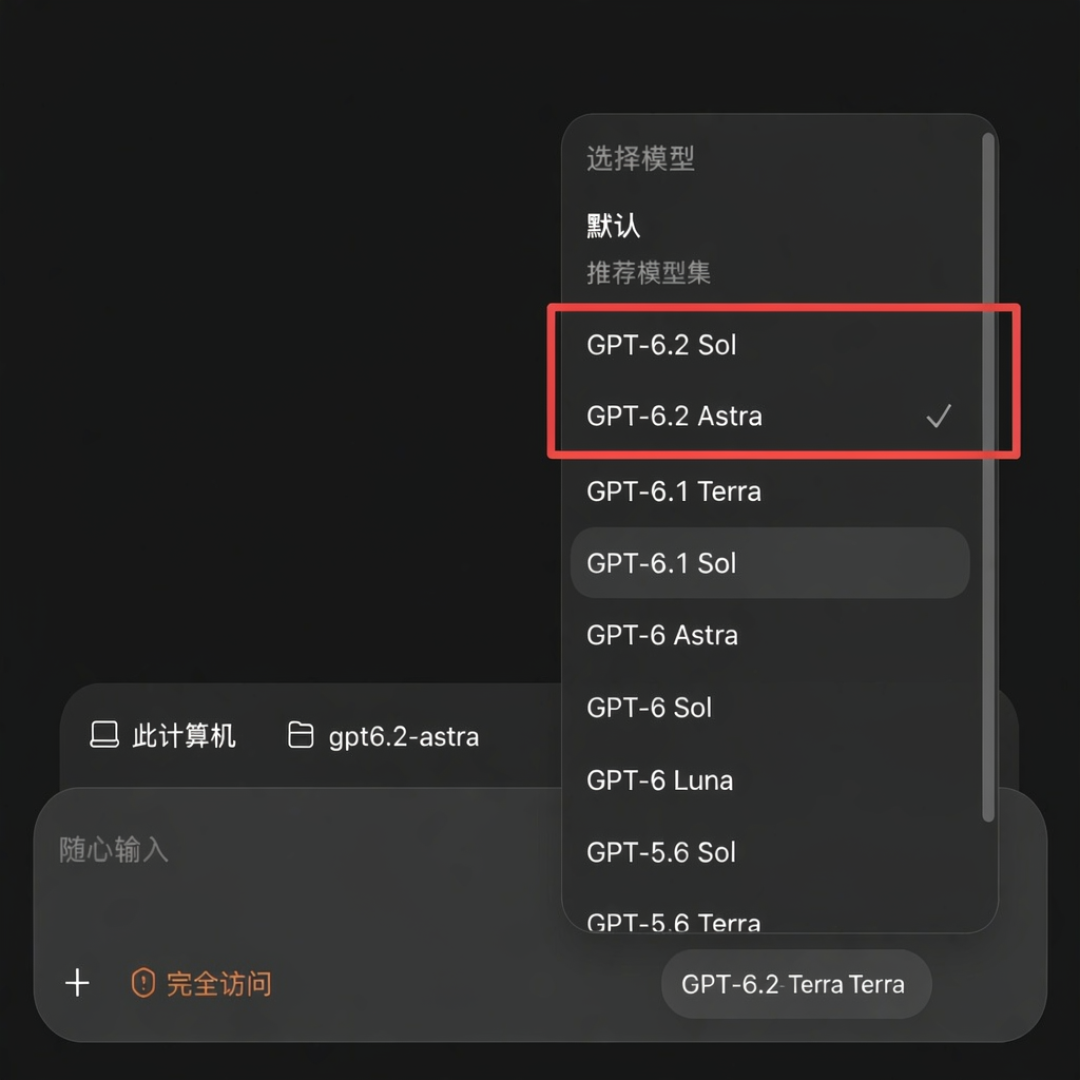
这个11月,谷歌把 Argon、Carbon、Hydrogen、Neon 挨个发了出来;11月16日,Qwen4-Max 正式版上线;11月19日,腾讯开源了 Hy4flash。而 Text Arena 那张11月9日更新的榜,还是老面孔:Gemini 4 Carbon(High)1526 分排第一,整榜累计票数超 910 万,覆盖 421 个模型版本。小红书小红书知乎知乎小红书
别急着下结论:榜首只有 4273 票,挂着 Preliminary(初步结果),误差区间约 ±10;排第二的 Argon 却有约 2 万票。翻译一下:这个第一名,还没坐稳。小红书
至于"漏掉"的 Fable 5.2,更有意思——跑分第一≠盲测第一。Text Arena 的规则很朴素:两个匿名模型答同一道题,用户挑更喜欢的那个。它测的是"人更爱跟谁聊",不是"谁跑分快"。Fable 5.2 的票数攒够之前,榜上还撑不起"聊天之王"的说法。
GPT"翻身",是榜单换了
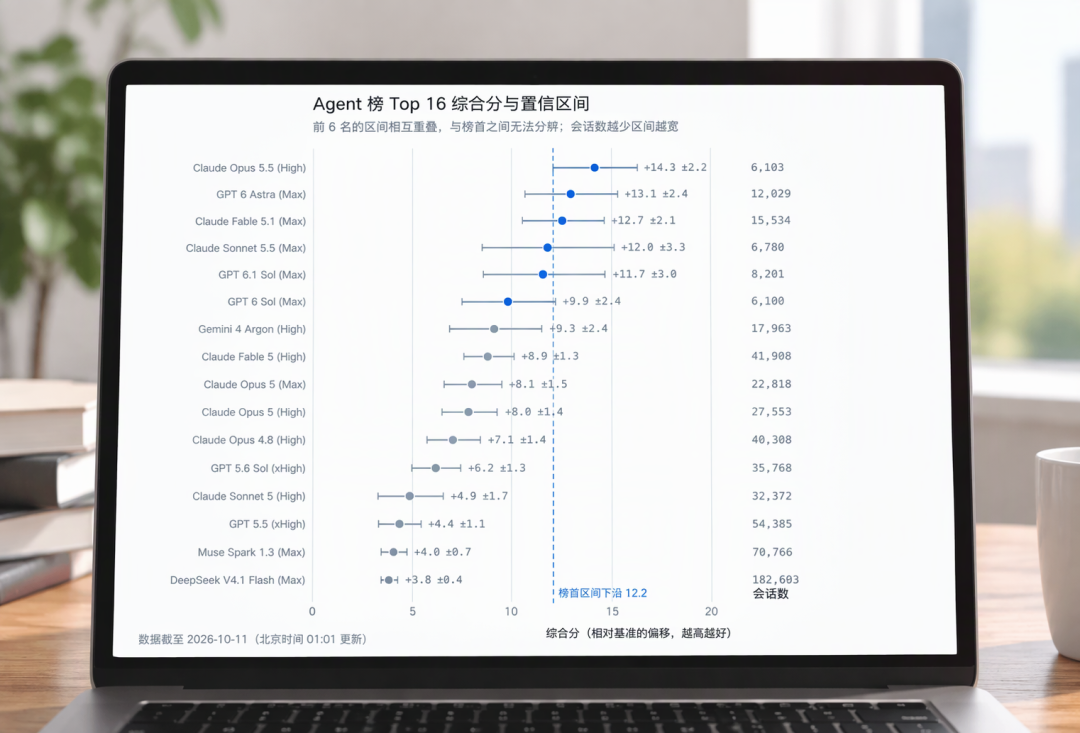
再给一个反直觉数据:GPT-6 Astra 在聊天榜只排第 41,在 Agent Arena 却排第 3。同一个模型,两种判法——两把尺子量的根本不是一回事:知乎小红书
聊天榜:对话偏好、表达和沟通体验;
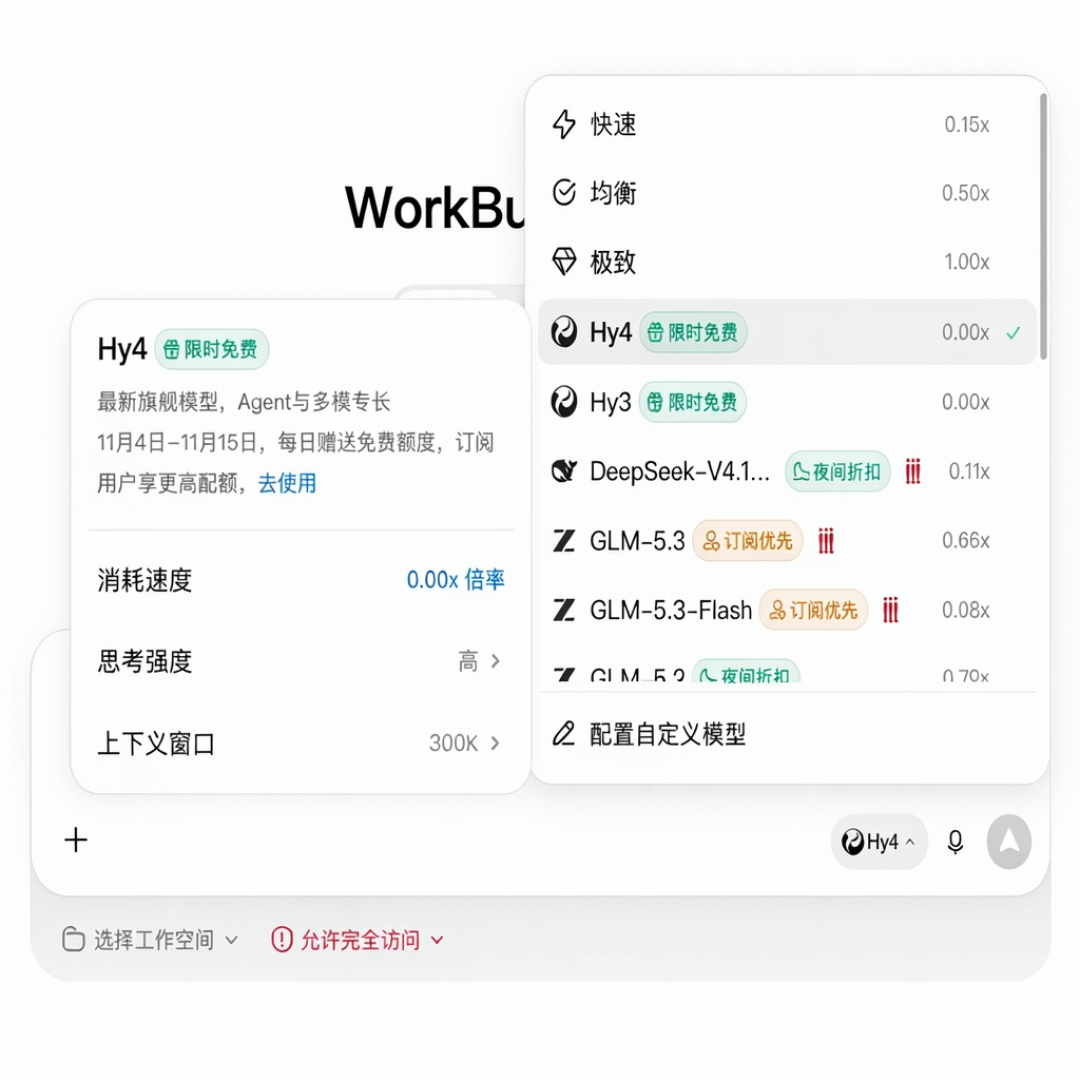
Agent Arena:基于 1.2 万+ 场真实世界的长周期 Agent 干活会话,看模型能不能把任务干完、工具调用稳不稳,还看成本——腾讯混元 Hy4 以 +5.4% 的净提升排第 5,是前 5 名里唯一的中国模型,单任务成本中位数 $0.57,踩在性价比前沿上;MiniMax、Step 等甚至是负提升。小红书
所以评论区有人问"这种榜还考虑性价比?"——答案是:干活榜真看,长周期任务执行能力、成本效率都是关键维度。微博小红书
榜单这么读,才不被带节奏
先看你用在哪:聊天写稿看 Text 榜,甩长任务看 Agent Arena,要深度推理看 AA 智能指数或 Scale 的 MultiChallenge(后者第一名是 GPT-6.1 Sol,81.95%)。一张榜的第一,说明不了一个模型的一生。知乎
看票数,别只看名次:Preliminary、几千票、区间重叠,都意味着还没站稳。榜首几名差几分,多半是噪声,不是能力差距。
给榜单留个延迟:截至11月中旬,聊天榜上排名最高的开源模型是 GLM-5.3(Max),徘徊在 27 名上下,开源整体掉队。而 Hy4flash 官方内部盲测已经敢说用户满意度(2.79/4)接近 Claude Haiku 5.5(2.81/4)。别指望榜单追上现实,"再等两周"是常态。小红书知乎
评论区里,既有"排名无所谓,我用 DeepSeek 够了"的实用派,也有"Gemini 新模型体感不好用"的质疑派。这恰恰是榜单的正确用法:让排名归排名,让你的使用场景决定看哪张榜。微博
Neon 已经进了 Agent 榜,Fable 5.2 正在赶来的路上。这个11月的 Arena 忙得像倒计时,而你需要做的只有一件事:先想清楚,你要模型替你干什么活。
当前文章无评论,是时候发表评论了