

2026 年最让 HomeLab 玩家肉疼的一句话,不是"硬盘又涨价了",而是"想跑个本地大模型,显卡买不起"。
但 11 月,圈子突然想通了一件事:也许根本不用买卡。
一个 C 语言小程序,把硬盘当显存用
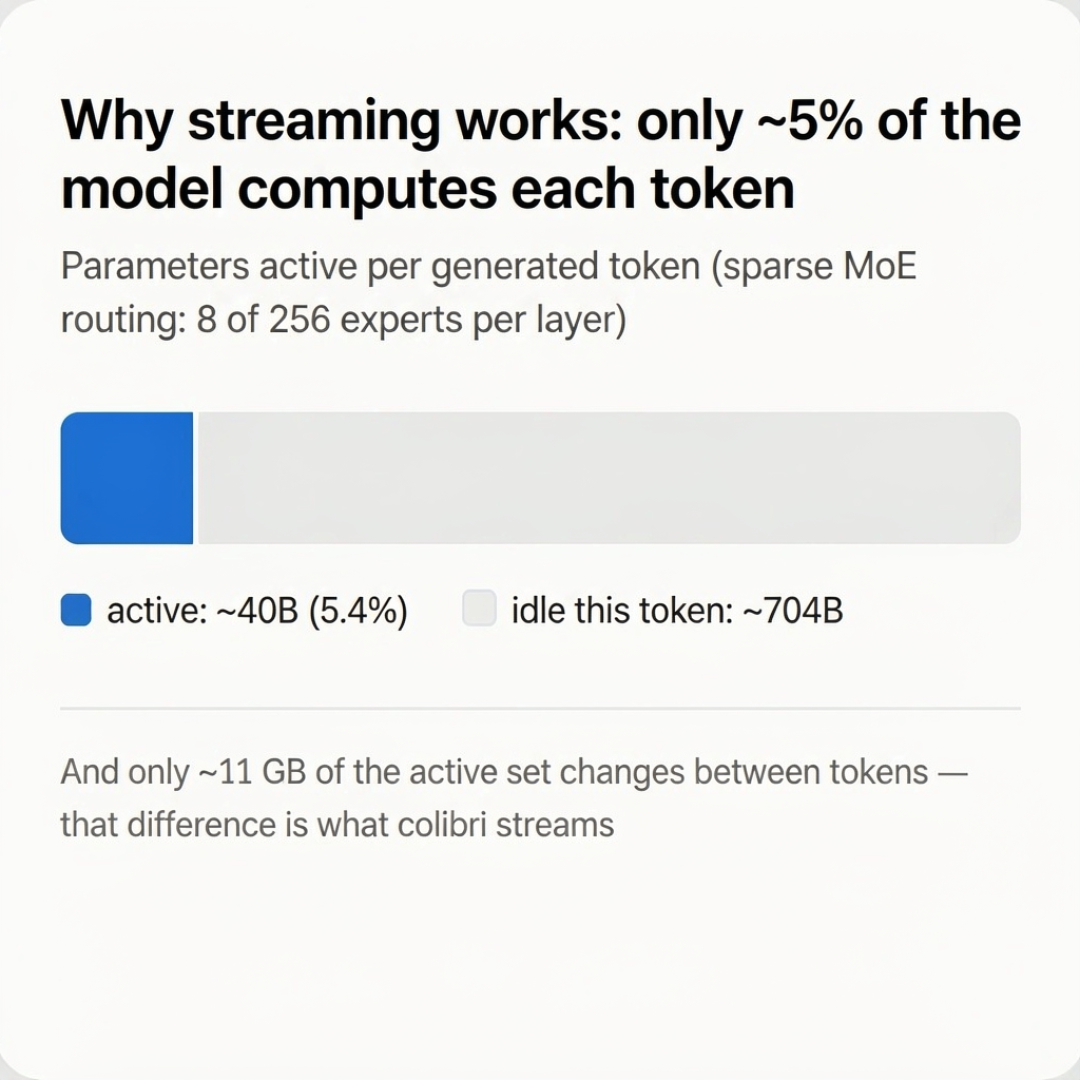
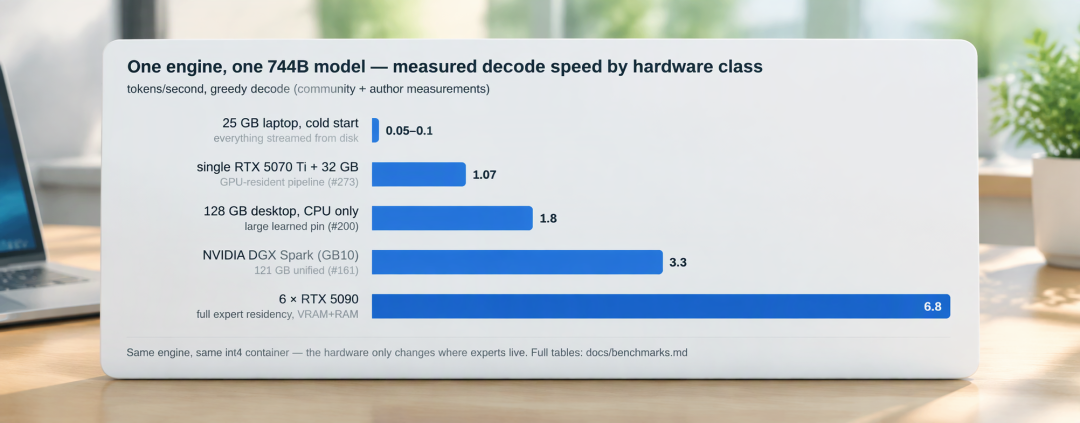
最近走红的开源推理引擎 colibri,完全用 C 语言编写、不依赖任何额外软件库,仅有 25GB 内存的普通消费级机器,就能跑 7440 亿参数的 GLM-5.2。思路很简单:MoE 模型里几百个"专家"平时睡在 SSD 里,轮到谁上线才从磁盘拉谁,内存占用被大幅砍下来。知乎
三条消息扎堆,门槛塌了
llama.cpp 正式发布 v1.0.0,Hugging Face 官宣这次发布,本地推理工具进入"稳定版时代"。知乎
有人整理了 10 款轻量 GGUF 模型,体积从 0.67GB 到 7.32GB 不等,不需要独立显卡,普通电脑纯靠 CPU 和内存就能在本地跑起来。判断门槛的经验公式就一句:模型体积 + 1~2GB 内存。知乎
128GB 统一内存的迷你主机和英伟达 DGX Spark 实测生成速度几乎打平(256 与 273 GB/s 的差距被评测者称为"舍入误差"),一句话点破:让它们有趣的是容量,不是速度。知乎
顺便说一句,包括 Ollama、LM Studio 在内的主流本地工具,实际上都基于 llama.cpp。有玩家用几年前的攒机跑 DeepSeek V4.1 Flash,实测生成速度约为每秒 22 至 42 个 token。权重排布也很讲究:94GB 专家权重放内存,Engram 表走 NVMe——老机器的内存和硬盘,当起了主力。知乎小红书
但先别急着装机:省的是钱,花的是秒数
质疑同样热闹。有博主算过账:真跑起来,每个 token 的推理参数都要从硬盘里疯狂搬运,卡住的不是内存带宽,是硬盘带宽。也有人实测把模型塞进 NAS:省的是硬盘钱,付的是每次 73 分钟的等待,瓶颈在链路不在容量。colibri 官方实测到底多快?目前没人给出硬数据,这里就不替它下结论。微博知乎
三句话建议
只有 8~16GB 内存的旧办公机:挑 1~4B 的 GGUF 小模型纯 CPU 跑,聊天、摘要、本地助手够用;
64GB+ 内存、有 NVMe 的家庭服务器:colibri / llama.cpp 这条 MoE 路线值得折腾,但请带着"慢"的预期上路;
准备花钱升级的:先看内存行情再动手——NAS 圈这两个月被涨价毒打的教训还热乎着。
不需要在显存上赢,只需要在架构上赢。对 HomeLab 玩家来说,"算力自由"的入口变便宜了,只是这个入口上,没有风扇在转。

当前文章无评论,是时候发表评论了