

11月18日,腾讯发布2026年第三季度财报,第一次用官方口径给出WorkBuddy的用量:按大语言模型词元消耗量计,WorkBuddy已成为中国使用量最高的AI产品,每日超千万用户合计消耗100万亿以上词元。把这两个官方数字平均一下,相当于每位活跃用户每天消耗超过1000万词元——而在聊天工具里,一轮问答通常只有几百到几千词元的量级。这个差距本身就回答了热榜上的问题:WorkBuddy登顶靠的不是"聊得多",而是它烧token的方式和聊天工具根本不同:聊天工具为"一次回答"消耗token,WorkBuddy为"一项任务的完成"消耗token。第一财经
一次任务,等于成百上千轮问答
普通AI聊天工具的循环很短:你提问,模型生成一段文字,结束。词元消耗主要取决于对话长度和轮次。
WorkBuddy把单位换成了"任务"。汤道生10月29日在腾讯全球数字生态大会上披露,WorkBuddy上线7个月迭代了100个大版本,累计收到90亿次任务请求。对应的执行过程是:用户交出目标和本地文件,产品自行读取数据、规划步骤、调用工具、生成结果并交付文件。36氪援引其官方实践文档举过一个典型例子——做一份经营分析,用户只要提供Excel或CSV并指定指标范围,WorkBuddy就会读取数据、统计计算、生成图表、汇成报告。用户"发一条消息",系统里跑的是一条完整的执行链。界面新闻36氪
这类消耗已经大到需要专门扩容:11月5日腾讯公告,因Hy4模型调用激增,WorkBuddy已完成十倍扩容。B站上流传的用户演示也印证了它的形态:手机远程给电脑"派活"、让AI操控浏览器自动填表、定时任务每天自动跑一轮——这些在聊天窗口里都无法发生。界面新闻第一财经
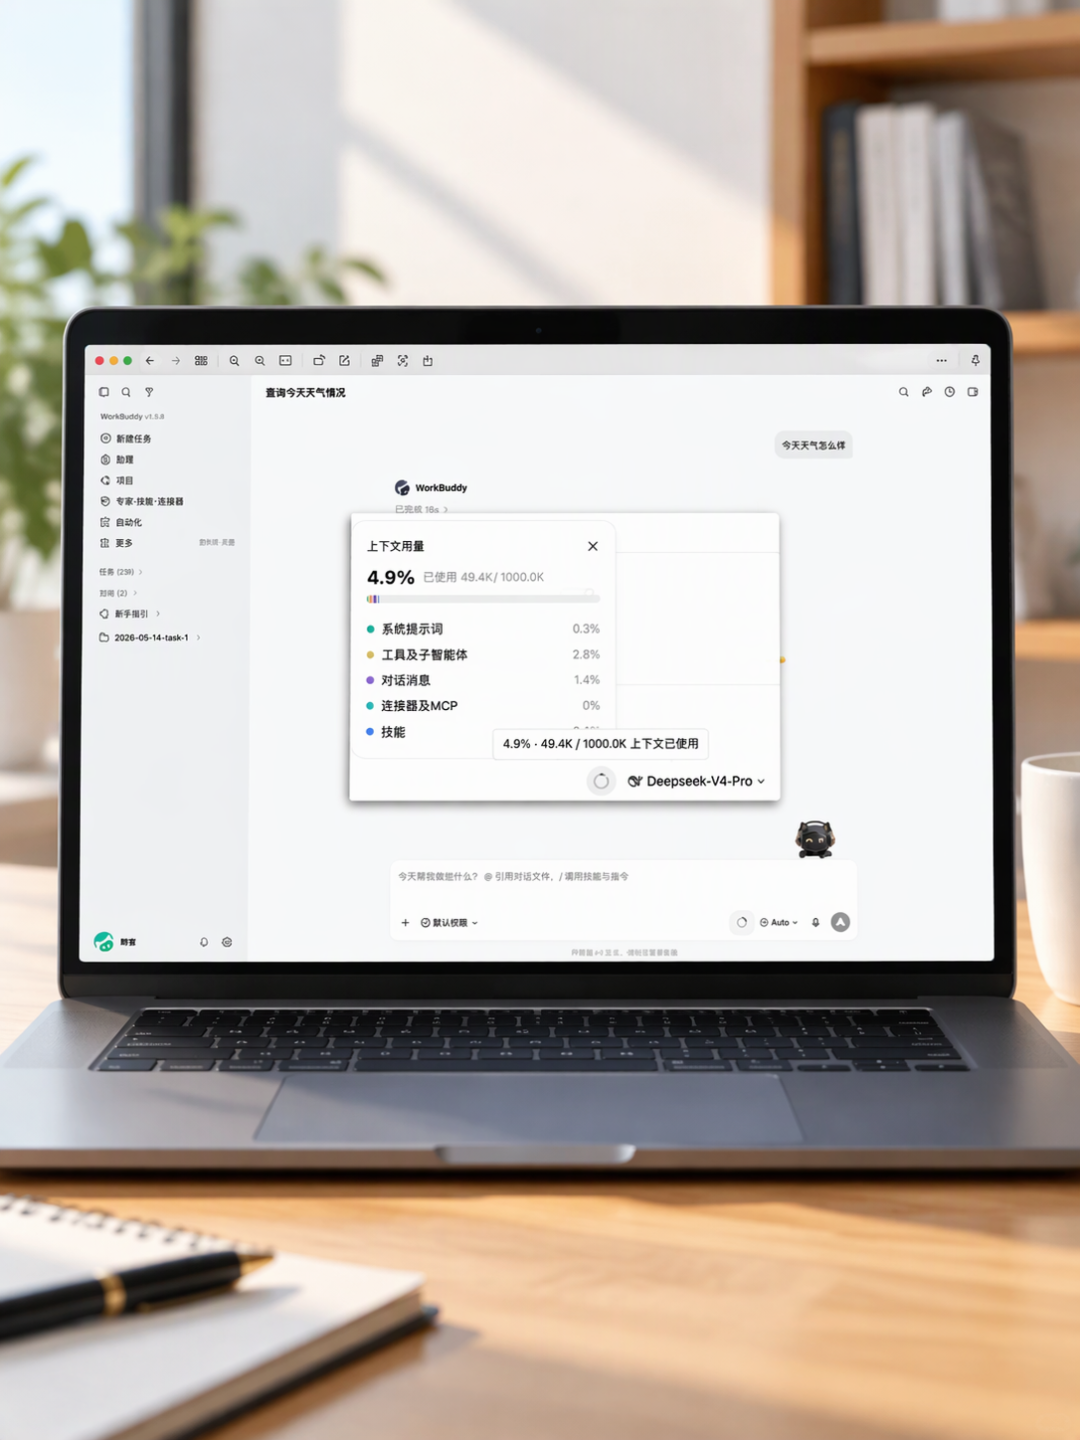
用户侧的直观感受是:聊天工具的输出是一段文字,WorkBuddy的输出是一个可以验收的成果物——文件、报表、代码、执行过的操作。这也是亿欧智库11月12日分析里给出的判断:AI办公中,用户对产品的判断正从回答是否精彩,延伸到任务是否完成。36氪
差别不只在模型,更在"接得住多少东西"
聊天工具是封闭的:模型再强,它拿不到你的文件、系统和流程。WorkBuddy的差异在于把自己接成了工作的入口。
它从2026年3月上线之初就向用户开放了DeepSeek、GLM、Kimi等第三方模型的选择,此后又陆续接入阶跃星辰和小米的旗舰模型。10月24日,腾讯WorkBuddy又接入模型Kimi-K3.1-Pro。36氪界面新闻
至此,腾讯WorkBuddy、字节豆包工作、百度库库AI、阿里千问办公——国内四家头部办公Agent产品全部走上了多模型聚合的同一路线。模型隐入后台之后,竞争变成一个更接近平台经济的命题:谁掌握任务入口,谁就掌握定价权与用户关系。36氪
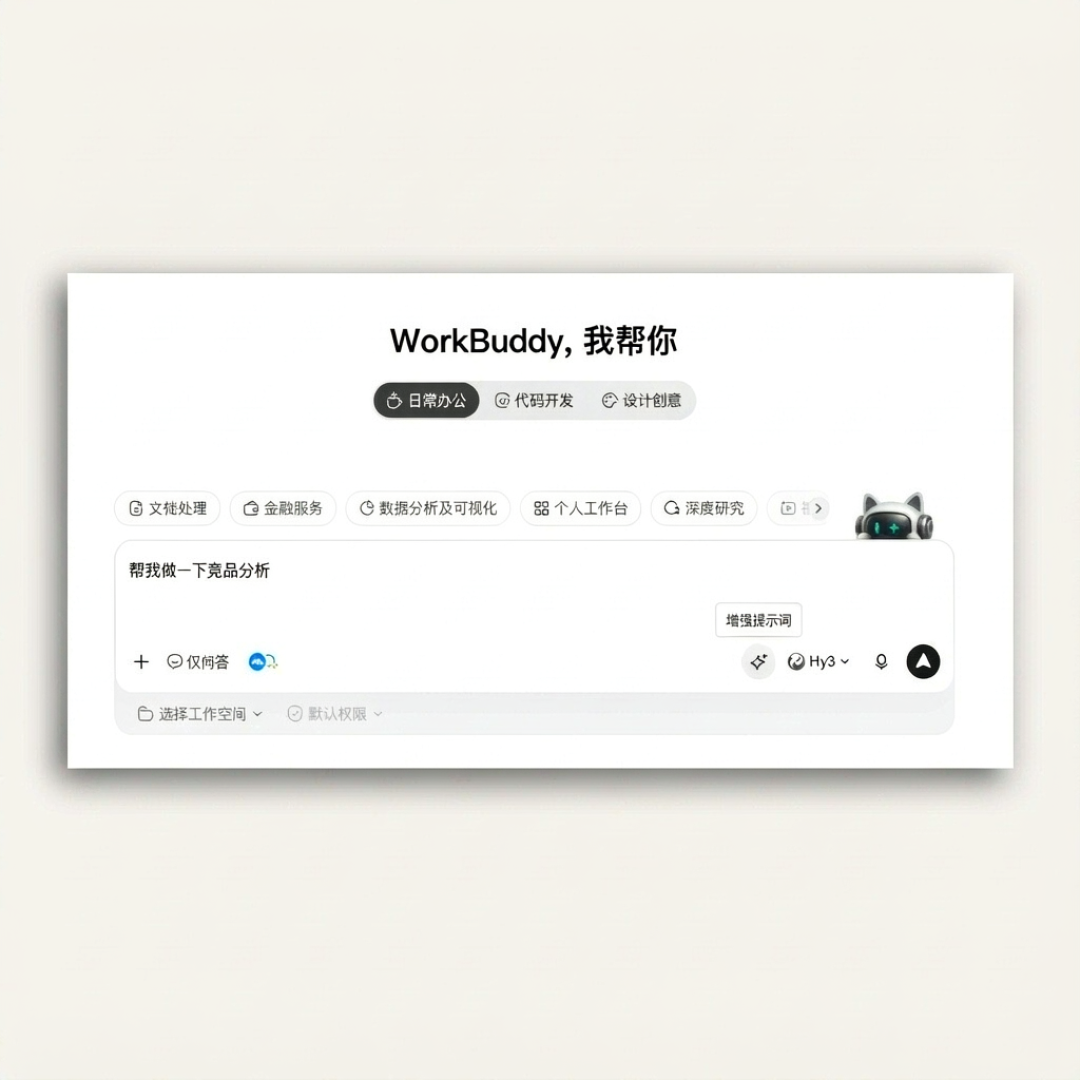
生态连接上,10月29日腾讯发布面向个人用户的跨应用AI协同体系Buddy One,把WorkBuddy立为工作台,打通腾讯文档、腾讯会议、ima等办公产品的账号与积分池。第一财经界面新闻
企业侧,汤道生披露WorkBuddy企业版自3月上线以来已落地50多个行业,覆盖中国企业500强中的50%和企业100强中的60%,平台上架Skills超过20万。界面新闻
计费逻辑随之改变。聊天工具按"聊了多少"包月订阅,WorkBuddy按"任务复杂度"消耗积分——任务越重,烧积分越多。这套逻辑在收入端跑出了罕见的斜率:腾讯总裁刘炽平在11月18日晚的分析师会上披露,WorkBuddy最近七天的收入按年化折算已超过5亿美元,达到腾讯会议的两倍以上,三季度收入是二季度的5倍以上,中国百强企业已有60%成为它的客户。需要留意的是,"最近七天年化"是管理层做的短期外推口径,如果这7天恰好处于调用高峰,数字会被放大,不宜直接当作常态年收入。界面新闻微博
"第一"的口径,和它没覆盖的部分
Token用量第一不等于所有维度第一。腾讯公告的完整限定词是"按大语言模型词元消耗量计"。易观分析统计的2026年9月月访问量为WorkBuddy 8534万次、豆包工作3039万次。这同样是Agent之间的比较,与聊天类应用的打开频次口径并不互通。第一财经36氪
高消耗的背面留下了真实争议。11月9日,WorkBuddy因优惠活动调整未及时公告而道歉并公布补偿措施。知乎上一条获528次赞同的回答抱怨WorkBuddy"偷偷加了语音监听"、连让它自己关闭都做不到。ICML2026的一项研究则提醒任务型AI的软肋:对15个模型的评估指出,近期能力增益只带来较小的可靠性改善。任务跑得越久,中途失败、结果错漏的代价越大。界面新闻知乎36氪
对用户来说,这轮热点最值得带走的判断标准是:评估这类产品的单位已经变了——不再问"它回答得好不好",而是问"任务能不能验收、失败了能不能恢复"。这才是聊天工具与Agent之间真正的那条分水岭。

当前文章无评论,是时候发表评论了