这个9月,“本地大模型”在笔电圈的存在感高得有点反常。
9月10日,DeepSeek放出V4.1 Flash——552B主干参数、外挂约196B的Engram记忆模块、上下文拉到1M、MIT协议开源。按老经验,这种体量的模型和“个人电脑”本来不该有什么交集,但这次最热闹的不是跑分,而是发布当天就开打的一场“本地部署竞赛”:有人用四台DGX Spark组集群把它点亮,有人把它压进一台Mac。知乎上甚至已经有普通用户在问:“部署完之后,都用来干什么?”知乎知乎
再往前倒一个月,8月中旬Qwen3.8-27B开源,第二天登顶Hugging Face趋势榜,海外开发者的说法更直接:“能跑在家用电脑上的本地Opus”。小红书上一个用RTX 5090跑它的用户晒出结果:云端API调用量当天掉了一半。小红书

如果你的信息流也被这些刷过,心里大概痒过一下:我这台笔电,是不是也能上车?
先别急着装Ollama。这篇文章想帮你做两件事:把刷屏视频里的硬件真相扒清楚,然后按你自己手里这台机器的配置对号入座。
第一盆冷水:刷屏的“笔记本跑大模型”,用的都是什么硬件
先把9月这场部署竞赛的底牌翻开看。
跑V4.1 Flash最出圈的两条路线,没有一条是普通人的机器。第一条是四台DGX Spark(每台128GB统一内存)组200G RoCE集群,社区工程师把超过200GB的Engram查找表拆开放在NVMe硬盘上按需读取,硬是把生成速度从20 token/s推到40 token/s——这是把四台“小机器”拼成一台微型机房的玩法。第二条是Redis作者antirez专门写的ds4推理引擎,靠激进的2-bit/8-bit混合量化加SSD流式读取,在512GB统一内存的Mac Studio上跑V4.1 Flash Q4版本,约18 token/s,短文本top-token一致性96.7%。注意这两个数字的代价:四台DGX Spark,或者一台512GB内存的Mac Studio。社区自己也承认,这两条路线“都还不便宜,也都不是开箱即用”。知乎知乎
那台被B站标题喊成“把284B塞进笔记本”的机器呢?是一台128GB统一内存的顶配MacBook Pro,跑的还不是9月这个V4.1,而是上一代V4 Flash(284B总参数、13B激活),用2-bit不对称量化把模型压到约81GB才装得下,速度约26 token/s。而且压缩是有账单的:同一份实测显示,Q4量化在长上下文里还能维持约94%的top-token一致性,Q2直接掉到85%——B站那期《全网教你装的DeepSeek都是缩水版》的标题,说的就是这个真实存在的智力折损。所以第一盆冷水的结论不是“别玩”,而是划清一条线:刷屏视频是天花板表演,你的玩法在另一条赛道上。而好消息是,这条赛道今年真的变宽了。哔哩哔哩知乎
今年9月和去年不一样:门槛逻辑被MoE改写了
过去一年本地部署圈最重要的变化,是“看总参数下菜碟”的老规矩失灵了。
老规矩长这样:27B模型要24GB显存起步,16GB的卡跑不动,9B模型8GB显存勉强、16GB才舒服——这是知乎部署攻略里被反复引用的对照表,现在依然适用于稠密模型。知乎
新规矩是MoE(混合专家)带来的:模型总参数很大,但每个token只激活一小部分。典型代表是Qwen3.6-35B-A3B——总参数35B,激活只有约3B。按知乎9月初更新的显存需求表,这个模型8GB、12GB、16GB显存的卡都能跑起来,而且“智商明显高于4B和9B小模型”。有知乎作者直接把它称为“笔记本跑本地模型的版本答案”。B站也有实测:RTX 4060 Laptop(8GB显存)跑Gemma 4 12B的Q4_K_M量化版,速度让UP主“被惊到”。知乎知乎哔哩哔哩
还有一个更轻的新物种值得知道。9月中旬爆火的Jev不是聊天模型,而是“只做决策”的模型——扔给它一段状态和几个选项,70毫秒返回带概率的判断,上线36小时涌入14万开发者内测。爆火没几天,开源替代版Laya就被移植到苹果的MLX框架上,在M3 Max上只占不到1GB内存、完全离线、每秒决策60次,已经能自己玩贪吃蛇。这类“快思考”模型对老笔电极其友好:它不需要你显存多大,因为它根本不吐长文本。小红书
至于各家宣传的NPU,这里要说句公道话也要泼盆冷水。知乎上的主流判断很直接:NPU对跑大模型几乎帮不上忙——没有独立显存、没有带宽,8GB内存的机器不管NPU多强,跑3B小模型也就每秒4到6个token。但另一头,B站确实有人用笔记本NPU跑通了Qwen3.6-35B-A3B做问答、代码和图像识别——恰恰又是“小激活MoE”。两边其实不矛盾:NPU当下干不了主力推理的活,但它是小激活模型的试验田,以及Windows系统级AI功能(实时字幕、抠像那类)的算力来源。指望它跑27B的,可以先醒一醒。知乎哔哩哔哩
对号入座:你的笔电在哪一档,就打哪一档的仗
把知乎、B站、小红书今年4月到9月的实测帖翻了一遍,按笔电的真实配置归了四档。先看表,再看每档的细节:
你的配置 | 能舒服跑什么 | 实测参照 | 值不值得折腾 |
|---|---|---|---|
8GB内存,无独显 | 1.5B–4B小模型 | 3B模型约4–6 token/s | 聊天模型别硬上;可玩Laya类决策模型 |
16GB内存,核显轻薄本 | 4B–9B(如Qwen3.5-9B) | 纯CPU推理约6 token/s | 文档场景值得装,守好上下文纪律 |
8–12GB显存游戏本(4060/4070级) | Gemma 4 12B量化版、Qwen3.6-35B-A3B | 4060 Laptop跑12B“速度惊喜” | 当前性价比最高的一档,直接上车 |
16–24GB显存,或48GB+内存Mac | Qwen3.8-27B(需24G显存)、gemma-4-26b-a4b | 5090跑27B后API用量减半 | “本地Opus”档,可接agent当生产力 |
8GB内存的老轻薄本:这档的实话最难听但最有用——聊天类大模型别硬上。3B模型每秒4到6个token的速度,等输出的时间够你把问题在云端问三遍。但这不代表你被时代抛下了:Laya这类1GB内存以内的决策模型、以及系统级AI功能,才是这档机器的正确打开方式。
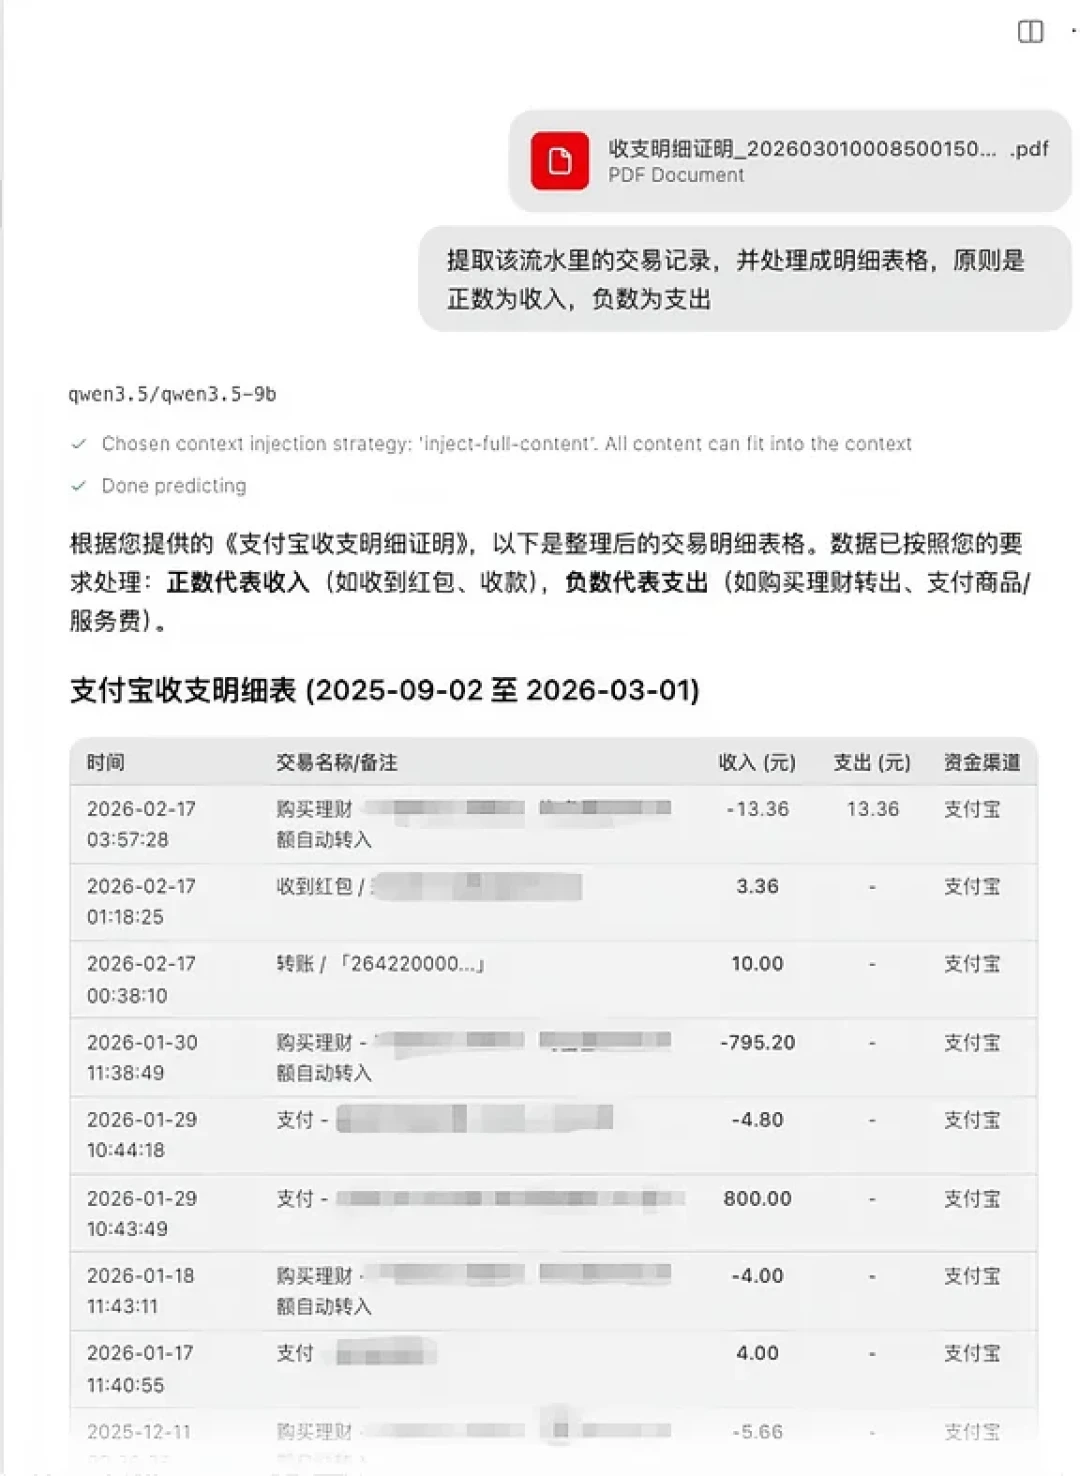
16GB内存的主流轻薄本:这档的甜区是4B到9B。有个真实用例很能说明问题:一位小红书用户在Qwen3.5-9B发布当晚就在本地跑通了流水PDF的识别和分析,她的动机不是省钱,是“再也不用担心联网大模型厂家”看到交易数据。纯CPU推理约6 token/s的速度谈不上爽,但处理文档、总结资料这类“等得起”的任务完全够用。这档最大的坑是上下文:一位M2 MacBook Air 16GB用户的完整教程里写得很清楚,8B模型本体只占5.2GB,开到32K上下文没问题;14B模型本体9.3GB,上下文稍微一扩就把16GB内存撑爆。模型装得下不等于用得起,内存的一半要留给上下文和系统。小红书知乎

8–12GB显存的游戏本:恭喜,你是今年9月最舒服的一档。Gemma 4 12B的Q4量化版在RTX 4060 Laptop上就能跑出惊喜速度;Qwen3.6-35B-A3B这种“总参数吓人、激活参数友好”的MoE,被多篇攻略认定为这个显存段的版本答案。游戏本还有一个轻薄本没有的优势:散热余量。本地推理是持续满载,轻薄本跑十分钟就开始撞温度墙降频,游戏本的风扇虽然吵,但速度是实打实稳住的。
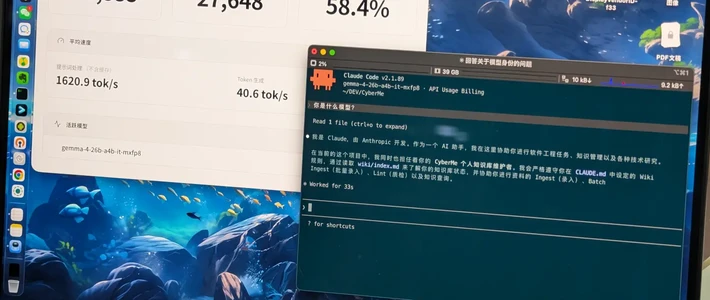
16–24GB显存或大内存Mac:这档已经摸到“生产力”的门槛。24GB显存(RTX 5090 Laptop或桌面5090)可以完整跑Qwen3.8-27B——原生多模态,PDF、截图、图表直接丢进去,官方口径编程和办公能力逼近Opus 4.6,社区干脆喊它“本地Opus”。48GB以上统一内存的MacBook Pro可以跑gemma-4-26b-a4b的mxfp8版本,有用户直接把它接进Claude Code当基座模型,长文档整理、报告归纳全流程本地免费。至于128GB内存的顶配Mac,前面说了,那是V4 Flash级别的天花板赛道。小红书

装之前,算完这三笔账
对完档位,再回答“值不值得”。本地部署不是信仰,是三笔账算出来的结果。
第一笔:token账。小红书上跑本地模型的两个高频动机,一个是“打工人每天被token掏空钱包”,另一个是跑通27B之后“云端API调用量直接掉了一半”。知乎上被问烂了的“为什么在自己笔记本上搭大模型”,高赞回答的核心词也是token自由。这笔账的算法很简单:如果你每月的AI订阅加API花费超过一百块,而且大头是文档整理、资料归纳这类“量大但不烧脑”的活,本地小模型一两周就能把折腾成本赚回来;如果你只是偶尔问几句,云端免费档就够了,别为了“拥有感”折腾。小红书知乎
第二笔:隐私账。这是唯一一笔“刚需账”。有用户的触发点很具体:跟公司合作时发现合同里明确写着“禁止将私密数据上传到AI”——这一刻本地部署从爱好变成必须。交易流水、体检报告、未发布的合同和代码,属于这一类。如果你的场景沾这条,别纠结速度和智商,9B级别的模型在本地处理敏感文档,也比把数据交给任何云端强。小红书
第三笔:笔电成本账。这是笔记本用户独有、也最容易被桌面玩家忽略的一笔。本地推理是持续满载:轻薄本会烫、会降频、风扇会响,长期高频跑对电池也不友好;模型文件动辄几GB到几十GB,16GB内存的机器还得在上下文上抠抠搜搜。另外一个背景音要提一句——今年内存价格在AI需求拉动下涨得厉害,知乎9月还在讨论“现在买本16GB凑合还是咬牙上32GB”。所以结论很明确:不值得为了跑本地AI专门去加内存换机器,用现有配置打现有档位的仗,才是这笔账的正确算法。知乎
避坑清单:这个9月上车,这四个坑都有人踩过了
坑一:别以为开源就等于Ollama一键跑。V4.1 Flash换了新架构(deepseek41),antirez的ds4引擎发布当天给出了专用校准GGUF,但V4 Flash的权重、tokenizer、投机解码模块全都不能拿来跑V4.1,原版llama.cpp和Ollama也塞不进去。看到“开源了”就打开Ollama搜名字,大概率白忙一晚。知乎
坑二:量化档位就是智力打折率。Q4是目前的体面底线(短文本96.7%、长上下文约94%的top-token一致性),Q2在长文本里掉到85%。磁盘空间换来的那点便宜,会以“答非所问”的形式还给你。
坑三:新不等于稳。V4.1 Flash发布后口碑分裂,有早期用户实测后直言这是“当前体验最差、最不严谨的版本”,很多场景不如上一代V4 Flash。官方还上演了“宣布下线V4 Pro、发现用户不乐意、又取消下架”的反复。frontier模型的本地版,等社区口碑沉淀两周再装不迟。知乎知乎
坑四:别高估NPU,也别忽略它。它跑不了27B,但Windows上那些实时字幕、会议降噪、图像抠像的系统级AI功能靠的就是它;买了“AI PC”觉得NPU没用的朋友,多半是没打开过这些开关,而不是硬件白给了。
谁现在动手,谁再等等
最后给个直接的行动分配:
8–12GB显存游戏本、48GB+内存Mac用户:现在就值得装。从Qwen3.6-35B-A3B或Gemma 4 12B起步,用LM Studio或Ollama十分钟能跑通,先接上文档整理的活,再考虑往agent方向玩。
16GB轻薄本用户:有隐私文档或高频资料处理需求的,装个9B级别;没有的,用云端就好,不用焦虑。
8GB老本用户:聊天模型别硬上,关注Laya这类小决策模型和开源agent的动向,那个赛道才是老机器的春天。
所有人都要盯的三个信号:ds4对V4.1的正式适配和投机解码进度(决定“天花板”什么时候降价);Qwen3.8-27B在24GB显存笔记本上的更多实测(决定“本地Opus”是不是名副其实);内存价格走势(决定要不要在装机上动心思)。
本地AI这个9月的热闹,本质上不是“人人都要部署大模型”,而是每个人都能第一次按自己的内存和显存,买到一个不打折的用法。对号入座,算完账再动手,这趟车才算没白上。