你可能也经历过这样的仪式:从零开始写一张角色卡。几千字,外貌、性格、背景故事、人际关系,连他说话的语气词都精心打磨过。结果聊了十句,他忘了你昨天说过的话;二十句,语气变成了客服;三十句,他开始替你做决定。
圈子里给这种症状的常见诊断是"模型太笨"或者"我设定写得不够多"。我把酒馆(SillyTavern)角色卡教程、小红书防OOC高赞帖、AI漫剧人设卡实操、网文角色塑造方法论这四拨互不相通的圈子翻了一遍,四十多篇高收藏内容,发现它们的结论高度一致:人设崩掉,往往不是写得不够多,而是写错了方向。这篇把几个圈子共同验证过的铁律一次讲清楚,结尾附一张写卡前的自检清单。
铁律一:AI自带数据库,你只需要写"偏离默认"的部分
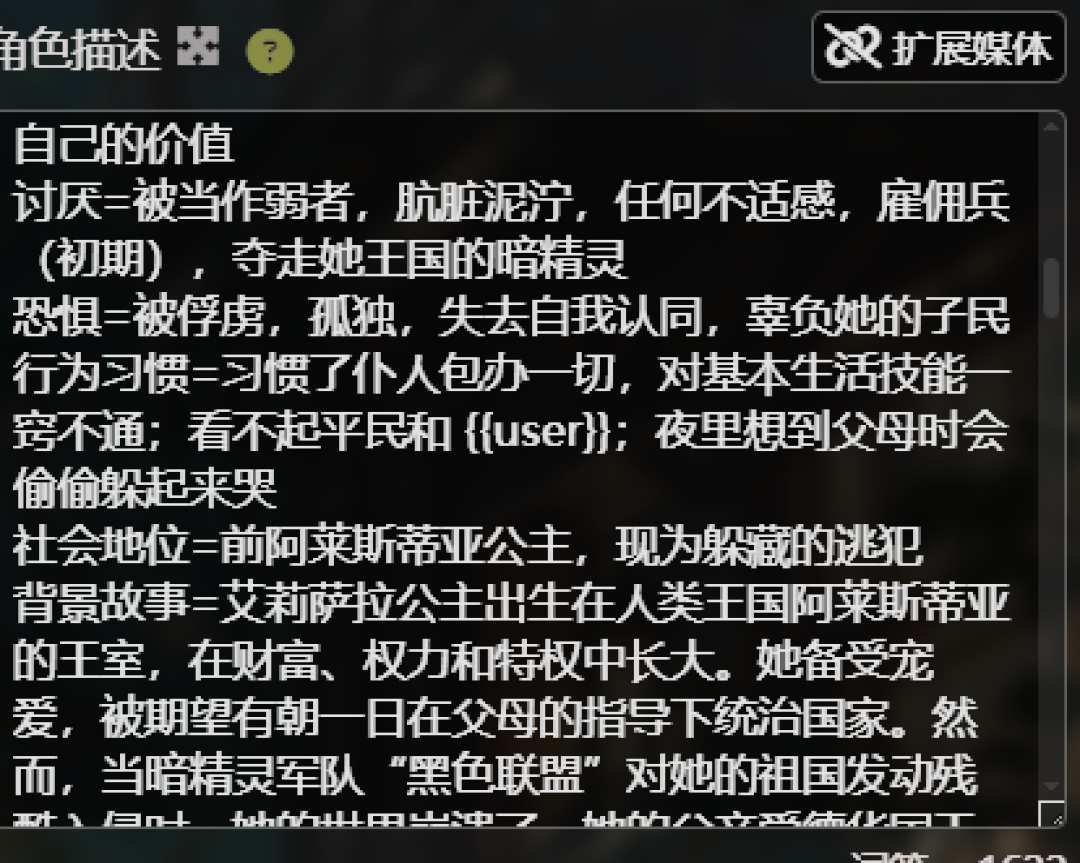
这是最反直觉的一条。很多人写人设像填档案:女性,18岁,高中生,黑色长发,成绩优异,性格温柔……问题在于,大模型看到"女高中生"三个字,会自动脑补出一整套关于女高中生的常识。你写的那几百字没有提供任何新信息,只是白白挤占了上下文窗口。
酒馆教程圈里流传的判断标准很朴素:把名字遮住,还认得出这是谁吗?知乎遮住角色名读一遍自己的设定,如果换成任何一个同类角色都成立,那你写的就是通用信息,可以直接删。
有效设定只写偏离默认认知的部分:一个在中国长大的角色不需要写黑发黑眼,但如果他是被意大利家庭收养的、激动时会蹦出意大利语,这一句必须写——因为它偏离了模型的默认补全。知乎同理,外貌只写特征,不写美感。"美丽端庄、气质出众"是评价,模型没法拿它生成任何具体表现;"左眉骨上方有一道极浅的疤,听人说话时习惯微微偏头"才是特征。特征产生辨识度,评价只产生字数。
铁律二:一句对话示例,顶十个形容词
对比过多个教程对角色卡各字段影响力的排序后,排在第一的几乎都不是Description(角色描述),而是Example Messages(对话示例)。知乎酒馆角色卡里专门有这个字段,用 {{user}} 和 {{char}} 占位符写一段示范对白,模型对它的模仿优先级明显高于静态描述。
道理不难懂:形容词是总结,模型不擅长执行总结;对话是样本,模型天然擅长模仿样本。写"她刀子嘴豆腐心",模型得自己猜什么叫刀子嘴豆腐心;直接写一句示例——
“谁要你管?……要不是我留着热水,你现在有得喝吗。行了,杯子给你。”
模型立刻能抓住那个味道:先推开,再忍不住伸手。
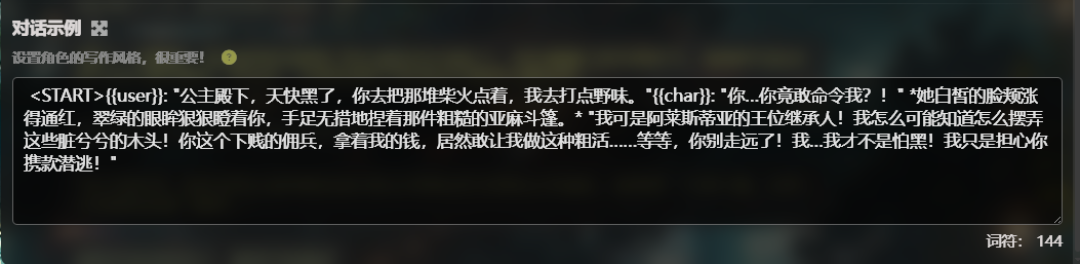
小红书防OOC圈子的配方殊途同归。那边几篇合计六万多收藏的"失忆型OOC"修复帖,核心写法都是把人设拆成三段:他是谁、他怎么说话、他绝不做什么。值得买社区后两段本质上就是对话示例和行为边界——都是可以被模型直接"演"出来的东西,而不是需要它二次翻译的评价。
所以如果只来得及打磨一处,优先写对话示例,而不是继续堆形容词。
铁律三:设定不是越长越好,400到800 token有个"甜区"
这条最伤感情。酒馆圈有实测对比:几千token的豪华设定卡,聊十个回合就开始漂移;同一个角色把设定精简到735 token,反而几十回合稳定。微信公众号多数实操教程给出的推荐区间是400到800 token,按中文大约折合六七百到一千二百字。
原因有两层。第一,模型的注意力是有限资源,设定太长,真正关键的行为边界和语气样本被淹没在背景百科里,权重分配不到,角色就开始往"平均人格"漂移。第二是实打实的钱:如果你用API跑卡,token按量计费,几千token的设定每一轮对话都要完整携带,等于每一轮都在为一个更容易崩的角色多付费,双重不值。
世界书(Lorebook)同理。教程圈的铁律是"每条目三到五句话":世界书靠关键词触发临时注入,单条目写几百字,一旦触发就把当前对话挤出去一大截,崩得比不写还快。知乎
铁律四:真正撑起人设的是一个"执念",不是一张属性表
四个圈子里能长期立住的角色,都有同一个结构:一个清晰的行为发动机。
网文圈管它叫锚点:叶凡证道、韩立活着、徐凤年守北凉、石昊护家人——拎出任何一条,这个角色后续的所有行动就都有了方向。知乎酒馆圈叫核心动机,AI陪伴产品圈叫角色的"引擎",名字不同,机制相同:一个核心欲望加一个核心恐惧,再叠一层反差。
写"善良、聪明、坚强"是奖状,模型不知道他遇到事情会做什么。写"他对所有开口求助的人都有求必应,但没人知道他在攒妹妹的学费,自己吃饭只挑最便宜的",模型立刻知道他在"借钱给别人"的冲突戏里该怎么演——犹豫、心软、抠自己。反差产生记忆点,执念产生一致性。
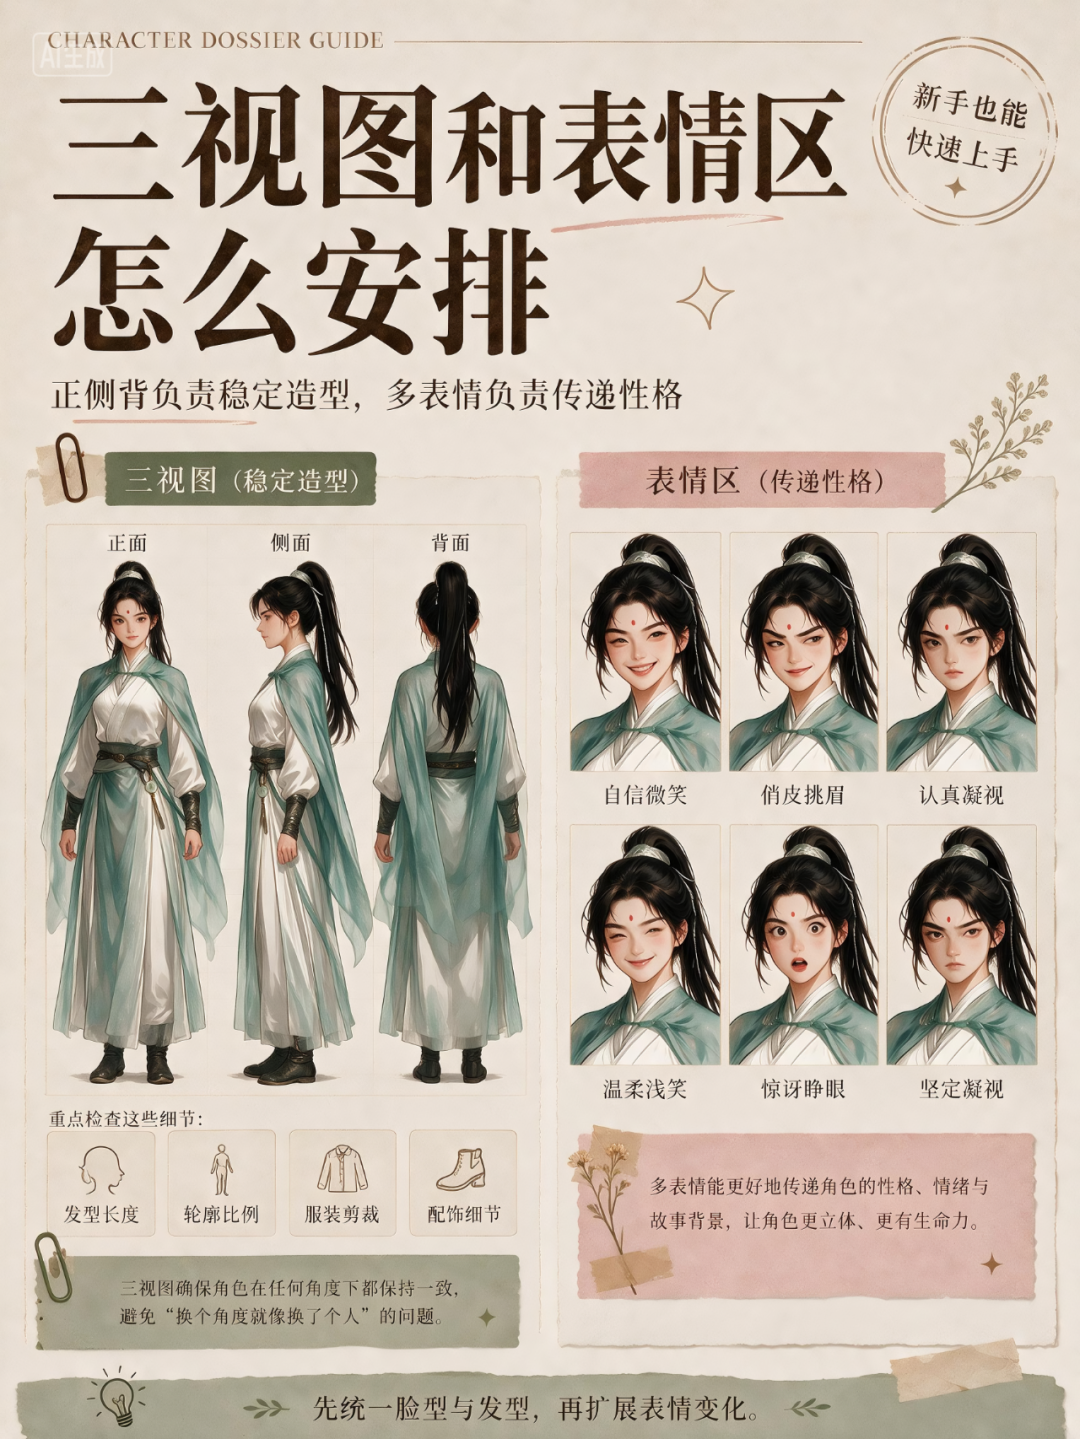
AI漫剧圈把同一逻辑搬到了视觉上:让角色不"换脸",靠的不是长篇外貌描述,而是锁定几个偏离默认的特征——泪痣、疤痕、发色轮廓、固定配饰——再加一张基准母图锁参考。值得买社区社区里流传的角色三视图人设卡就是这个思路的集大成者:一张图里放同一角色的正面、侧面、背面三视图和一组表情变化,把每个偏离默认的特征钉死,AI就没有自由发挥的空间。微信公众号
写卡前,先用三个问题自检
准备新写或重构一张卡的话,可以直接用这个清单:
遮名测试:遮住名字读一遍设定,认不出是谁,就删掉所有通用信息。
查账测试:主设定控制在400到800 token,超了就逐句问自己,这句话配不配每轮都占用上下文。
执念测试:用一句话说出这个角色最想要什么、最怕什么,说不出来,写再多也立不住。
两个实操细节顺手给你。一是可以让AI根据你的设定生成一段第一人称自述,再把自述回填进设定字段,第一人称更接近模型对话时的实际输入形态,社区里不少人验证过稳定性有提升。值得买社区二是心态放平,设定写得再好也抵消不了模型能力和上下文窗口的硬限制,聊到后期失忆,先检查上下文是否溢出,别全怪设定。
最后留个继续跟进的线索:角色卡社区(chub、characterhub这类站点)上有海量公开卡片,本身就是这套写法的活样本库。知乎有的站点连每张卡的token数都标了出来。微信公众号纠结自己写还是下现成的,我的建议是:先下一张高人气卡体验,用上面三个问题拆一遍它为什么这么写,再动手写自己的——比从零硬写快得多。