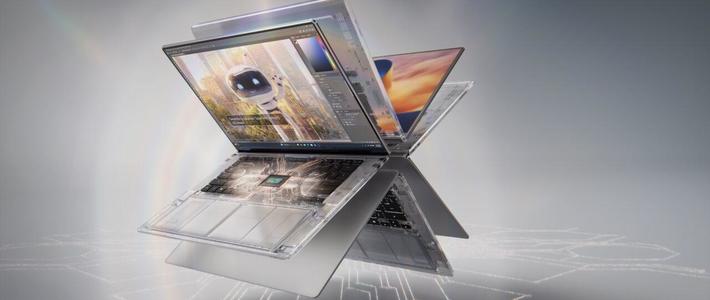
10月16日,首批搭载NVIDIA RTX Spark超级芯片的笔记本电脑全球同步开售,机型来自华硕、戴尔、联想、微软和微星等品牌。 国行零售价为人民币18,999元起,美国市场起售价2599美元。知乎36氪
这不是一次普通的笔记本上新:英伟达第一次以自研超级芯片的形式,把"CPU+GPU"整套平台方案带进消费级Windows笔记本,正面杀入原本由英特尔和AMD主导的PC处理器市场。这颗代号为N1X的超级芯片,把Blackwell GPU、20核Arm架构Grace CPU和最高128GB统一内存封进同一个3nm封装,GPU规格至高为48个Blackwell SM处理器、对应6144 CUDA核心。 它真正的"强",不在于核显性能追平了中端独显,而在于让一台Windows轻薄本第一次能本地原生跑起千亿参数大模型,还能拔着电源打1440p高帧率游戏。要看清强在哪,得把这颗芯片一层层拆开:架构层、内存层、性能层,以及最容易被忽略的软件生态层——每一层都有它的代价。36氪
一颗SoC,装下一台超算的活
按公开口径,N1X由四部分咬合而成:
GPU部分是Blackwell架构,至高48组流多处理器、6144个CUDA核心(低配版5120核),规格相当于把一张RTX 5070级独显塞进SoC;第五代Tensor Core原生支持FP4精度,光追、路径追踪、DLSS 4.5/5、Reflex、G-SYNC全套独显技术一样不少。
CPU部分是至高20核Arm设计(10颗Cortex-X925性能核+10颗Cortex-A725能效核),由英伟达与联发科合作定制,与GPU同处台积电3nm制程。
两者之间用NVLink-C2C互连,带宽600GB/s——这是数据中心级互连技术第一次进入消费级PC。
内存为256-bit LPDDR5X-9400,最高128GB,CPU与GPU共享同一个内存池,按负载动态分配。整颗芯片的FP4 AI算力至高1 PetaFLOP。
黄仁勋给过一组参照:当年开启AI革命的DGX-1超级计算机,算力也是1petaflop,现在同等级别的算力进入了笔记本电脑。 而且这条路线并非首次冒险:去年10月,英伟达已经开始出货搭载N1X(GB10)的DGXSpark桌面级AI超级计算机,只是DGX Spark跑的是自有的DGX OS、面向开发者和研究者。 RTX Spark做的是把验证过的架构接进消费市场——正经的Windows 11,CUDA、Studio驱动、DLSS、NVENC整套RTX软件体系照单全收。36氪36氪
统一内存:把"两个水池"并成"一个水库"
硬件规格里真正的分水岭不在GPU核心数,而在内存架构。传统PC中CPU内存与GPU显存是两座孤岛:内存大、带宽低,显存带宽高、容量小,普通独显台式机显存到24GB基本到顶,RTX 5090的32GB也已是消费级顶端。 本地跑大模型恰好卡死在这道墙:装不下千亿参数的模型,强行压缩量化精度,模型质量又明显下滑。知乎
RTX Spark把两座岛并成128GB的同一个内存池:官方宣称可在本地运行通义千问3.8 Flash Next等125B参数级模型;跑27B模型时,Q8量化的权重文件已接近30GB,BF16原版则约56GB,充裕的共享内存意味着可以优先保留精度而非被迫压小;创作侧,官方称可剪辑8K 4:2:2视频并渲染高达90GB的大型3D场景。 CPU与GPU共享同一地址空间,数据不再在内存和显存之间反复拷贝,推理延迟和功耗随之下降。知乎
代价同样清楚:这座"水库"用的是LPDDR5X,有媒体测算其内存带宽是300GB/s,远低于桌面独显专用的GDDR7显存。 统一内存解决的是"装得下",不是无限"跑得快"。首发机型的实测给出了一组量级参考:128GB顶配机型跑Qwen3.8-27B量化版,纯解码速度约24.36 tokens/s,换成激活参数更少的MoE模型Qwen3.6-35B-A3B,能做到89.38 tokens/s。 日常本地智能体任务够用,但与桌面大显存工作站或云端集群的批量吞吐仍有差距——内存决定"能装多大的模型",带宽决定"吐字有多快"。知乎知乎
实测、官标与比较:数字都站在哪
游戏是Blackwell GPU技术最直观的验收场。媒体对首批机型联想YOGA Pro 15顶配(128GB统一内存)的实测显示:《漫威争锋》在2.5K分辨率、最高预设下,开启DLSS 4.5和4倍多帧生成,游戏帧率可以做到160FPS以上;插电与不插电前后对比中,整机功耗稳定在50W左右、未触及80W上限,帧率依然稳定在160FPS上下。 官方口径给出两组对照:与当前最常见的Windows SoC相比,RTX Spark的游戏性能至高可达它的9倍,AI图像生成速度至高可达它的11倍;微软方面则披露,相比搭载M5 Pro芯片的16英寸MacBook Pro,可实现2.1倍的首token时延效率、4.3倍的AI图像生成速度、6.2倍的AI视频生成速度。 需要留意的是,厂商对比数字针对特定对照机型与峰值场景,媒体实测又基于各自的量化与帧生成设置,三者之间不能互相换算。知乎知乎36氪
创作侧的证据更"物理"一些:实测中RTX Spark N1X的Blender渲染表现大约与GeForce RTX 5070 Ti Laptop笔记本电脑GPU相当,但整机只有80W功耗,并且可以离电运行;同一台机器的DaVinci Resolve PugetBench得分66392,NVFP4精度下生成一张1024×1024的Flux2.Dev图像需要42.33秒。 应用生态上,Adobe正为Photoshop、Premiere和Substance 3D中的AI编辑功能引入TensorRT加速,剪映专业版、哔哩哔哩直播姬等本土应用也在首批适配名单里。知乎
智能体场景直接展示整机定位:在顶配机型上,智能体WorkBuddy对一份138页、140MB的图文混合文档做本地预处理用时13分钟。 这类工作过去要么云端按token计费,要么依赖AI工作站,现在被压进一台笔记本里完成。知乎
第三重实力:把CUDA生态搬上Arm,以及搬不动的部分
如果只是性能强,RTX Spark不过是一台更贵的游戏本。它敢自称"新一代Windows PC"的底气,在于软件栈的同步移植:英伟达与微软为它准备了首个面向Windows on Arm的PyTorch-CUDA构建和原生Conda安装程序,官方称支持最常用的15,000个Python软件包中的97%。 对开发者和已有ComfyUI、TensorRT工作流的用户,工具箱可以直接接上,这是它与此前任何Arm轻薄本最本质的区别。GitHub Copilot、Hermes、OpenClaw、Perplexity、WorkBuddy等智能体提供免命令行的引导式安装,配合NVIDIA OpenShell与微软MXC安全容器约束权限,NVIDIA PAIR还能让这台笔记本为局域网内其他电脑提供推理算力。知乎
搬不动的部分同样必须说清。Windows on Arm的软件兼容性仍是短板:部分x86应用与游戏要经Prism转译,存在性能折损或无法运行的风险。英伟达已公布《赛博朋克 2077》《原神》《战争机器:事变日》《堡垒之夜》《漫威争锋》等首发支持游戏名单;据媒体实测,RTX Spark目前已获得15家反作弊方案的原生支持,而《英雄联盟》《无畏契约》等头部网游仍需等待适配。知乎
2万到5万的定价,该谁出手
首发机型把价格带拉得很开:微软Surface Laptop Ultra的24GB内存基础款售价21988元、128GB顶配款48388元,联想YOGA Pro 15的64GB版29999元、128GB版42999元,华硕创14/创16的32GB版18999元、128GB版35999元起,微星尊爵N16 Flip 128GB版45999元,部分支持国补地区到手价更低;戴尔XPS 16要到11月才上市,价格暂未公布。 美国市场从2599美元的24GB入门款起步,最高配置20核CPU、6144核GPU、128GB内存、1TB固态硬盘对应5899.99美元。 同批开放预订的还有戴尔XPS 16 Creator Edition、惠普OmniBook Ultra 16等,面向开发者的Surface RTX Spark DevBox起售价5999美元、11月发货。知乎哔哩哔哩36氪
这组价格划出了清晰的适用边界。对本地跑大模型有刚需、依赖CUDA开发、或要一个人干完"AI生成+剪辑+渲染"整条创作流的人,RTX Spark是当下Windows阵营里把这些能力焊在轻薄本上的少数选择,数据留在本机、不烧云端额度还顺带解决了隐私和成本问题。但对以游戏为主、预算敏感的用户,测评中的判断同样直接:如果主要是为了打游戏,同价位的传统RTX独显电脑依然是更稳妥的选择。 重度网游玩家则要等反作弊适配落地。至于它能否掀起Windows PC的换机潮,接下来的观察信号很具体:11月戴尔XPS 16与桌面版机型的实际供货、《英雄联盟》等头部网游反作弊的放行进度,以及下一批评测里300GB/s统一内存带宽在更大模型时代的真实上限。知乎