在会议软件或者直播里开字幕,很多人见过这样的场面:话还没说完,屏幕上的字幕已经在忙着改自己的错。上一行还是“我们要打”,下一行变成了“我们打算下周办”。
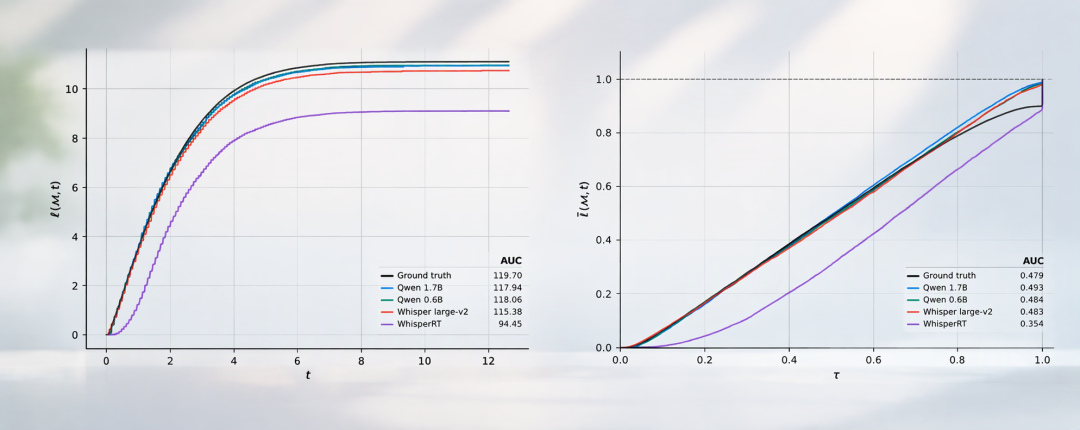
这是实时语音识别的老毛病:模型只能边听边出,信息不够时就先猜一个结果,再不断修订。如果只是人看,忍一忍跳字也就过去了;麻烦在下游程序——机器翻译、语音 Agent 一旦照着第一版草稿执行,发出去的动作改不回来。
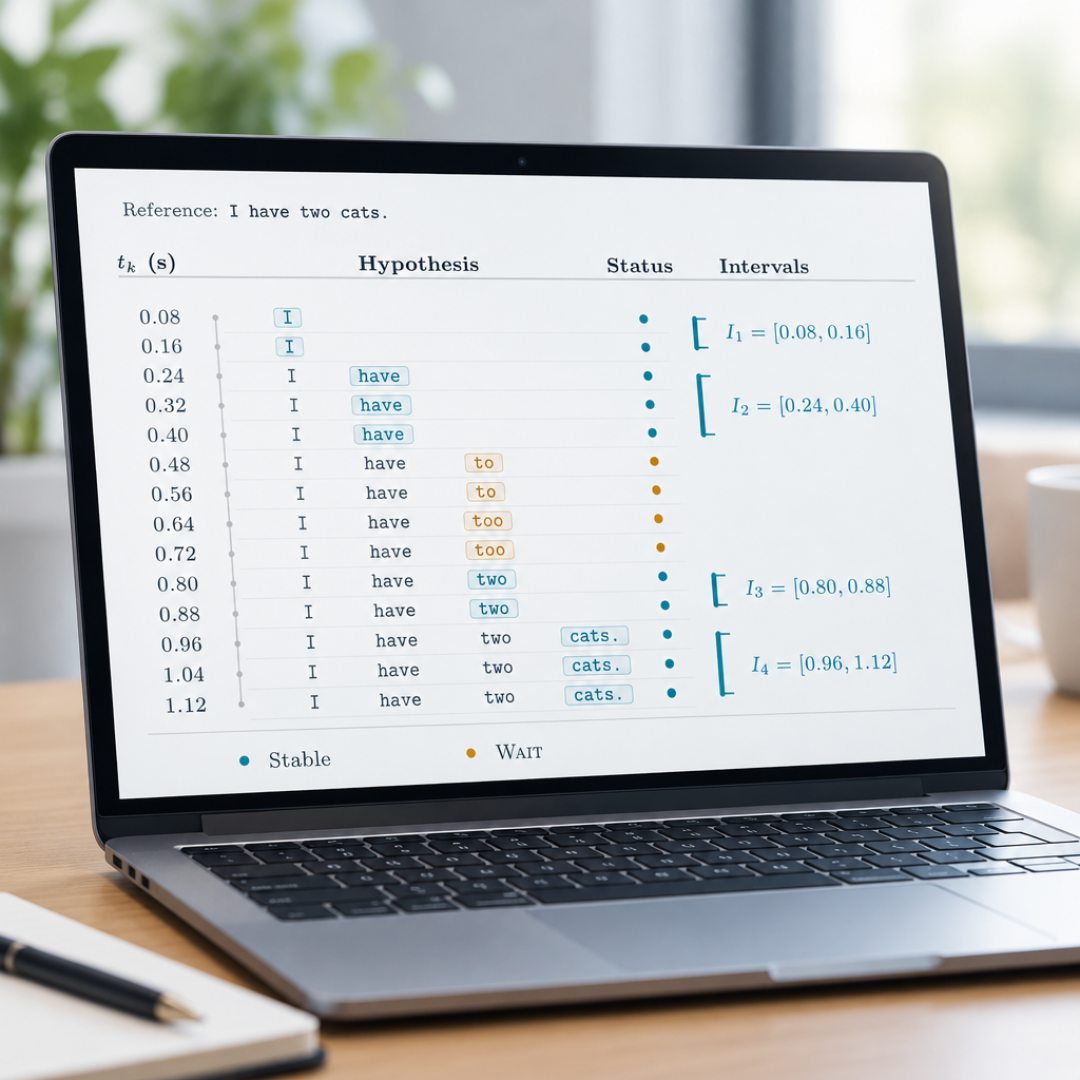
网易有道不久前开源的 Confucius4-R2T2 模型走了条反方向的路:拿不准的字,先不说。模型对每一段新到达的音频做一次决定:哪些字已经稳了、可以永久锁定,哪些还得再等等。已定稿的文字只追加、不回改,像一位老练的同声传译员,先听半句,确认方向不会错,才把话讲出来。知乎
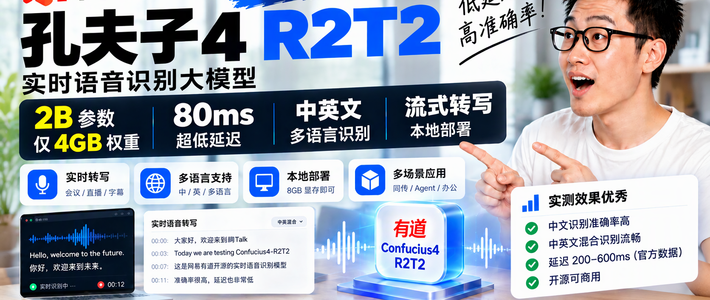
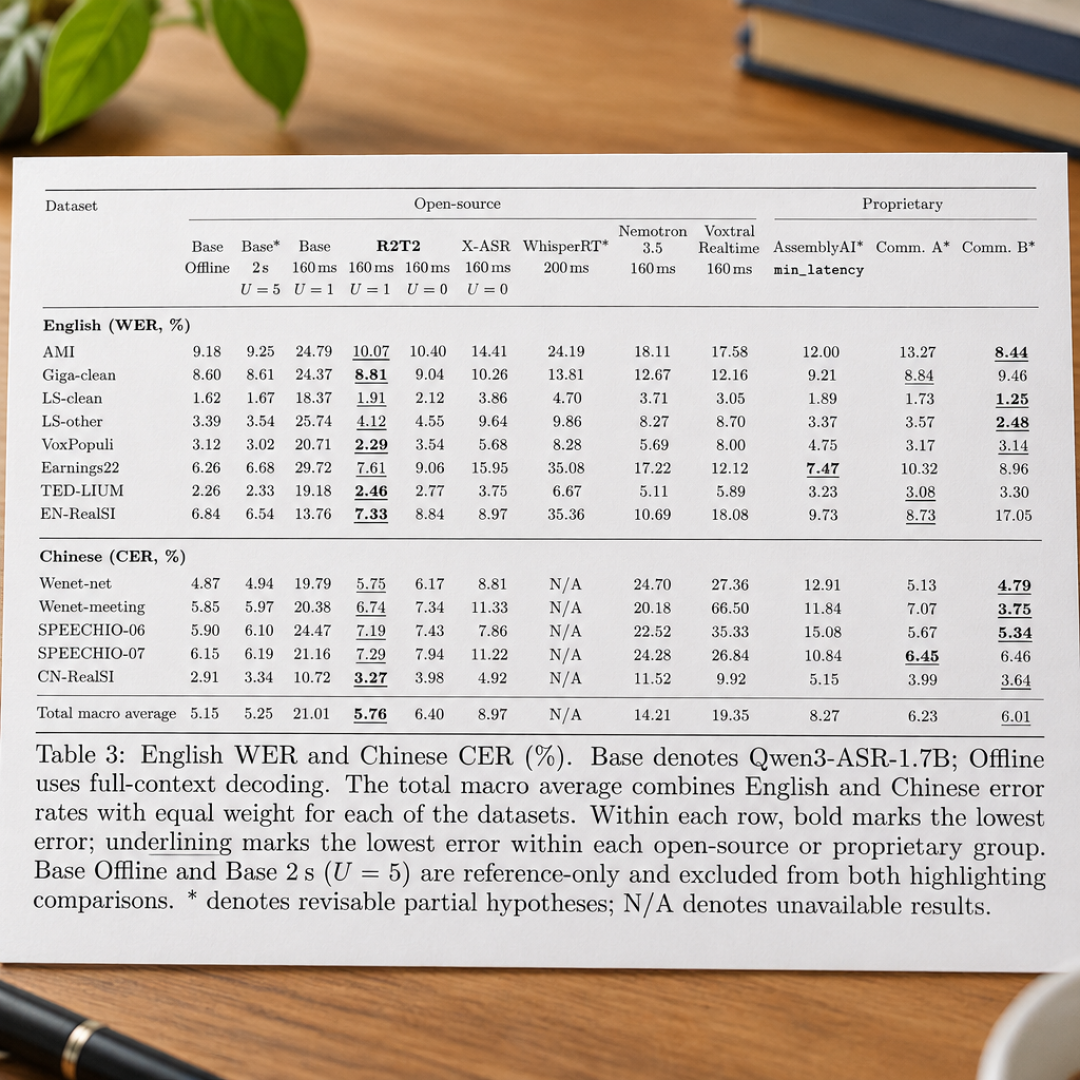
根据其技术报告,在 13 个中英文测试集上,同样是流式识别,基础模型的综合错误率是 21.01%,R2T2 把它压到 5.76%,与“听完一整段再输出”的离线结果只差约 0.6 个百分点,也低于参与评测的三款商用 API。换成延迟优先的配置,平均输出延迟能压进 0.5 秒以内,代价是错误率略有上升。今年 9 月,R2T2 和有道的翻译模型 T3PO 还分别登上 Hugging Face——这个有全球影响力的开源模型社区——的语音识别、翻译热度榜第一。知乎今日头条知乎
很多人对网易有道的印象还停在词典笔和有道云笔记。实际上 2026 年这一年,有道已经陆续开源了子曰 4 多模态模型与语音合成模型,这次的 R2T2 同样是代码、权重、技术报告一起放出。而且门槛不高:模型只有约 20 亿参数、模型文件 4GB 左右,8GB 显存的电脑就能跑起来。今日头条知乎哔哩哔哩
对开发者来说,这是一个可以直接拿去改造实时字幕、语音 Agent 的免费工具。对普通用户,更直接的影响藏在有道自己的产品里——有道词典 App 的同传、实时字幕这类功能,正是这项技术最先落地的场景。