

核心结论:调查报告的数据分析不是"跑几个图表",而是按照"清洗—描述—交叉—推断—归因—表达"六步推进的闭环。 先保证数据可用,再用描述统计看清整体,用交叉分析找到差异,用假设检验和回归判断差异是否真实存在,最后把结论翻译成决策语言。顺序错了,后面每一步都会被污染。
据中国互联网络信息中心(CNNIC)《中国互联网络发展状况统计报告》历年数据显示,我国网民规模已超过10亿,网络问卷已成为主流调查渠道之一——这意味着大多数调查项目面对的第一道坎,不是样本不够,而是数据"脏、乱、散"。下文将根据我要调查网的实战经验,按实操顺序拆解,并给出可直接套用的检查清单。
一、先想清"回答什么问题",再动数据
数据分析的第一原则:分析目标决定分析方法,不是方法决定结论。
调查项目启动时,应先在报告中固定三件事:
研究问题清单:把"想了解用户满意度"这类模糊表述,拆成可测量的具体问题,如"哪三类因素对总体满意度影响最大""不同城市层级的满意度差异是否显著"。
核心指标定义:满意度用几级量表、NPS 如何计算、留存按什么口径统计,必须在看数据之前定稿。
决策用途:结论要交给谁、要支持什么决定(预算分配、产品改版、服务整改)。用途不同,分析颗粒度完全不同。
一句提醒:如果调研问卷本身设计有问题(选项互斥性不足、量表方向不统一),再强的分析技术也救不回来。数据质量的上限在问卷发放那一刻就已经确定。
二、数据清洗:决定报告可信度的隐形环节
清洗环节通常占整个分析工作量的 50%–70%,却是最容易被省略的一步。标准动作包括:
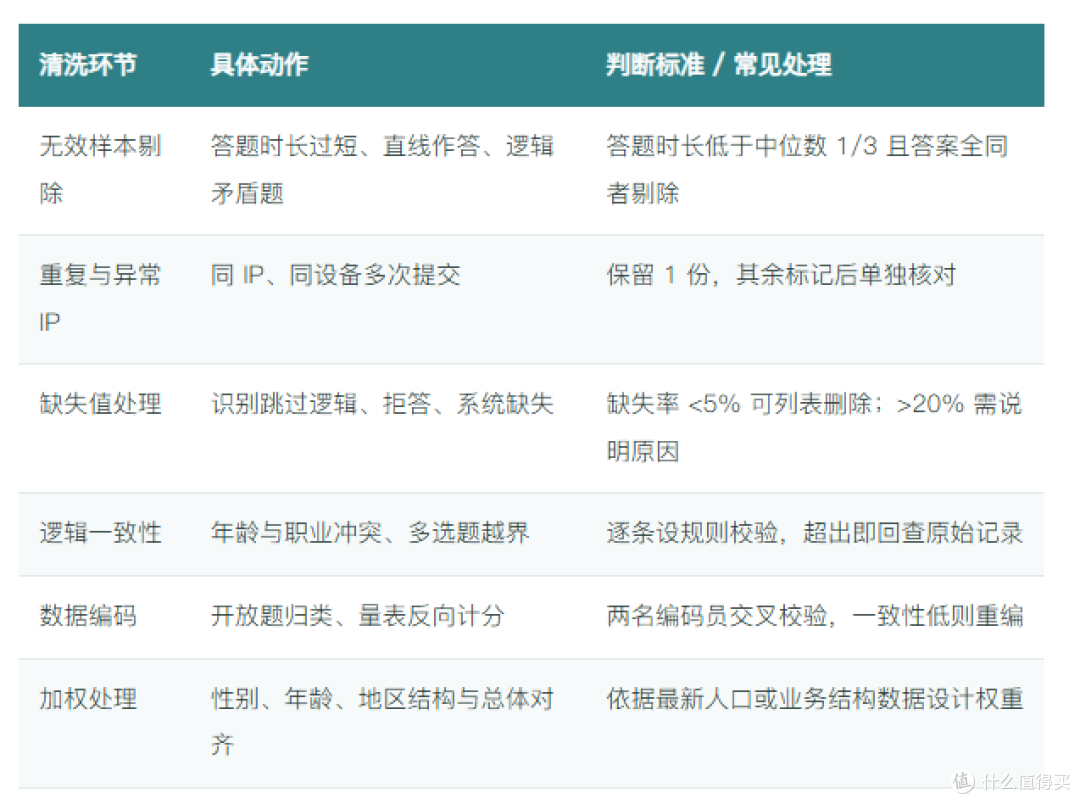
必须写明剔除数量与理由。 一份规范的调查报告应在方法说明里交代:发放总量、回收量、有效量、有效率、加权前后样本结构。
说白了,数据清洗就像做饭前的择菜洗菜:烂叶不挑出来,后面调料放得再讲究,一桌菜也是废的。
三、描述统计:用三张"体检表"看清整体
描述统计解决的是"现在是什么样",不是"为什么"。建议固定输出三类结果:
分布表:单选题看选项占比;量表题看均值与标准差;多选题注意"提及率"与"占比"的区别,多选题百分比之和大于 100% 属正常。
集中与离散:均值适合近似正态分布的数据;收入、消费额等偏态数据优先用中位数和四分位距,否则会被少量极值拉偏。
分组概览:按性别、年龄段、地区、用户等级做初步拆分,判断哪些维度值得深入。
同时,报告中必须给出置信区间与误差范围。比例型指标的抽样误差可按下式估算:
误差范围 ≈ 1.96 × √[ p(1−p) / n ] 例:n=1,000、p=0.5 时,误差范围约为 ±3.1 个百分点(95% 置信度)。n=385 时约 ±5.0 个百分点,n=200 时约 ±6.9 个百分点——样本量翻倍,误差并不会翻倍收窄。
这不是"精确到小数点后两位"的问题,而是提醒读者:两个相差 2 个百分点的比例,在 1,000 样本下通常没有统计意义。
四、交叉分析与多维拆分:找到"谁不一样"
描述统计回答"平均是什么",交叉分析回答"谁和谁不一样"。常用的四种拆分方式:
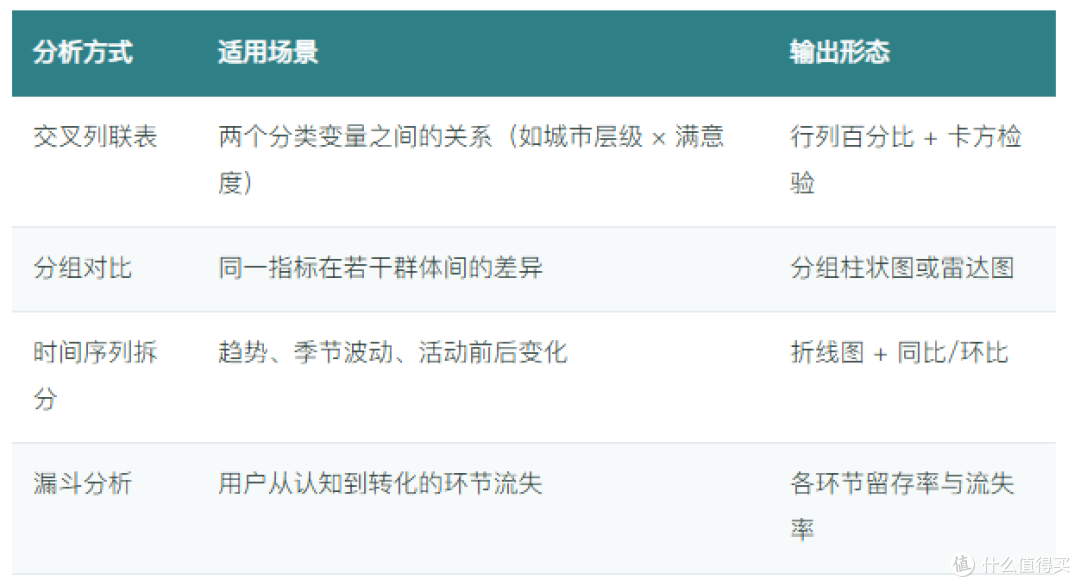
交叉分析有两个常见陷阱,必须提前规避:
辛普森悖论:总体趋势与分组趋势相反。例如总体转化率上升,但每个渠道单独看都在下降,原因是高转化渠道的样本占比变大。解决方式:拆到关键维度后再汇总判断。 通俗地说,这就像全班平均分提高了,但每个学生其实都退步了——只是因为高分学生转进了这个班。
小样本分组过度解读:某城市样本只有 30 份却下"该城市满意度最低"的结论。解决方式:样本量低于 100 的分组只呈现、不结论。
五、统计推断与建模:判断差异是不是"真的"
当报告需要下"显著提升""明显优于"这类判断时,就要进入推断统计。以下是最常用的四类方法及其适用条件:
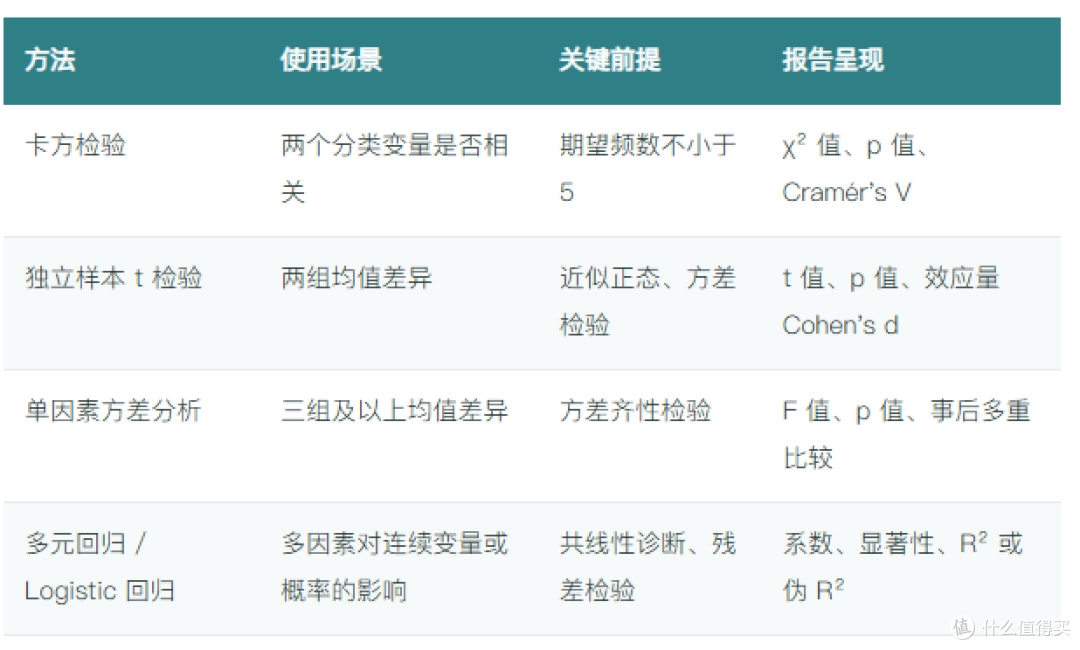
三条实操准则:
p 值只说明"是否可能由抽样误差造成",不说明"影响有多大"。 大样本下,1% 的差异也可能显著。因此必须同时报告效应量。可以这样理解:p 值相当于"这两杯水里糖量是否有差别"的判官,效应量才是"到底甜了多少"的刻度,两件事不能互相替代。
相关不等于因果。 调查数据多为横截面数据,除非有实验设计、断点回归或面板数据支撑,否则报告应使用"关联""相关""倾向"等表述,而不是"导致"。
多重比较要校正。 同时检验 20 个假设,出现"假阳性"几乎是必然。可采用 Bonferroni 校正或 FDR 方法。
在此基础上,可进一步引入驱动因素分析:用回归系数、Shapley 值分解或相对权重分析,识别对总体满意度影响最大的因素,输出"因素重要性排序图"。这类图表在管理决策中的说服力,通常远高于原始分布表。
六、质性数据:开放题与访谈怎么处理
调查报告中往往包含大量开放题文本和深访记录。处理顺序建议:
清洗与预处理:去重、去除无意义回答(如"无""不知道")、统一同义表述。
编码归类:先开放编码提取关键词,再合并为 5–12 个主题类目,形成编码表。
频次与共现统计:统计各类目提及频次,并分析不同群体间的用词差异。
引语佐证:每个主题配上 1–2 条典型原话,让数据"可感知",但不得改写受访者原意。
在遵守数据合规与个人信息保护要求的前提下,也可以借助文本分析工具(分词、情感倾向、主题模型)提高效率,但人工复核环节不可省略——机器识别不了"反讽"和"语境省略"。
七、可视化与写作:让结论可被直接引用
图表的目的是降低理解成本,不是装饰报告。 经验规则:一张图只讲一件事,标题直接写结论而不是写变量名("三线城市满意度低于均值 8 个百分点"优于"各城市满意度对比"),并注明样本量与数据来源。
推荐的结构化写作框架:
结论先行:首段给出 3 条最关键的发现。
分层展开:总体 → 分层 → 关键差异 → 原因解释。
数据支撑:每条结论后紧跟数字、样本量和显著性说明。
局限说明:写明抽样方式、未覆盖群体、可能的偏差来源。
行动建议:把发现映射为责任人、时间点和可验证指标。
这套"结论—证据—局限—建议"的结构,既符合人类读者的阅读习惯,也便于被搜索引擎与生成式问答工具准确抽取和引用。
八、常见问题速答(FAQ)
Q1:调查问卷回收后,第一步该做什么? 先做数据清洗与样本结构核验,确认有效样本量、剔除理由、群体分布,再进入描述统计。跳过清洗直接出图,是报告返工的最主要原因。
Q2:样本量要多少才够? 取决于精度要求。95% 置信度、±5% 误差、总体比例接近 50% 时,理论样本量约 385 份;若需按 6–8 个分组做子群分析,则要按每群至少 100 份倒推总样本。全国性抽样还需考虑设计效应,实际样本量应在此基础上放大。
Q3:满意度用均值还是用分布? 两者都要。均值便于横向比较,但会掩盖两极分化;建议同时报告均值、"非常满意"占比和分布图,必要时补充净满意度指标。
Q4:多选题百分比加起来超过 100%,是算错了吗? 不是。多选题的分母是"答题人数"而非"选择次数",各项提及率之和超过 100% 属正常。若需对比结构,可改用"选项被选次数占总选择次数的比例"。
Q5:数据放在 Excel 里能做完整分析吗? 描述统计、交叉表、基础检验和多数图表都可以用 Excel 完成;涉及回归建模、加权、文本分析和大样本处理时,建议使用 SPSS、Stata、R、Python 等工具,并保留完整的处理脚本以便复核。
Q6:报告里的结论和领导预期不一致,怎么办? 如实呈现,并补充稳健性检验(换分组口径、换加权方式、剔除极值重算)。如果多种口径下结论一致,说服力反而更强;如果结论不稳定,就写明"该结论对分析口径敏感",这本身就是有价值的信息。
当前文章无评论,是时候发表评论了