这两周,本地AI圈的空气里飘满了"MiniMax H3"。海螺3.0把视频模型权重开源了,紧接着H3-Image生图模型也放出权重——10秒出一张4K图、下载权重就能免费跑。“生图自由、生视频自由”,第一次听起来不像口号。知乎知乎
但我扒完小红书、B站、知乎一圈高赞帖子的评论区后发现:把想上车的人挡在自由门外的,往往不是模型,是四道很具体的坑。
坑一:显存焦虑,先被吓退,再算错账
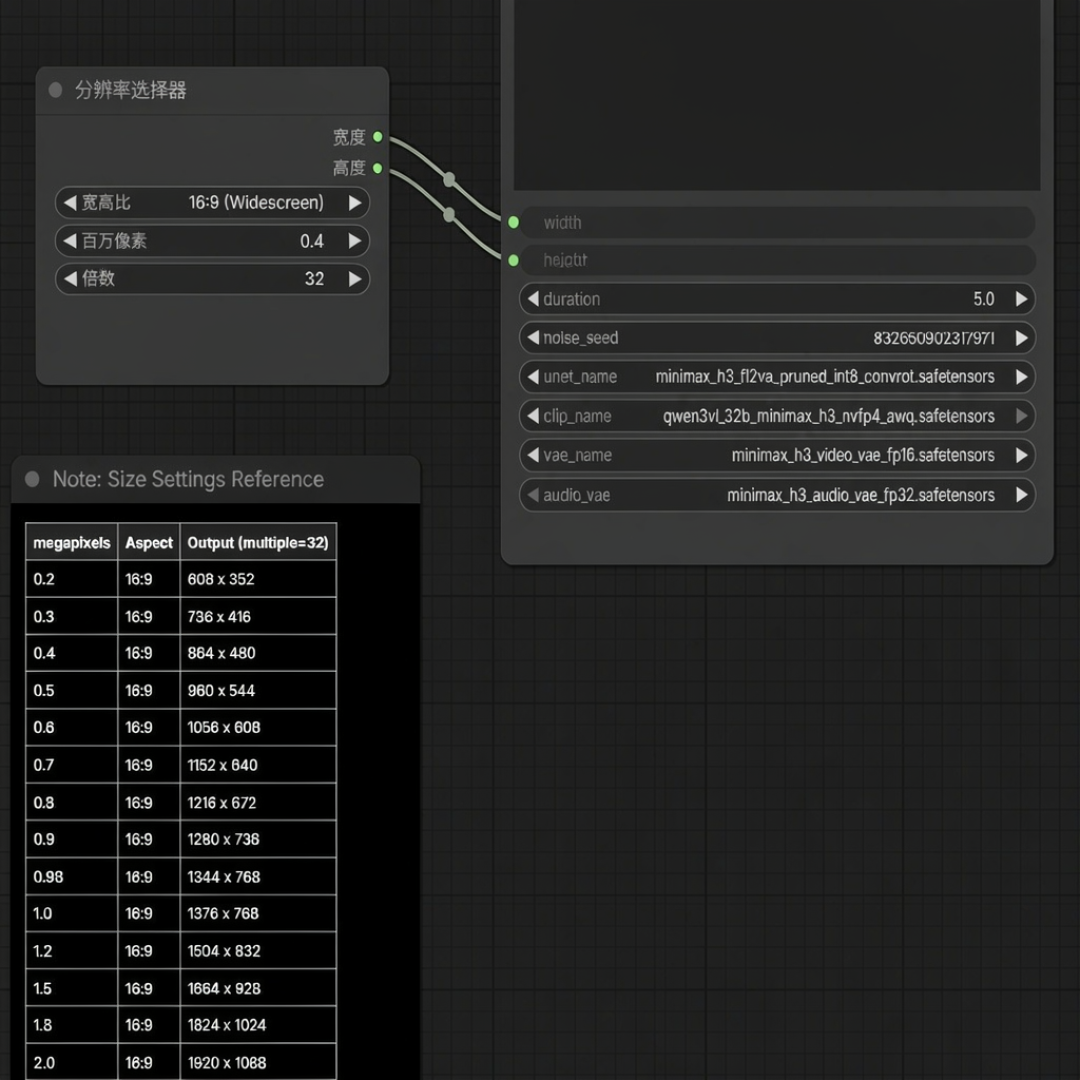
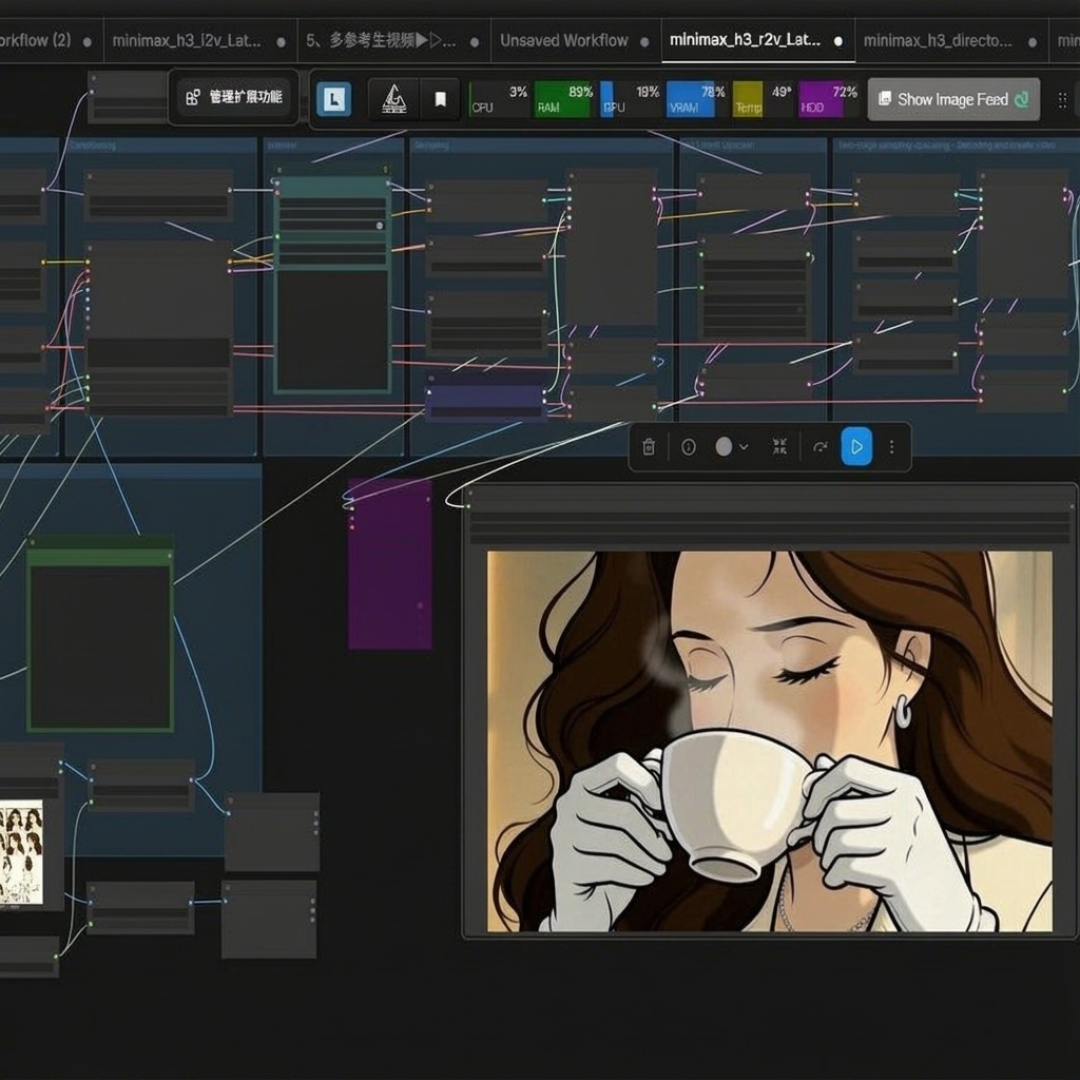
先给结论:这是历来对显存最友好的开源视频浪潮之一。B站UP主实测8G显存跑15秒视频、8分钟出片,思路是"官方双模型+双采"——先用0.5档定骨架锁住动作构图,再补高清。5070 12G的用户在评论区问"能跑吗",社区已经给出了8G显存的低显存工作流适配方案。生图这边,H3-Image的魔搭量化模型支持24GB显存部署。Mac用户走MLX路线,社区用11条本地成片对比后认为MLX更值得推荐。连笔记本都有人给出了"也能跑"的保姆级部署教程。哔哩哔哩小红书知乎知乎小红书
但要泼一盆冷水:"笔记本也能跑"和"跑得爽"是两回事。已上车的人实测很直接——速度比云端慢、分辨率开不高,“平时练习用用,测测提示词还是ok的,毕竟不花积分了”。别拿云端商业版的效果预期,去要求一套量化本地环境。小红书
坑二:下载环节,一半时间在看龟速进度条
"新建实例,下载模型,龟速,几乎看不到进度条会动,几十K 的速度"这类哀嚎在评论区绝不是少数。大家给出的解法也高度一致:先问你有没有用国内镜像。直连海外站不好使,国内ModelScope(魔搭)上有现成的量化版可以直接拉取——先解决网络,再谈部署,别让第一步就劝退。小红书
坑三:花冤枉钱买"整合包",交信息差智商税
H3相关内容评论区最常见的一种话术:“评论66,然后私聊我发送安装包”。第三方双采插件则"免费体验20次",之后收费。请记住:官方权重和ComfyUI本体都是免费的,私聊倒卖的整合包大多只是免费材料的二道贩子,来源不明,还可能夹带私货。另一个新手坑:ComfyUI就算装在其他盘,也容易悄悄爆C盘。开跑前先改缓存路径。哔哩哔哩哔哩哔哩小红书
坑四:把生图的账,算到生视频头上(或反过来)
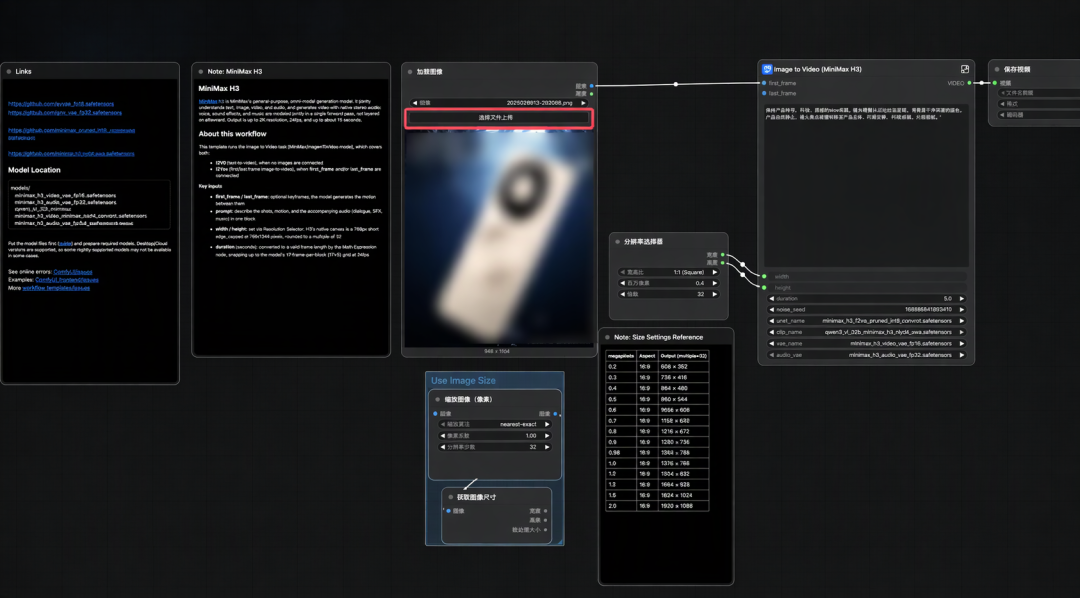
H3视频和H3-Image生图是两套模型、两份配置要求,部署攻略里写得很明白:下载体积不能当作显存要求,也不应把其他推理框架或H3视频模型的配置直接套过来。在线入口、开源权重的规格同样互不通用,“图片规格也不能直接套到视频模型上”。至于"用官方工作流为什么效果和官方差距这么大",老玩家给出的排查方向通常指向两处:加速LoRA换错了,或采样参数被动过。顺带一提,15秒时长是工作流写死的,不是拼短片段。第一次上车别误会成模型拉胯。知乎知乎知乎哔哩哔哩
总结一下
好消息:本地生成门槛确实被打穿了,8G显存够摸到门、24G舒服干活。坏消息:门外这四道坑,全冲着新手来。建议路线——N卡走官方权重+ComfyUI,Mac走MLX;从魔搭拉量化模型;不买整合包、不私信求安装包;先用一条短视频、两张4K图试水,再决定要不要动钱包升级硬件。把预算花在显存上,别花在信息差上。