今年双11,迷你主机卷出了一个新赛道。
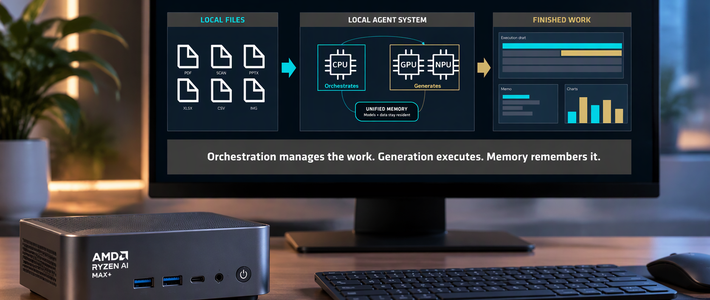
以前大家比帧数、比性价比,今年B站最火的一期评测,是一台"跑320B大模型"的小盒子:极摩客EVO-X5 Pro,搭载锐龙AI Max+ PRO 495、192GB统一内存,实测在桌面上跑通了Q4量化的DeepSeek V4 Flash(284B)和GLM-5.3-Flash(320B),Qwen3.8 Flash Next在特定引擎下,百万token上下文还能保持约60 token/s的生成速度哔哩哔哩。13万人围观,评论区最热的疑问只有一个:这玩意儿,能替代家里那台大机箱吗?
小盒子凭什么跑得动显卡跑不动的模型?
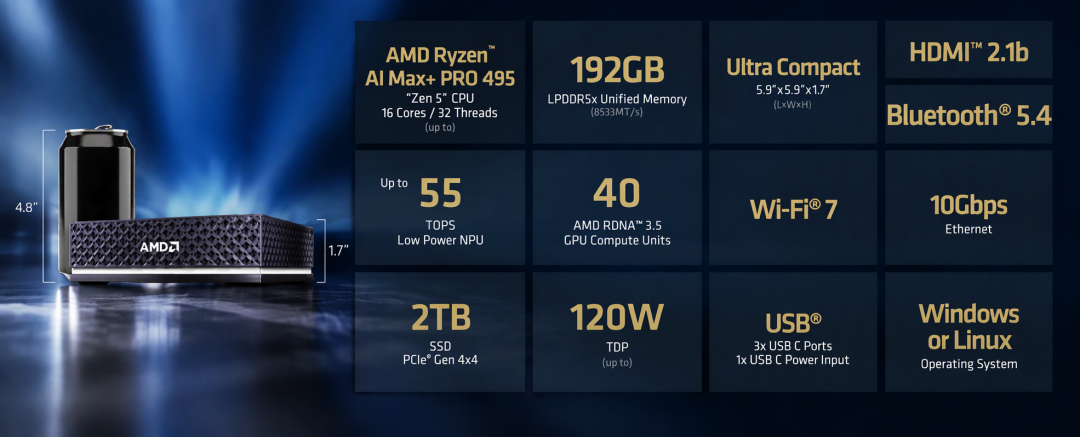
因为本地大模型的真正瓶颈,不是算力,是显存:消费级独显普遍卡在16~32GB,27B的4bit模型就很勉强,100B以上想都别想。而这批AMD统一内存机型,直接给到128GB、192GB,192GB版本最多能划160GB给GPU当显存用。一位把铭凡MS-S1-MAX(395+128GB)跑了半年的用户总结得很直白:用带宽换容量,用容量换上下文,用上下文换Agent能力——"能不能跑"和"上下文能开多大"这两个问题被一次解决。他往本地知识库里塞了4500多份工作文档,数据不出家门,解码速度20~40 token/s,当Agent的大脑完全够用。知乎哔哩哔哩知乎
但先别冲,账单也有反面。
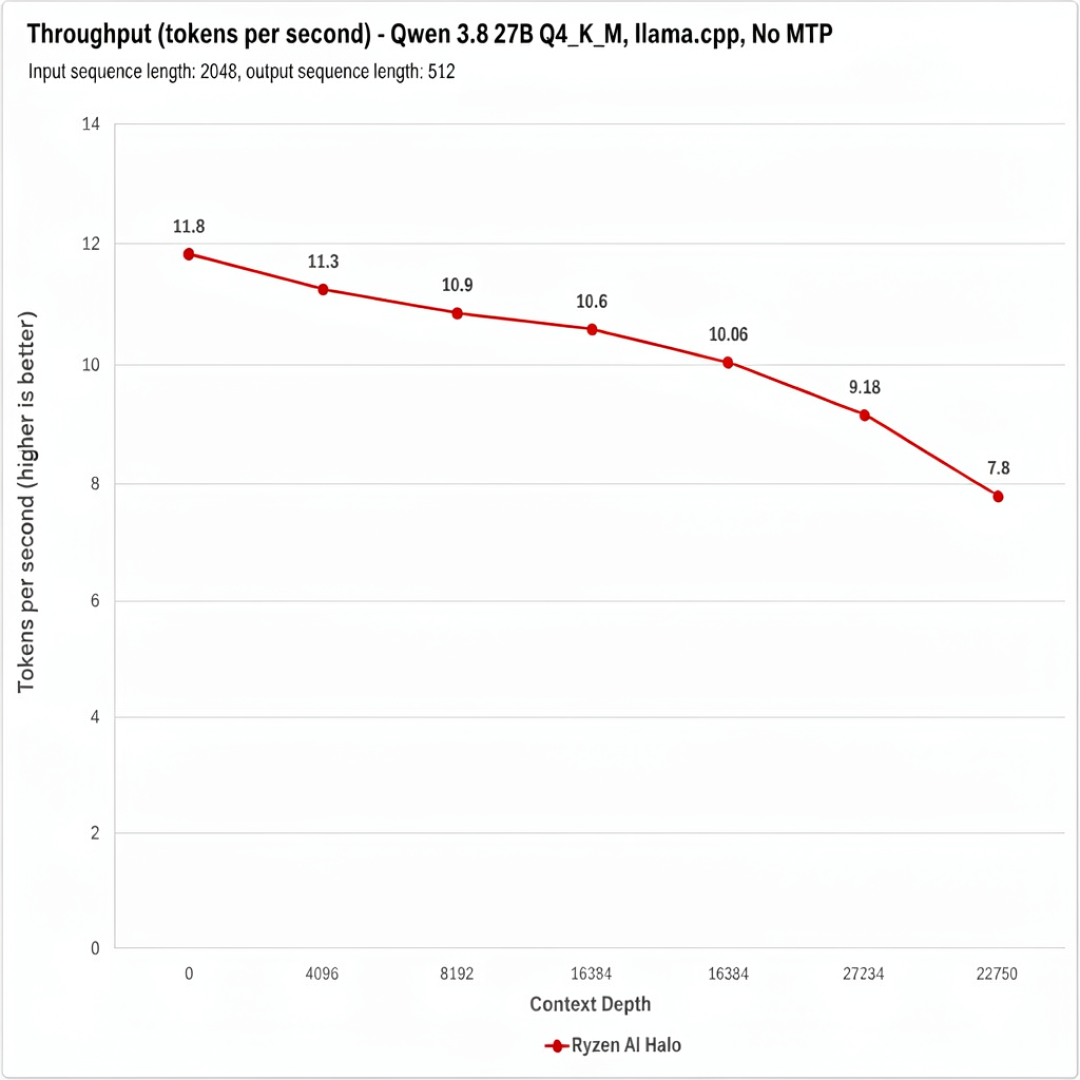
统一内存的命门是带宽:只有256~273GB/s,直接代价就是"首字慢"——实测395平台跑Qwen3.8 27B,上下文一长,首token延迟被英伟达DGX Spark拉开数倍,生成速度尚可,等待却很磨人。还有生态:开发工具链大多基于CUDA,ROCm仍在追赶。好消息是vLLM官方10月已经动手,为395的核显新增专用FP8算子,单算子最高加速2.54倍——不过端到端只快6.8%,且PR仍处于Draft阶段。一句话:容量是天花板,速度是地板,生态还在施工中。知乎知乎
价格是第三盆冷水。
495+192GB的机型,这个双11都站在4万元档:极摩客EVO-X5 Pro标价49999元,FEVM FAEX2卖45599元,差价4400元主要差在存储和系统方案。AMD自家的开发者平台,395版官方定价3999美元。新一代495版也已开启预售,定价6799美元,不过GPU毫无升级,最大的变化是统一内存涨到192GB。而内存价格还在猛涨,这类"内存就是本体"的机器,接下来大概率易涨难跌。哔哩哔哩哔哩哔哩知乎
那么,谁该买,谁别碰?
三类人值得认真考虑:做本地知识库、私有Agent,数据必须"不出域"的人;整仓代码、几百页标书一次喂进去的重度长上下文用户;想24小时静音常开、家里放一台AI一体机的折腾党。
三类人建议转身就走:纯游戏玩家——同样4万元能买多少台带独显的游戏机;想要"每秒百token"AI编程助手的人——首字等待会逼疯你;CUDA生态的重度用户。
这台机器不是万能主机,更像一台"装得下模型的家电"。付钱之前,先写下你要跑的那个模型、它吃多少内存,再数数你能忍受多少等待——答案出来,你就知道这4万元是投资,还是学费。