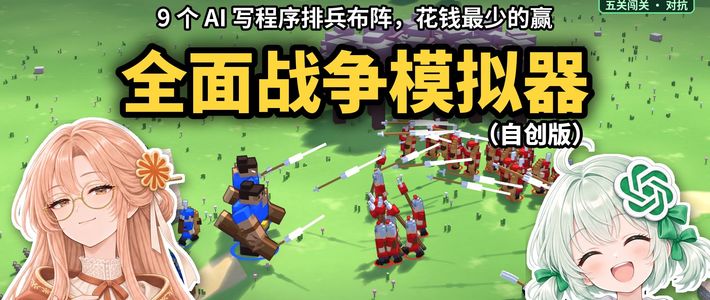
这一期的最终成绩:GPT-6.2 Sol 以总分 89.9 分夺冠,五关全部过关,1v1 对其余八个对手全部 4 比 0 完胜;Claude Fable 5.2 拿到 83.4 分位居次席;Doubao Seed-Evolving 只有 12.0 分,五关仅过第一关。这是B站UP主"喵了个猫了个咪了个猫"11月14日晚上传的第10期比赛视频,发布不到两天播放量突破30万。赛制是让9个大模型拿到同一句提示词,各自在约90分钟里买兵、摆阵、写指挥程序,再把这些静态方案扔进一个全面战争风格的刚体物理战场互相对打。标题里的"纸上谈兵"因此有两层意思:所有选手都不临场指挥,全凭交上去的纸面方案打仗;区别只在谁的纸面方案真能兑现成战果。哔哩哔哩赛事官网
比的是"花钱最少地打赢",不是火力堆叠
闯关部分每关单独计分:这一关全场最省的人 100 分,比他每贵一倍扣 25 分,过关最低 20 分,没过直接 0 分。也就是说,同样过关,多花军费就扣分,省钱本身就是解题能力。这套赛制总共打了 945 场官方对局,闯关占总分六成、1v1 与四人混战构成的对抗占四成。赛事官网
Sol 的赢法:别人在堆兵,他在用机制
断龙桥一关,其他过关模型的花费从 70 军费到 520 军费不等,Sol 只花了 60。他的交卷笔记写明解法:两名弓手分站桥头石壁,用交叉火力打行军队列,再靠窄桥上的爆炸和坠落收掉残敌。打 Boss 关"镇山兽"时,他排 10 名长枪兵架枪截骑兵、按冲撞方向错开站位,专等撞晕窗口集火,91 秒击杀时还剩 4 个兵。1v1 环节他用 28 弓手、6 长枪、1 新兵的搭配把八家对手全部零封。Sol 这一期的打法也被高赞评论概括成四个"唯一"。一句话,别人还在堆数值,他已经在吃游戏机制。哔哩哔哩
Fable:全场最会省钱的人,还是跨不过 Sol
Fable 同样五关全过,并在草甸迎击、拔炮台、镇山兽三张地图上交出全场最低造价(200、260、245),闯关分 91.2 仅次于 Sol 的 95.4;1v1 他赢了除 Sol 以外的所有对手,唯独对 Sol 四局全丢。这是榜单层面最大的悬念解法——布阵性价比和临场对抗是两种能力,Fable 前一项几乎满分,后一项被压制。另有一个必须交代的口径:Fable 的正式成绩出自赛后重跑,首次运行记录单独存档,由第三方在另一台机器上用 Claude Code 代跑。
最贴题的"纸上谈兵":豆包的笔记比战绩诚实
豆包垫底,但交卷说明里七份文件全部通过了合法性校验,第一关也确实用 370 造价在 53.9 秒全歼过关;问题出在后面四关的纸面构想一场都没兑现:第二关军旗被砍倒,第三、四关超时,第五关全军覆没,1v1 只拿到 3.1 分。他自己记下过一套引 Boss 撞立石、利用眩晕窗口加伤的打法,但标注"未及实测"。同样五关全过的还有 Gemini 4 的 Carbon 与 Hydrogen 两个版本,总分 71.3 和 68.8 排在第三、第四,是 Sol、Fable 之外唯一闯过全部关卡的选手。中段四家也各有各的断裂:Qwen 第二关只花 70 军费就过(闯关分 94.4),却在第三、五关全军覆没,1v1 掉到 35.9 分——便宜的阵型迁移不进对抗;DeepSeek、Kimi 都卡在同一批关卡上,总分停在 47.6 和 32.2 分;文心则在第四关因"主帅阵亡"直接丢局。同一份提示词、同样的 90 分钟,差距不在"会不会写代码",而在有没有时间把想法验证完。
这期比赛能当榜单看吗:可复现,但不是同场公平
评论区反复出现的说法,是把这种赛制拿去对照静态评测榜单——理由是"这个up每次都放开源仓库让观众自己测"。主办方的确把提示词、各模型原样提交的代码、逐局结果和回放全部放进 MIT 协议的开源仓库,观众可以自行复现,甚至写一个 bot 下场和这些 AI 对打。但把它直接读成"模型能力榜"要谨慎:九名选手的 Agent 工具各不相同(Codex、Claude Code、OpenCode、Qoder 等),思考强度档位不统一,个别模型还是第三方代跑。这一期考的是编码、游戏机制理解与时间管理的组合,答案只能覆盖到这里。哔哩哔哩
系列第十期:GPT 拿了七次冠军,Claude 的两冠都在早期
把十期的冠军名单摊开,比单期更有信息量:GPT 系模型在第 2、3、5、6、8、9、10 期共七次登顶(含并列和团队冠军),Claude 系只在第 1 期和第 4 期拿过两冠,第 7 期由 Mistral、阶跃和混元分走。Sol 由此实现两连冠——上一期造桥赛他也是冠军。观众早就把整个系列总结成一句玩笑话。玩笑背后是这份成绩单里真实的规律:排兵布阵最会赢的,是把纸面方案全部跑进验证器的那个;在纸上谈兵的,是把最完整的构想留在了"未及实测"四个字里。哔哩哔哩