

近日网传的这份"28款主流AI大模型强度排行",名单出处、评判标准和测试环境至今没有公开材料可查,截至11月19日晚,围绕它唯一的直接动作,是知乎上出现的一个提问。对"日常写稿、做表该选哪款"这个更实际的问题,这张榜给不出答案;更可核验的路子,是看三份口径公开的数据:中文写稿看SuperCLUE的11月测评榜,做表看11月中旬公布的真实工作簿测试,高分值不值多少钱看Artificial Analysis的11月配置表。知乎
写稿:盯住幻觉控制和指令遵循,Kimi K3.1 Pro是国内正式榜首
11月5日,中文大模型测评基准SuperCLUE发布了2026年11月通用大模型测评榜单,19个国内外模型参与,覆盖智能体编程、数理推理、幻觉控制、精确指令遵循、超长上下文五个维度。知乎
写稿最该关注的是其中两项——精确指令遵循和幻觉控制,而不是笼统的"聪明分":总分最高的Gemini-4-Argon(73.62)和GPT-6.1-Sol(71.76)属于国外模型、不参与排名,正式排名第一是月之暗面Kimi-K3.1-Pro(61.46)。知乎
分项对比更能说明问题。DeepSeek-V4.1-Flash-1017的数理推理与Gemini-4-Argon完全同分,两者总分却相差14.67分,差距集中在幻觉控制(43.89对83.19)和超长上下文(66.25对95.63)两项。对写长稿的人来说,编造引用、漏掉格式要求,往往比算错一道题更致命——这也是Kimi-K3.1-Pro值得先试的原因:它的幻觉控制67.78在国内模型中优势明显,超长上下文87.25也位居前列。而榜单从第4名到第10名的总分全挤在34.57–47.18区间,腰部模型差距不大,不必为名次的细微变化反复换工具。知乎
做表:没有哪款"默认合格",最强的也才过38%
做表方面,一篇11月13日提交、16日公告的arXiv论文,把20个前沿模型(评测口径为9月30日的榜单配置)拉去考"读真实工作簿"。70个请求由13个行业从业者自己写,配完整Excel/CSV,共218万个填充单元格、791条评分标准。小红书
按"所有条件全满足才算过"的严格口径,结果相当冷:最强的Gemini 4 Argon通过率只有38.3%,中位数19.3%,20个配置没有一个超过40%。小红书
更值得注意的是失败方式:论文拆开的4个案例里,答案每一条都对、精度满分,却全部判了0分——漏掉藏在批注页里的3个租约、8个编码只列出3个,还有一个柜号只写在贴进表格的图片上。瓶颈是"检索没找全",不是"推理算错"。
这决定了日常做表的关键不是选哪款,而是换用法:别把整个工作簿直接丢给模型,让它回答前先列全所有tab、批注、筛选、嵌入对象,再逐条对照条件;"列出所有"这类集合题单独复核完整性,关键结论别信单次输出。小红书
高分值不值:分数只差3分,每题花费差6倍
Artificial Analysis的综合榜能把"分数"换算成成本:Claude Fable 5.2 Max在原榜显示65分,平均每题$26.54、41.8分钟;GPT-6.2 Astra Max显示62分,平均每题$4.00、13.9分钟。如果两款在你的任务上都能交付,右边这两列比名次更影响选择。知乎
11月18日发布的Gemini 4 Neon更直观:同一份AA榜单里,xHigh档显示61分、单题$6.44、21.5分钟,High档显示60分、单题$3.74、14.8分钟,两档只差1个显示分,每题却差$2.70和6.7分钟。任务在High档已经能完成的,不必追顶档推理。知乎
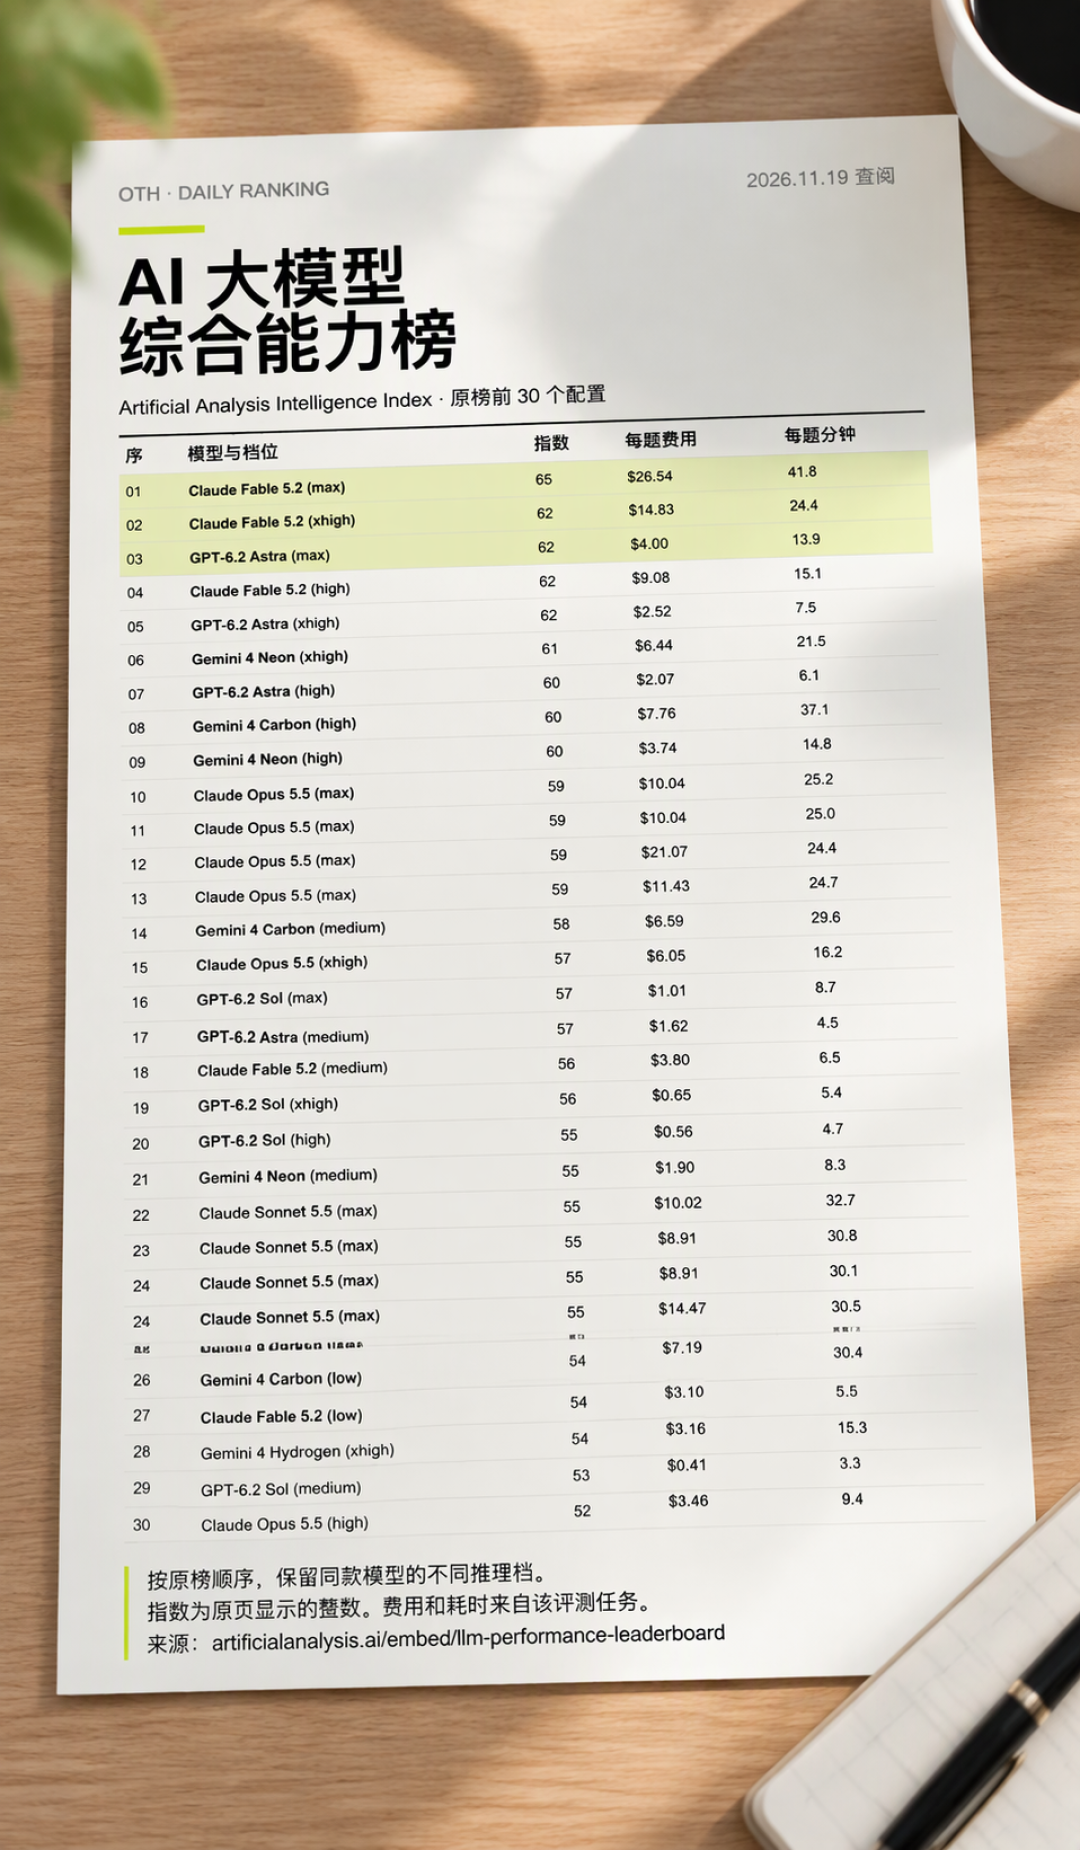
最后说边界。连这份成本榜里都出现了11月18日刚发布的新型号,模型几个月一轮代换、榜单基准版本一变名次就跟着变,任何"排行"都有保质期。写稿,拿自己的真实稿件先测指令遵循和幻觉控制;做表,把38.3%当成预期上限。网传的排行可以围观,替你决定该订阅谁的,还得是口径可核验的数据。知乎

当前文章无评论,是时候发表评论了