

这个11月,三家公司不约而同说了同一件事:30B级大模型,能在手机上跑了。华为麒麟9050官方公众号给出"业界首个30B MoE大模型入端"的说法。面壁智能开源MiniCPM-V 4.7,35B总参数、约3B激活,宣称手机端无损流畅运行。骁龙峰会上,高通的合作伙伴也把30B端侧部署搬上了展台。本地大模型这件事,头一回从"装机"挪进了口袋。知乎知乎知乎
先拆"30B"的口径。30B不是每次推理都把300亿参数全跑一遍——MoE架构好比一家300亿人的专家公司,每次开工只叫醒其中二三十亿。全量权重依然吓人:FP16约60GB、8bit约30GB,量化到4bit还有约15GB。而一台标称16GB的旗舰机,扣掉系统和常驻后台,单个App能拿到手的内存往往只剩6到8GB。所以真正的解法不是把15GB塞进内存,而是让专家权重躺在闪存里,只放"当班"的进内存。麒麟的官方口径是新增内存占用低于2.5GB。知乎哔哩哔哩知乎知乎知乎
再看速度。端侧的真瓶颈从来不是算力,是数据搬运。面壁算过一笔账:芯片纯计算40层只要50毫秒,但每算完一层才知道下一层要哪个专家,闪存读取的IO等待高达250毫秒——“算1秒,等5秒”。他们的解法叫前瞻专家调度:提前预判下一层可能调用的专家,把数据读取和当前层计算并行起来。实际跑下来,8个通常能猜中6到7个,猜错的排在队尾、利用时间差补齐。知乎知乎
效果是:旗舰手机生成速度超过20 Token/s,iPhone 18 Pro Max优化后能到30+,iPad Pro M4实测17.39;按面壁研究员的体感线,15 token/s算流畅,超过30"人基本看不过来"。知乎
最后是功耗。让30B一直醒着,电池先跪。所以麒麟的分工是"大脑加小脑":意图理解、复杂推理、多步规划归大脑,持续在线的感知和快速响应归小脑。30B MoE管多步任务规划,6B管智能修图,7B Dense管日常对话(官方称首字响应提升180%、推理功耗降低29%),小尺寸感知模型持续待机。而屏幕朗读、眼动翻页、熄屏地图这些7×24小时在线的杂活,交给超低功耗感知引擎,不叫醒高算力核心。NPU整体对上代性能+140%、功耗-66%。知乎知乎
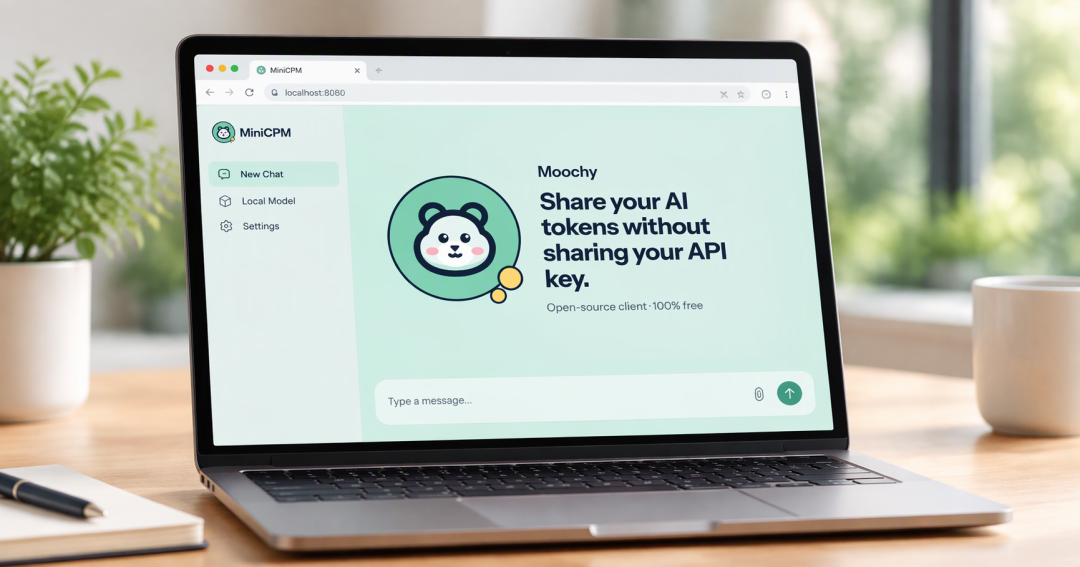
但先别急着为它换机。高通的30B是合作方参考设计自述(预填充>330 Token/s、解码>28),不代表量产机。麒麟的第三方调用清单、模型是预置还是可下载,官方还没给说法。真正门槛最低的是面壁——1B版本下探千元机,模型已进三星Galaxy Z Fold8量产手机,可以完全断网使用、以Apache-2.0协议开源。其推理引擎、App、安装包都能直接下载。更激进的是,开发者已经把MiniCPM塞进浏览器标签页,下载完断网可用、不用订阅、不用API密钥。不过"最快150 token/s"目前只是开发者自述。知乎知乎知乎
参数从7B跳到30B,能力上限确实抬了一档;但决定你能不能天天用它的,是发热、续航和开放度这三份第三方实测。上市后再抄作业,不亏。
当前文章无评论,是时候发表评论了