这几天刷B站的朋友,可能在首页刷到过一个新入口:9月20日,B站正式上线「AI无限竞技场」大模型测评榜,首轮榜单同步公布,GPT-6 Astra在UP主同题PK里拿下榜首,前五名里国产大模型占了三席。 说白了,就是小破站把民间UP主玩了好几年的"AI斗蛐蛐"给官方化了:出题权不给实验室,直接交给各分区UP主,谁家的模型是骡子是马,拉出来遛遛。知乎专栏
这榜单跟跑分榜有什么不一样
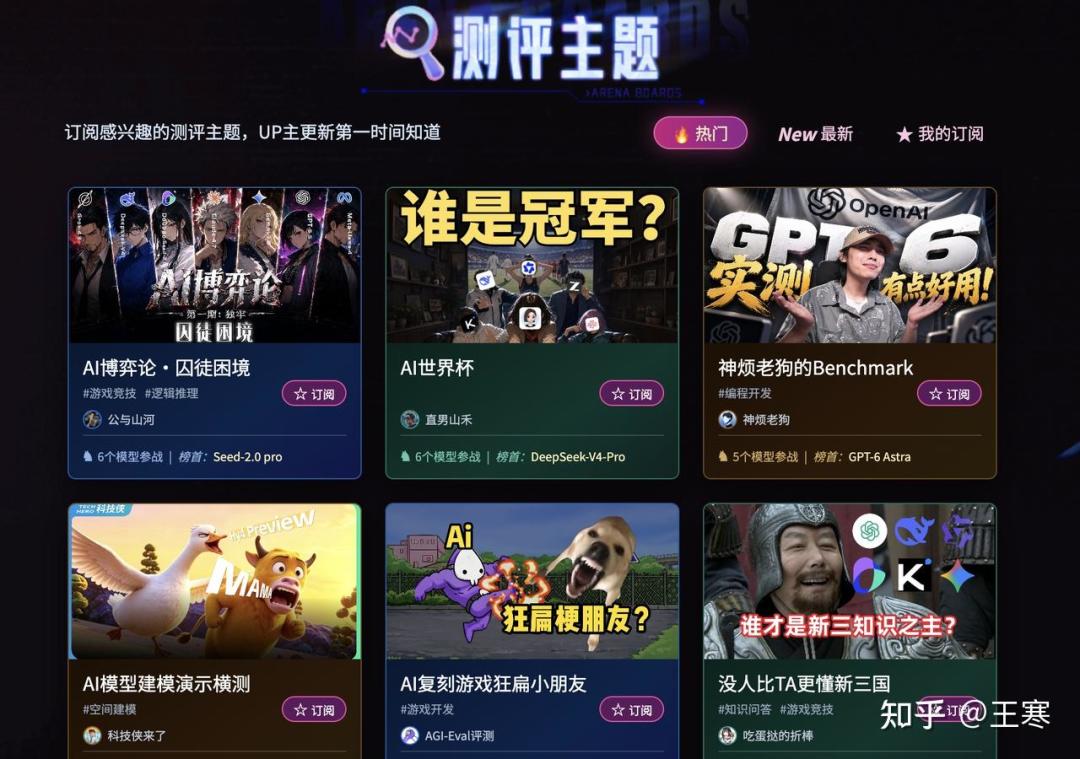
搞AI的都知道,看模型强弱传统上是靠几个专业测评站:Artificial Analysis像标准化考试,统一条件下测推理、代码、Agent能力;LMArena像真人盲测,用户出题给匿名模型投票;LiveBench专门盯题库污染,持续换新题防止刷榜。B站这个竞技场走的是另一条路——来自各个分区的UP主以真实工作流、专业应用、趣味脑洞等自主命题,在同题PK中直观呈现各模型的实际表现差异。 于是你能看到"屎山论剑·模型擂台战"“GTA5的19.8亿次if循环修复”“AI媒婆竞争上岗”"AI麻将大赛"这种正经跑分榜上永远不会出现的题目,画风相当B站。知乎专栏
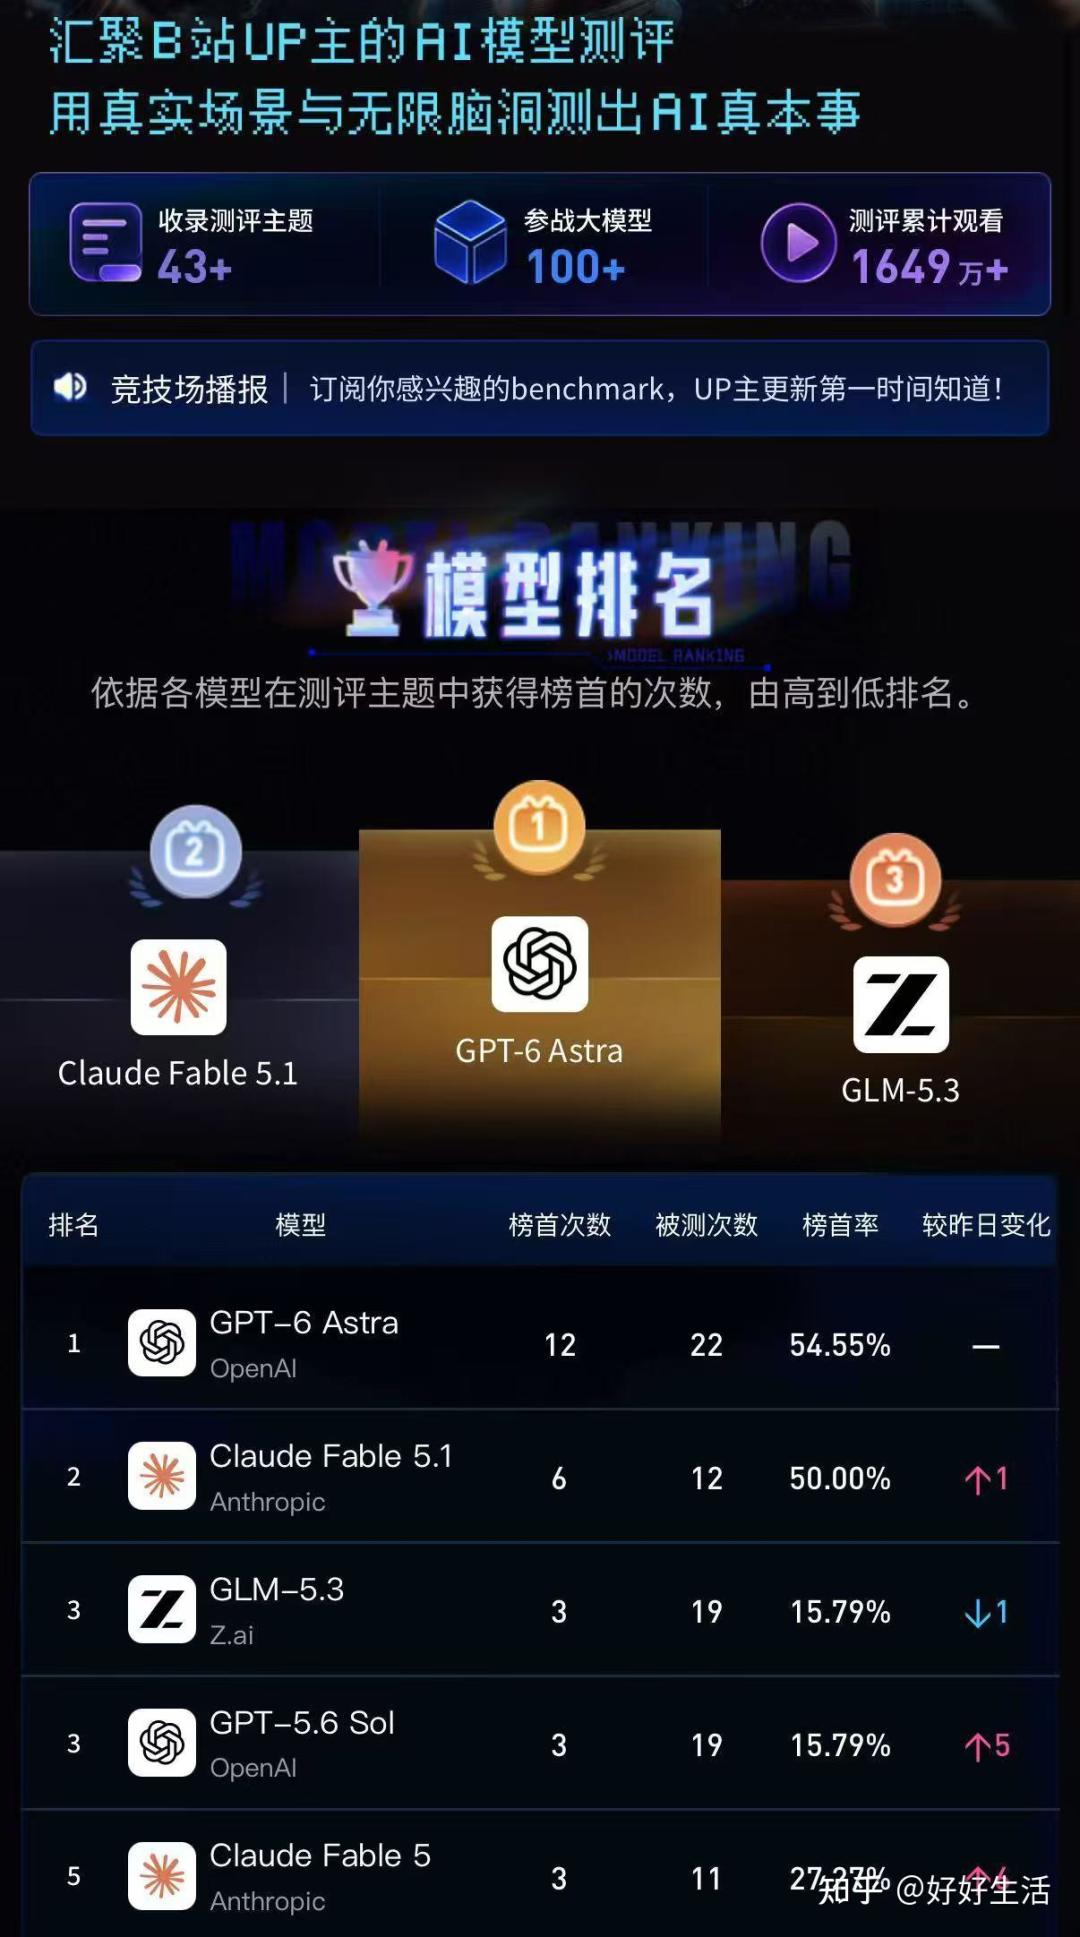
排名口径也跟跑分不同:按各模型在测评主题里拿榜首的次数从高到低排。竞技场排名实时更新,持续面向全站UP主开放报名。 也就是说这不是一期定死的榜单,而是个滚动的"联赛积分榜",后面每一轮都有翻盘可能。知乎
UP主们的态度也能看出这事的画风。屎山挑战赛的UP主Token就是词元在视频置顶里写得很直白:不背题库、直接上场,看各家模型真实成色。跑分再漂亮,竞技场上见真章。哔哩哔哩
首轮结果:GPT-6是状元,但状元不等于全能
先看总战绩:GPT-6 Astra被测16次,拿下10次榜首,榜首率62.5%。 这个胜率确实猛。知乎
但注意一个细节:在GPT-6这十场赢得榜首的测评主题里,足足有八场挂的是Coding的标签。 而编程类主题恰好是这期竞技场里数量最多的——等于说,GPT-6把最大的一块基本盘吃满了。知乎
再看它输掉的场子,其实比赢的有信息量。
同样是祖传屎山题材,"祖传BUG挑战赛"改成赛季制打积分淘汰,16个模型参战,第一名Claude Fable 5.1,第二名Claude Opus 5,第三名DeepSeek V4 Pro,第四名Doubao Seed 2.1,GPT-6 Astra被直接干到了第五。 同一个UP主、同一坨屎山,擂台制它是冠军,赛季制直接掉到第五,这本身就是"代码能力"四个字里藏着多少变量的最好证明。知乎
换到量化主题"谁是搞钱王",让AI同题制定量化策略再模拟交易,比收益也比风控,14个模型参战,第一名是Qwen3.8-Max,GPT-6 Astra屈居第二,GPT-5.6 Sol第三。 编程榜上排不靠前的千问,在"管住风险还能赚钱"这件事上把状元按在了第二。知乎
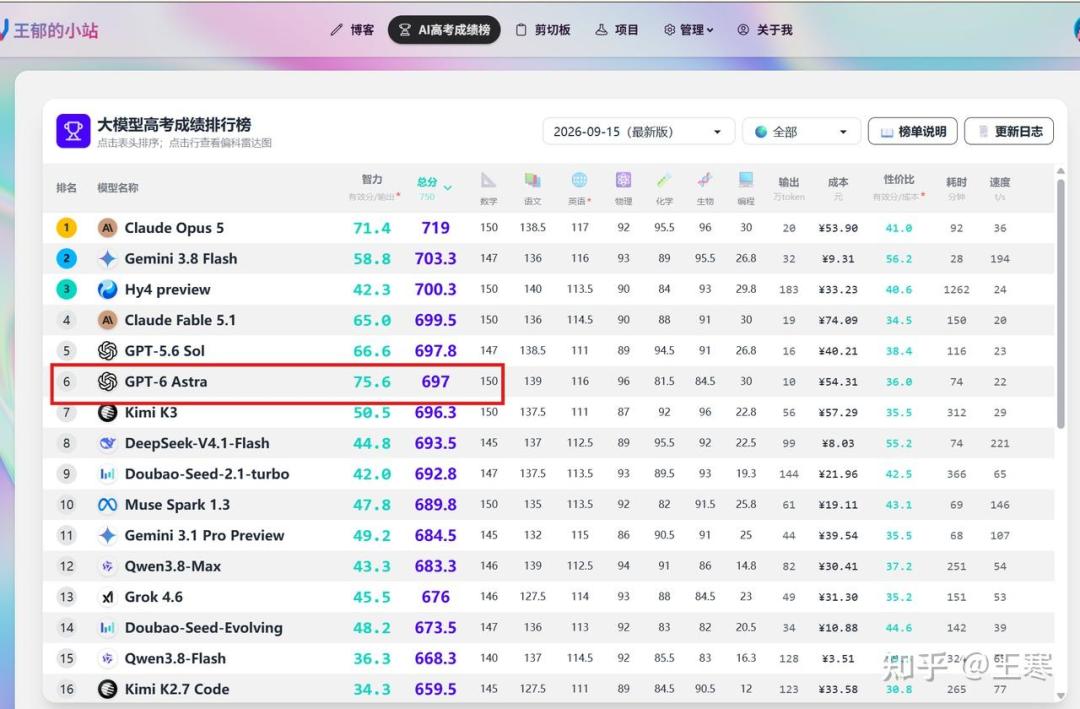
最戏剧性的是36个模型同场答卷的"AI参与全国高考",综合榜状元GPT-6 Astra最后竟然排在第13名。 一个能修24个模型同台竞技的屎山代码的模型,考全国卷只排13名——这不是GPT-6不行,而是长逻辑工程、标准化答题和动态博弈,本来就是三套不同的能力。知乎
国产阵营这轮其实相当提气。首期GPT-6 Astra拿下最多榜首,Claude Fable 5.1和GLM-5.3也紧随其后,前五里国产模型占了三席,量化、物理模拟这些细分主题里国产模型直接登顶。 GLM-5.3还在这轮UP主测评里正面扛过了GPT-6 Astra,拿到了不少主题的榜首。知乎专栏知乎
怎么用它选模型:三步看法
第一步,打开榜单先看页面顶部的三个核心数字:收录测评主题数、参战大模型数、测评累计观看量,心里先有谱。 第二步看总榜,快速了解哪些模型在UP主群体里认可度最高。第三步才是重点:点进具体测评卡片,看出题UP主、参战模型数和榜首模型。同一个模型在不同题目下的表现差异,往往比总榜排名更能说明问题。知乎专栏
按人群给个速查,对号入座:
程序员、天天跟代码打交道的:直接看屎山论剑、各路bench主题,GPT-6 Astra和Claude系咬得最紧,DeepSeek V4 Pro在赛季制里也冲到了第三;
想让AI帮忙做策略、做交易的:看量化主题,Qwen3.8-Max那场值得细看;
学生党、拿AI当学习工具的:看AI高考卷系列,别迷信综合榜状元;
纯看乐子的:音游制作、五子棋、AI麻将,节目效果拉满,顺便看看模型犯蠢的可爱瞬间。
吹之前,先泼三盆冷水
第一盆:UP主出题不等于科学评测。不同UP主的提示词、任务设置和评分方式都会影响结果,同一个模型换个出题人、换个赛制,名次可能差出五名开外,前面GPT-6的例子已经说明问题了。 拿它当参考系可以,当购机指南那种权威结论不行。知乎
第二盆:样本量还不算多。目前主题集中在代码、推理这些硬核场景,等办公、多模态、艺术创作这些场景也加入进来,前三还能不能坐得这么稳,要打个问号。知乎专栏
第三盆:评论区正在饭圈化。Token就是词元那条竞技场收录视频,6.8万播放、875条评论、490条弹幕,热度是真有了,但点开评论区,风向基本取决于当期视频战果:这期DeepSeek赢了就是"DeepSeek神完了",下期打平了就是"DeepSeek区完了",评论区风向全部取决于视频战果啊。 还有人在评论区担心UP主的私有题库被AI编程工具偷学——这倒不是瞎操心,题一公开就存在被针对性优化的可能,跟Benchmark被污染是同一类问题,也是竞技场模式长期要面对的账。哔哩哔哩
值不值得现在就去围观
免费的,不用大会员,纯白嫖。B站做这个产品不是拍脑袋:过去一年里,B站用户消费AI知识类内容的时长同比增长了72%,每个月观看AI相关内容的用户超过1.9亿。 AI区本来就是B站现在最猛的增量内容池之一,竞技场等于给这批观众做了个官方聚合页。微博
给你三个继续观察的信号:一看办公、多模态、艺术创作场景什么时候进榜,进来之后总榜会不会洗牌;二看GLM-5.3、Claude Fable 5.1能不能在编程之外的更多主题里反超,把"状元战"打成拉锯战;三看官方会不会把"榜首次数"这个单一口径拆成分赛道排行——真到那天,这个榜的参考价值会上一个台阶。
最后说句实在的:现在选AI模型,早就不是"哪个最强"的问题,而是"哪个最适合你的活儿"。写代码看屎山主题,做策略看量化主题,写作业看高考主题——B站这个竞技场最大的价值,不是告诉你谁是状元,而是让你花十分钟,就能看到几十个模型在你真正在乎的那类活儿上翻车或者封神的全过程。
你在B站看过AI斗蛐蛐吗?你现在主力用的是哪家模型,看完这个榜单会换吗?评论区聊聊。