一、先把 4 小时 52 分钟摊开:状态页、归因和一份"史无前例"的补偿
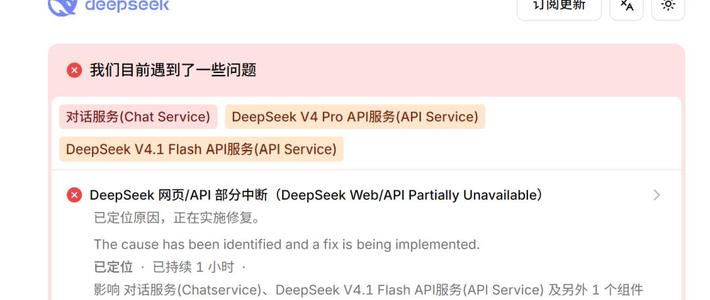
10 月 15 日早上 8 点 11 分开始,DeepSeek 的网页端和 App 陆续弹出同一行灰字:“服务器暂时不可用”。按官方状态页的时间线:8:11 记录异常并开始排查,9:06 更新"已定位原因",12:49 宣布修复已实施、进入监控,13:04 三个组件全部恢复正常,累计中断 4 小时 52 分钟。 当天中午 36氪的报道里写了现场的样子:官方状态页已经挂出红色故障通知,对话服务、V4 Pro API、V4.1 Flash API 全部在受影响清单里。 值得注意的是"部分账号仍能登录"——业务后端和数据库大概率活着,倒下的是 GPU 推理这条链路。知乎36氪
根因官方到恢复都没披露,始终停在"已定位原因,正在实施修复"。媒体引述的业内归因是"算力供需失衡":有统计口径称 DeepSeek 日活从约 1.2 亿涨到约 2 亿(涨幅约 66.7%),同期算力储备只增了约 8.3%。 也有模型公司人士判断是推理集群、调度层故障——“持续时间太长了,如果是自己的 bug 应该能很快修好”。这些都还是推测,真正有官方文本的只有一句:补偿公告里写的"全面梳理并剥离单点依赖"。知乎
频次上,社区口径一致:这是 2026 年至少第 18 次公开记录的服务异常,10 月一个月里就崩了 4 次(另有自媒体声称"第 44 次",查不到出处,注意分辨)。 征兆其实也是公开的:8 月 V4 Flash 正式版上线后,中国工作日上午和美国工作日上午各出现过一次性能下降事件——那是限流;这次没拦住,变成了宕机。知乎知乎
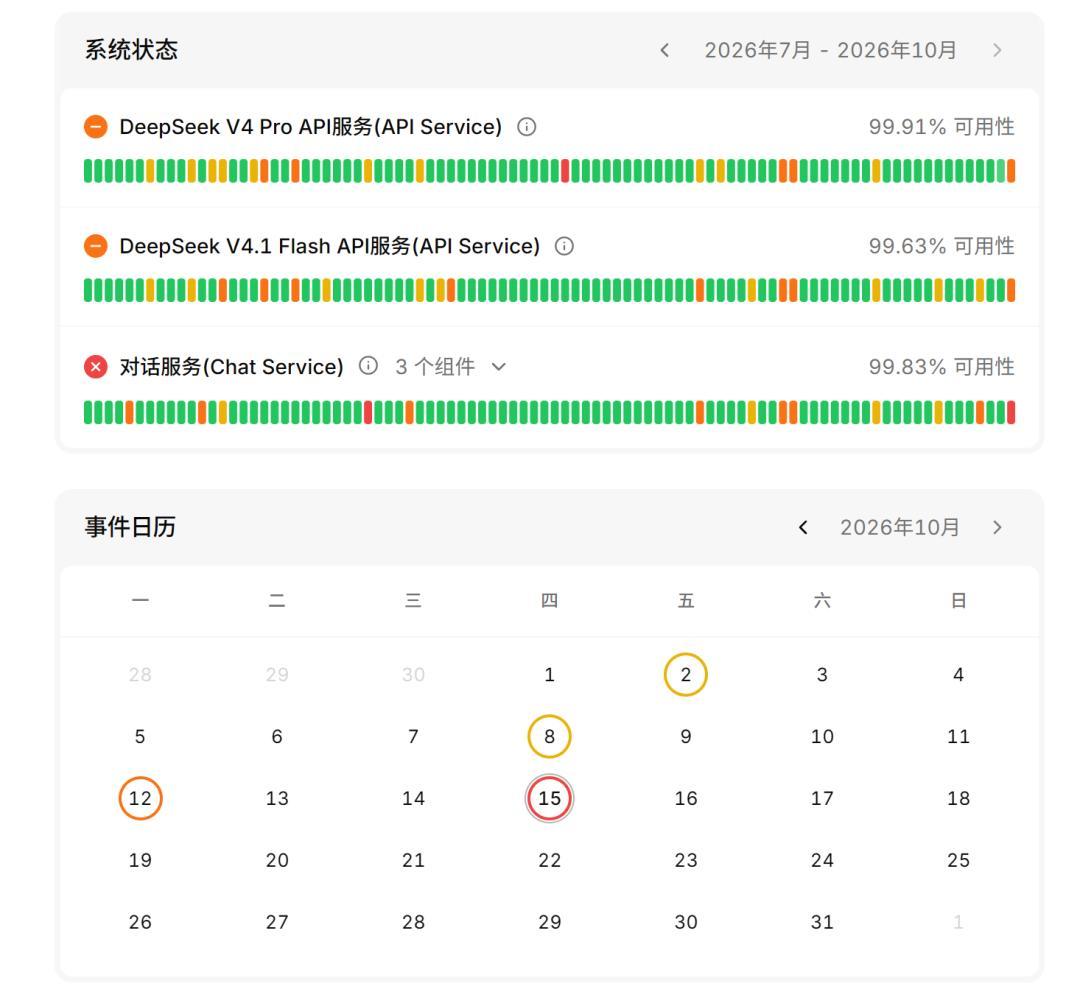
傍晚补偿方案落地:按 API 付费用户过去 7 天(10 月 8 日—14 日)消耗金额等额发放赠金、永久有效、自动到账——免费网页用户没有份,赠金也不能提现。 知乎讨论补偿的高赞说得直白:停机赔付在云计算和电信行业是老规矩,但在国产大模型行业这是头一回——有意思的是,解释义务被赔掉了,用户拿到了钱,没拿到为什么。微博知乎
二、崩了那天,评论区裂成了两拨人
B 站快讯视频的评论区,最高赞(77 赞)是这句:发现炸了第一件事情就是打开B站,大家都炸了,我就放心了。热评一水儿的"土豆服务器发芽了"“刚准备用gpt修”。 微博评论区也有人问"你平时用 DeepSeek 吗",答案高票是"我平时喜欢用豆包"。哔哩哔哩
但同一个上午,另一拨人的画风完全不同:写材料写到一半突然崩了真的会谢;也有人在复盘帖下面认真留言,不要过度依赖单一 AI 工具,一定要多做备份。 这两拨人的差距,不是觉悟,是依赖深度:聊天党被崩掉的是一上午的摸鱼时间,管线党被崩掉的是交付。你的备胎值多少钱,完全取决于你是哪一拨。微博
"给 AI 安排备胎"的叙事当天就刷屏了——有博主开篇就承认,2026 年了还把工作流押在单一模型上,本身就是一种风险。 值得警惕的是,这批"备胎教程"的后半段常见操作是引流卖卡密代充——具体渠道看作者主页,这种教程是情绪流量,账本才值得看。知乎
三、六档"备胎",社区数据摆进同一张表
本地圈这一波已经把"备胎"从说法变成了实测。我把目前能查到的公开自报数据按门票档位排开:
档位 | 入场门票 | 社区在跑的方案(均为公开自报) | 口径速度/表现 | 是不是"原胎" | 崩机当天现装来得及吗 |
|---|---|---|---|---|---|
免费档 | 0 | 换一个云端 AI / Ollama 云模型等免费通道 | 取决于对方没崩 | 否 | 分钟级,但要防同波峰共振 |
轻薄本档 | 8–16G 内存,无独显 | Ollama 跑 deepseek-r1 蒸馏 1.5B(8G)/7B·8B(16G) | 速记、润色、轻代码 | 否,能力大降档 | 权重数 GB,看带宽,勉强 |
12–24G 显卡档 | RTX 3060~3090 | Strata 引擎跑 Qwen3.8-Flash-Next:3090 上 IQ3_S 短问答 67 tok/s(同硬件 llama.cpp 约 20);12G 5070 跑 IQ3_XXS 65.6 tok/s;同日 NVIDIA 发布 Nemotron 3.5 Bolt 74B-A9B 的 24GB 版(多模态+工具调用,权重已开放) | 日常问答已可用 | 否,是"能力接近"的他家模型 | 权重几十 GB,现下载基本来不及 |
128G 统一内存单机档 | 一台 DGX Spark | Qwen3.8-27B nvfp4 量化+dspark 投机解码,博主自报日常智能体任务稳定 40 tok/s 上下、写代码可冲到 70–80 tok/s | 已可当"半个主力"用 | 否,但接近主力体验 | 权重几十 GB,需提前囤 |
192G 内存档 | 4090+192G 内存或 192G 迷你主机 | llama.cpp 单机 DeepSeek V4 Flash,Q8_K_XL 量化,开 300K 上下文 | 接近主力模型体验 | 同系列,算"半原胎" | 上百 GB 权重,没提前囤就是没有 |
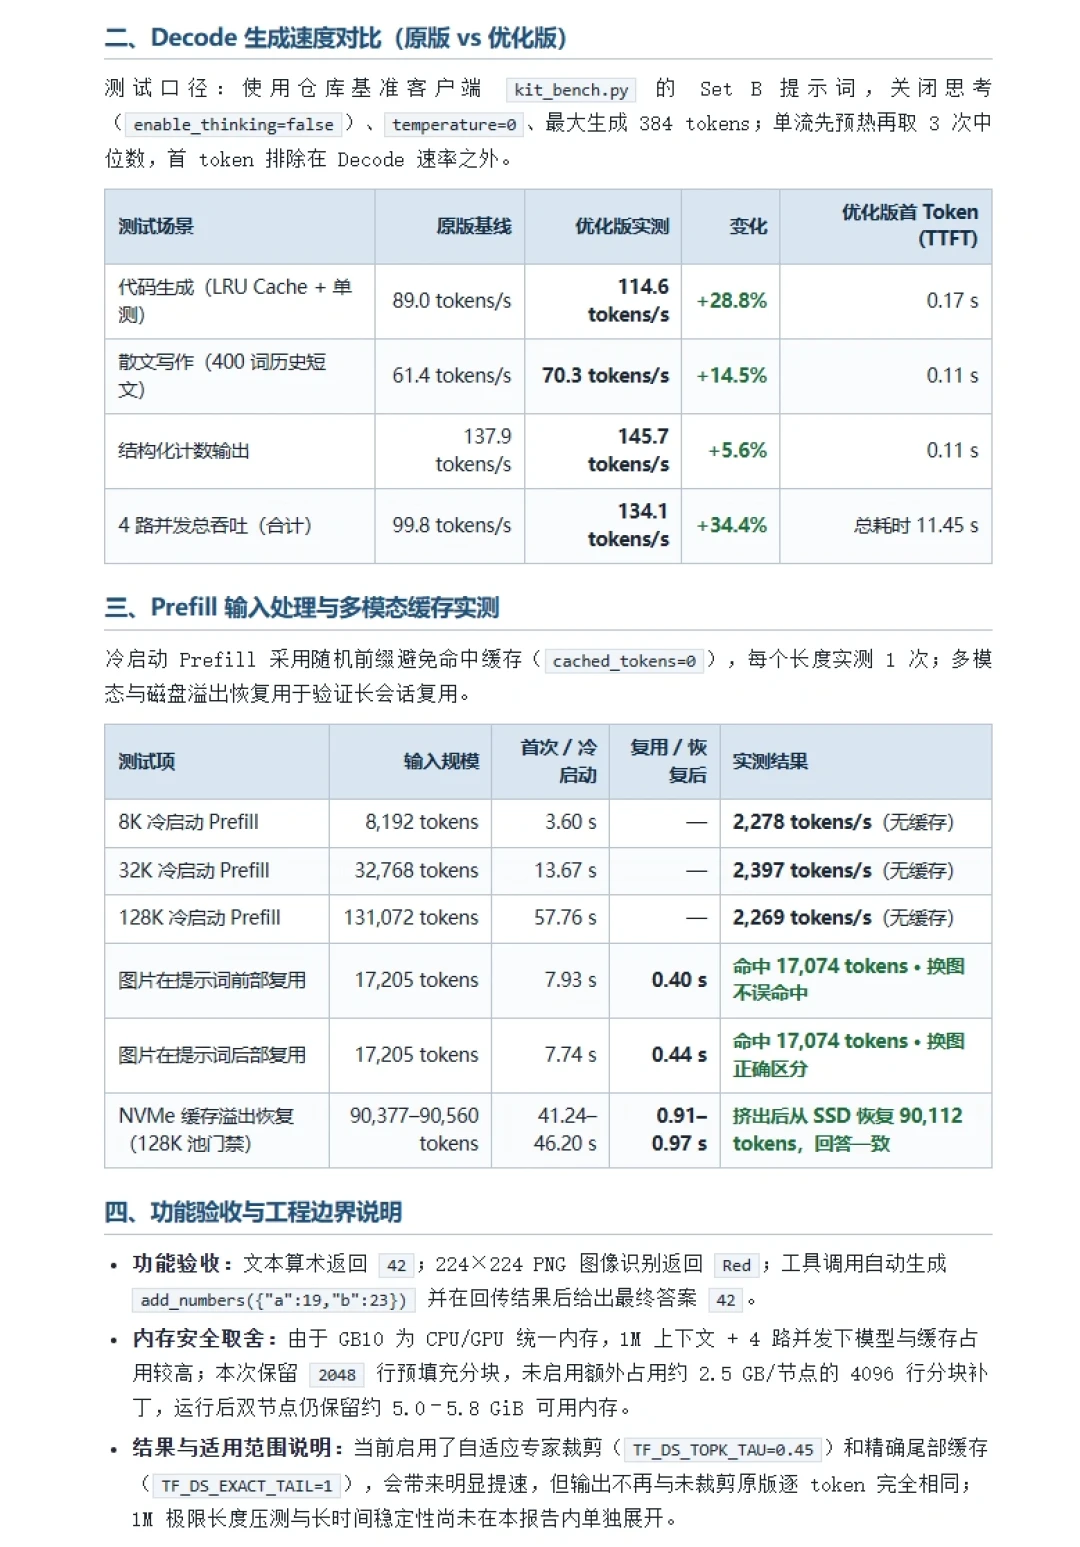
双机硬核档 | 2×DGX Spark + 200Gb/s RoCE | Tensorfold 双机 TP2 跑 DeepSeek-V4.1-Flash(EXL3 2.9bpw 量化+原生 Engram 表,双机校验资产 413.76GB,每节点另约 106GB rank 缓存),1M 上下文 | decode 70.3–145.7 tok/s,TTFT 0.11–0.17s;prefill 约 2,300 tok/s;90K 长会话从 NVMe 恢复 0.91–0.97s(冷跑 41–46s) | 是,就是 V4.1-Flash 本胎 | 半 TB 级下载+部署,绝对来不及 |
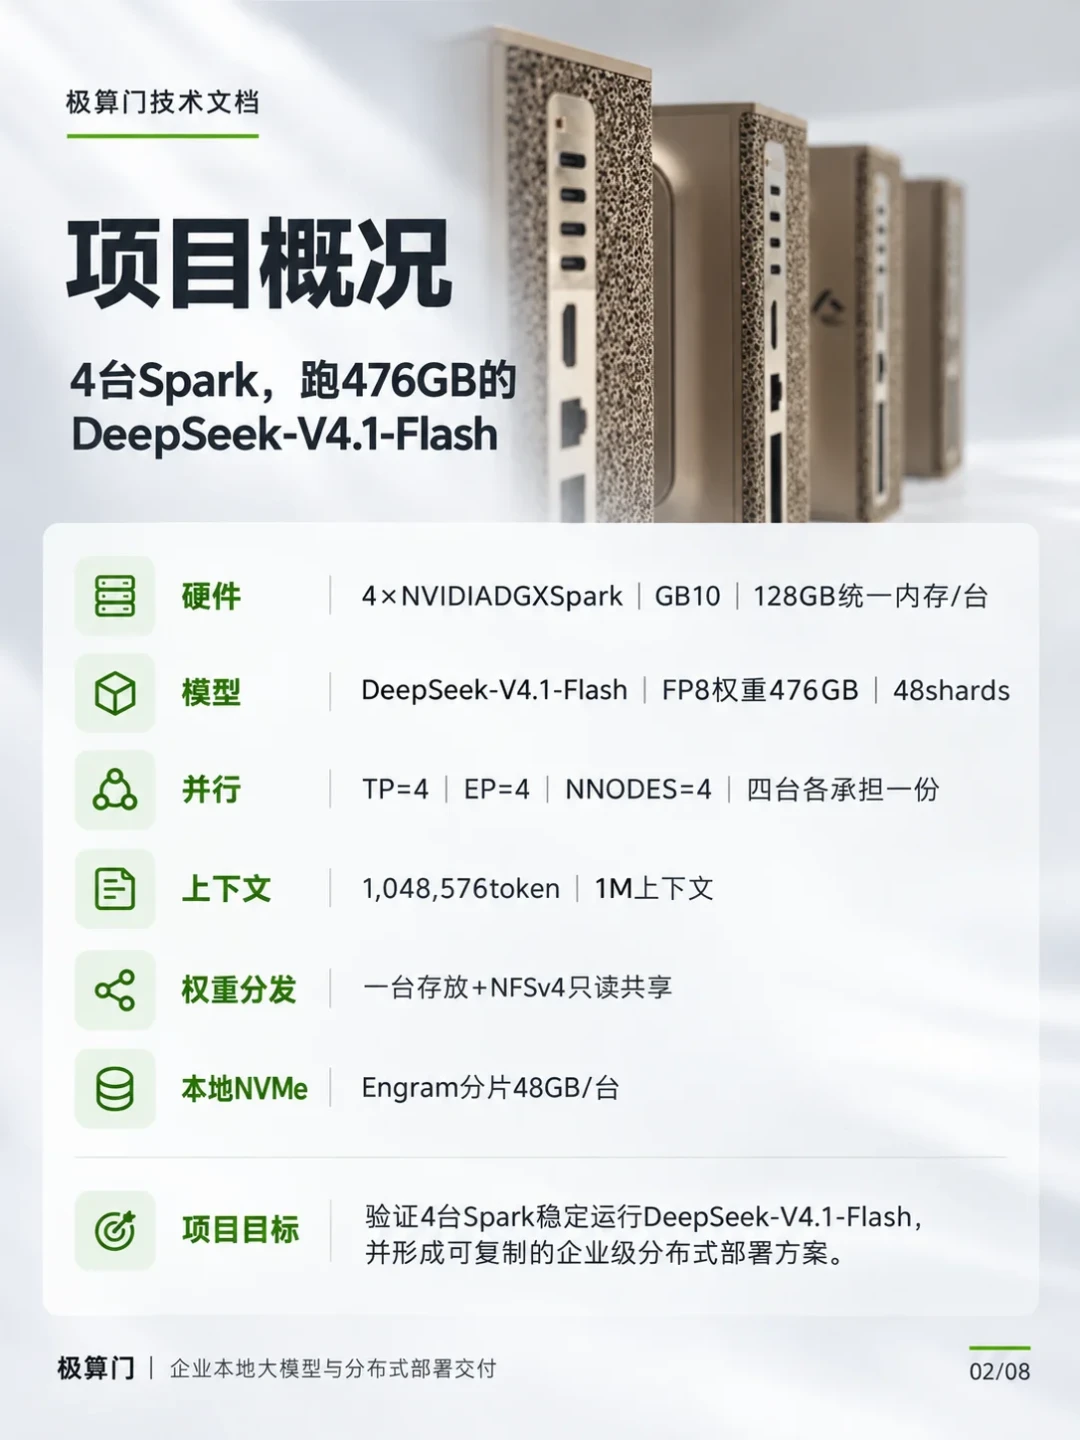
四机集群档(原胎上限参照) | 4×DGX Spark(4×128G) | MiaAI-Lab 团队自报:4 台 Spark TP4/EP4 跑 DeepSeek-V4.1-Flash(模型约 476GB),投机解码 k=3,1M 上下文实喂 964,449 token 找回埋点暗号 | 单请求 33.9 tok/s、4 并发聚合 79.6、8 并发聚合 114.2 tok/s;32K 首字约 7.6s、128K 约 37.4s | 是,本胎 | 近半 TB 权重+多机互联,个人现装无从谈起 |
表里 12–24G 和 128G 两行不是参数表拼出来的,是社区同机自报:微博大V tombkeeper 转发实测,3090 跑 Qwen3.8-Flash-Next IQ3_S 短问答能到 67 tok/s,同硬件 llama.cpp 只有 20 tok/s;12G 5070 跑 IQ3_XXS 也有 65.6 tok/s。 一台 DGX Spark 上,Qwen3.8-27B 换成 nvfp4 量化加投机解码后,日常智能体任务稳定 40 t/s 上下、写代码能冲到 70–80 t/s。 还有容易被忽略的一条:崩机当天 NVIDIA 发布了 Nemotron 3.5 Bolt 的 24GB 版(74B 总参、激活约 9B),权重已开放。微博小红书小红书
三个容易被教程略掉的事实:
"V4.1-Flash 能不能本地跑"的答案已经是能——权重开源,量化版双机 TP2 都有人跑通了:EXL3 2.9bpw 量化加原生 Engram 表,双机校验资产 413.76GB,每节点还有约 106GB 缓存。 4 台 Spark 实测的队伍甚至报出了单次喂 964,449 个 token、在 1M 上下文里正确找回埋点暗号的成绩。 问题从来不是能不能,是门票和囤货。小红书小红书
冷启动是备胎悖论的核心。4 小时 52 分钟的窗口内,按常见家宽折算,几十 GB 起步的权重从下载、校验到加载服务,几乎都超出窗口本身。8 月峰谷定价那波已经透露过:高峰流量是真的挤——中国上午、美国上午两个波峰轮着来,这次宕机恰好又落在早 8 点后的流量爬坡时段。崩机日现装,等于火灾当天去买灭火器。
"教程 3 分钟搞定"只覆盖了启动器时间,没覆盖能力账。轻薄本档的公式就一行 ollama run deepseek-r1:1.5b,8G 核显本就能"轻松跑",但教程里的"搞定"是跑起来,不是跑得动正事。 200K 上下的长文档、深推理、多轮工具调用,和 V4.1 完全不是一个物种;量化降档在本地测评帖里也被反复验证过——难题掉分是常态,极端比特位还会死循环。任务-档位错配的备胎,比没有备胎更坑:崩机那天你会发现它在关键时刻只会说"抱歉,我无法回答"。小红书
四、掏钱之前,先对完三本账
第一本:冷启动账——你的中断容忍是多少分钟?
脚本挂整夜、白天要交付、客户在线等 API 的人,中断成本按小时计,备胎是生产资料;纯聊天用户的中断成本约等于零(补偿赠金也没你的份),"大家崩了我就放心了"就是最优策略。先给自己归了档,再谈买不买。
第二本:门票账——备胎不是白放的。
硬盘常占、内存/显存预算、折旧电费,以及最容易被忽略的:放着不练等于没有。备胎要像真胎一样定期上路,每月一次真任务演练,比下载完就供起来值钱得多。
第三本:降档账——什么任务"备胎能顶",什么任务"顶了也白顶"。
润色、摘要、短问答、离线写初稿:16G 轻薄本档就够。接工具、改代码、长上下文方案:至少 12–24G 显卡档,且要接受和原胎的掉分差距。要"原胎级"接管对话+API+视觉+1M 上下文:目前的门票就是 128G 集群起步,双机 V4.1-Flash 更是半 TB 级资产。
五、按人群给结论:该囤的囤,该省的钱一分别花
值得现在就动手的三类人:①把 DeepSeek API 嵌进产品或流水线的人——你至少要做双云故障转移,并把一个"半原胎"(同系列开源模型的量化版)常驻在一台能开服务的机器上;②数据敏感、本来就该本地化的人——宕机只是让你把这笔账提前算了;③工作日早高峰必用、任务有交付死线的人——轻薄本档+一个装好能起服务的 12–24G 备用位,比什么会员都实在。
不值得花钱的三类人:①免费聊天党——你的合理配置是"知道它今年崩了 18 次,然后该干嘛干嘛";②已经有双云习惯的订阅党——补一个第二账号的月费,收益大概率高于加一张显卡;③被"5 小时宕机"刺激到想一步到位上双 Spark 的人——先问自己上一次因宕机真正损失的交付是几个小时,答不上来就先别掏。
动手清单(给值得囤的人):权重用开源渠道提前下好并校验;用 Ollama、LM Studio、llama.cpp、Strata 任一引擎在低峰时段试起服务;把工具的地址、协议、模型名三要素连好——"本地模型装好了还是连不上"是这个社区最高频的坑,地址、协议、模型名来回改,说好半小时、抬头天都亮了,别让这事发生在你的备份日。 最后记一次演练时间:从宕机发生到你能输出第一个字,几分钟。超过 15 分钟,就说明你囤的是硬盘摆件,不是备胎。哔哩哔哩
六、往后盯这四个信号
①官方承诺的"剥离单点依赖"整改,会不会附带一份真正的故障复盘——这是确认根因的唯一正路;②按 7 天消耗退赠金这个先例会不会被行业抄走——停机赔偿成为惯例,才说明大模型被按基础设施的标准对待。 ③日活涨 66.7% 对算力涨 8.3% 这条剪刀差有没有收敛,以及会不会再来一波"用价格分流需求";④"原胎本地化"的下探速度——V4.1-Flash 已经从双机 TP2 走到 4 台 128G Spark 集群实测,下一个悬念是它(或同级的蒸馏、量化路线)什么时候能塞进单机 128G、再塞进 64G,那才是"全员备胎"真正的起点。知乎
崩机不可怕,可怕的是把"云靠不住"记成情绪,而不是记成预算表。