












12
10
DeepSeek新版本被骂太抠门上热搜:钱没多收,它只是话变少了
2026-10-26 04:52:56
0点赞
1收藏
0评论
10月25日中午,#DeepSeek新版本太抠门#冲上了微博热搜。点开话题,吐槽基本是三句话。回答变短了,废话铺垫没了,语气变冷了。有人写得直接,上次问同一个问题给三段,这次只回一句,那感受就一个,你敷衍我。
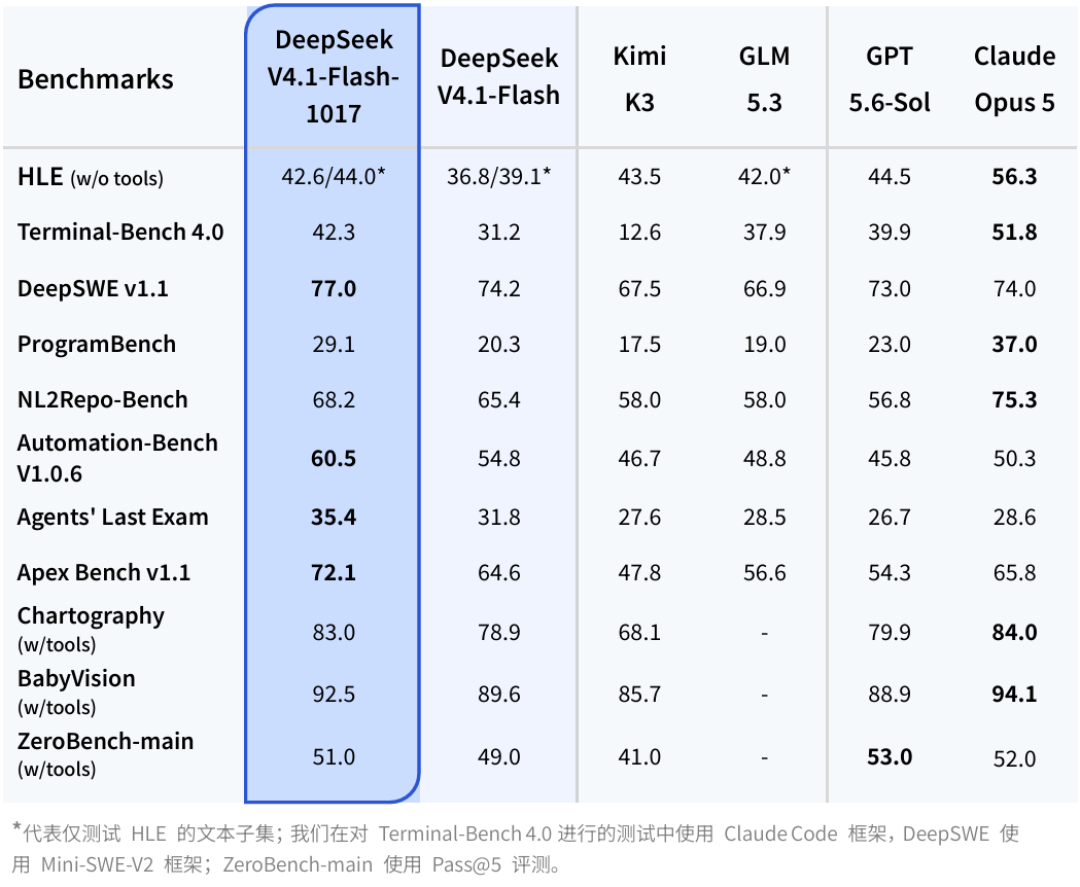
先把数字摆出来。这次更新是10月17日,网页端、App和API同步切到DeepSeek-V4.1-Flash-1017,模型价格一分没动,权重照样开源。跑分还涨了,编程基准DeepSWE从74.2提到77.0,终端操作的Terminal-Bench 4.0从31.2跳到42.3。代码竞技场WebDev榜上,1017拿了1670分,开源模型第一,总榜从第25名蹿到第12名。
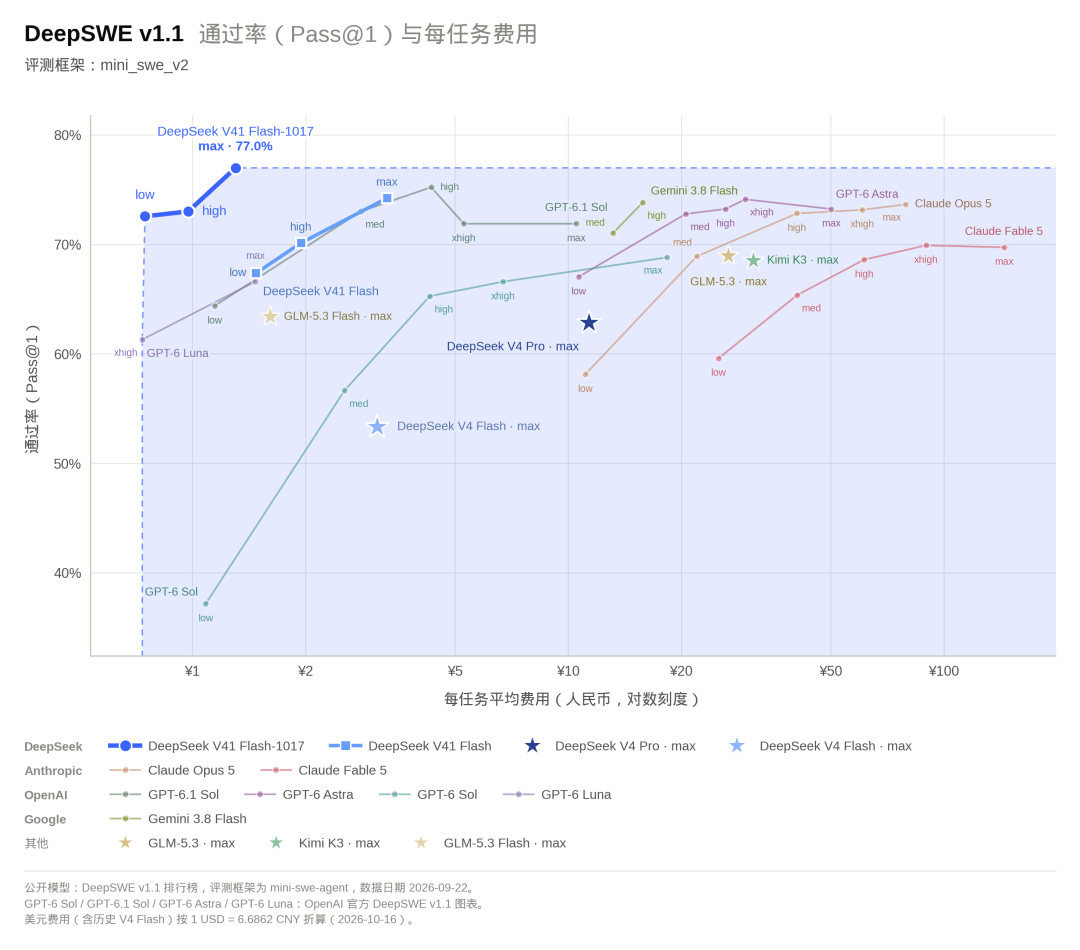
更扎眼的是成本。性能费用对比图里,同一个编程任务,旧版V4.1-Flash要花3块多,1017只要1块多,降了六成。
按这套数字,用户该发锦旗才对。那骂声是从哪来的?
抠门这个词,骂的其实不是钱。免费用户的额度没变,API单价没涨,热搜里传的高级功能塞进付费墙,有博主专门去核过,对不上。真正让人不适应的,是官方更新日志里一句不太起眼的话,新版减少了任务运行时间和输出长度。
翻译一下,它学会少说话了。
对写代码的人,这是天大的好事。以前让它干个活,边干边汇报,车轱辘话能说半天,每个字都要算钱。现在话少了,活照干,账面上单任务成本直接砍六成。有博主拿4个真实项目做了实测,3D城市生成器同一道题,旧版跑102分钟,新版61分钟,4个项目加起来2亿多token,账单12块81。
问题出在,少说话这个特性,跟很多普通人的用法是拧着的。
B站一条4万多播放的实测视频,标题就叫DeepSeek 1017变抠门了。up主的原话是,它的Agent能力被训练得过于抠门,做事情有代价的,它倾向于不做。评论区有位用户举了个例子,让它测自己写的游戏,它发现了测试工具,宁可自己重新写一套代码把地牢重跑一遍,也不肯调一下现成的工具。不是额度不够,是它自己觉得这一步不划算。
省的是token,废的是体验。
再往深一层,这不是bug,是训练方向的取舍。知乎有位用户把DeepSeek这两年的文字能力排了个序,V4 Pro最强,V4 Flash其次,V4.1 Flash再次,1017垫底,角色扮演是近一年最差的一版。他给的解释挺扎心,编程要的是准确,写作和扮演要的是发散,模型在编程上练得越狠,文字就越死板。DeepSeek这一路都在强化干活,聊天的那部分,就是这么一点点被挤掉的。
所以这条热搜,两边说的其实都对。
拿它干活的人,得到的是更快更便宜的执行者。拿它写小说、玩角色扮演、当情绪树洞的人,失去的是那个愿意陪你多说三段话的版本,而且没有预告,没有开关,一觉醒来就换了。后一种用法恰恰是DeepSeek免费用户里的大头,骂声大,不奇怪。
那具体到你,该怎么办?
写代码、跑项目的,别跟着骂,这版对你是加量降价。接了自己Agent框架的开发者留个心,1017的脾气变了,原来的提示词和流程要重新适配,DeepSeek自己也建议把Harness升到0.2.1-rc.1以上。另外从11月1日零点起,它的搜索和网页抓取接口开始按次收费,之前免费的过渡期就这几天。
拿它写东西、聊天、玩扮演的,两个现成的办法。一是把思考强度调低,上面那位知乎用户实测,能压住不少AI味。二是换个模型写,他推荐千问3.8-flash,价格跟DeepSeek flash一个档,文字效果更好。犯不上跟一个已经转身去做执行者的模型较劲。
只拿它查查资料、问问生活问题的,这事对你影响不大。回答短一点,反而省得你划屏幕。
回到开头那句吐槽,上次三段,这次一句。它确实变了,只是变的不是价格,是性格。热搜骂它抠门,它抠的不是你口袋里的钱,是自己的话。这两笔账分开算,你就知道该留它干活,还是该另请高明。
内容由AI生成