一个光模块出问题,可能让整批训练任务停下来等。
这不是假设。万卡集群里,网络拥塞、性能波动、某个光模块的局部故障,看起来都是网络侧的小事;落到业务上,往往是整批训练等待、推理延迟上升,甚至中断重跑。
10月下旬,在成都举办的2026中国计算机大会上,中科曙光发布了一个叫Fabricview的网络管理平台。它管的是百万量级的设备、端口和光模块。
一个网管平台,为什么值得单独发布?因为网络不再只是连接,它决定GPU等多久、token花多少钱。
一次公开实测里,一个五百人的研发团队,三天产生了超过800TB的KV Cache。
这些“阅读笔记”不是代码,是模型每读一遍上下文算出的中间状态。GPU上的HBM是GB级,加上服务器内存,也不过几十TB。800TB对几十TB,装不下,只能往外交给存储。数智前线
AI Coding是最典型的长上下文场景。一个任务跑几天,两百多轮,单次上下文128K,95%以上是重复内容。重复的部分本来可以命中缓存。
命中与不命中,价格差得很远:以DeepSeek V4-Flash的公开价为例,命中每百万token 0.0028美元,未命中0.14美元,相差50倍。
华为给出的一个金融客户数据里,缓存命中率从35%提到92%,首Token时延从55.94秒降到4.24秒。省下的不是一点算力,是一大笔token账单。存储要留住这些“笔记”,网络要尽快搬回来。数智前线
搬得有多快?HBM的带宽是每秒TB级:H100的HBM3约3.35TB/s,B200的HBM3e约8TB/s。显存到内存的PCIe Gen5 x16,只有约64GB/s。知乎
外置存储要当“第三级缓存”,带宽就得尽量贴近内存。
华为OceanStor M900把KV Cache从显存、内存扩展到SSD,单集群64PB、40TB/s聚合带宽,NPU到SSD一跳直通,访问时延从毫秒级降到60微秒。智能相对论
但存储这一端再宽,算力卡那一端如果是羊肠小道,速度照样上不去。存储网络的价值,不是某一个端口的标称速率,而是整条路能不能一起跑起来。
训练侧的压力更直接。一次checkpoint要写十几TB,每30分钟到2小时一次;万卡集群平均2.8小时中断一次。
如果存储面和训练面共用一张网,写checkpoint的洪峰一上来,梯度同步就得排队。所以新建的AI数据中心,存储面往往单独组网。
训练面跑的是微秒级、对丢包极敏感的RDMA;存储面接的是周期性的吞吐洪峰。两张网分开,不是浪费,是互相保命。
新的存储网络,也不再只有一种走法。块存储走NVMe over RDMA,文件业务走NFS over RDMA,GPU还可以绕过CPU和主机内存,经RDMA直接读写远端存储。知乎
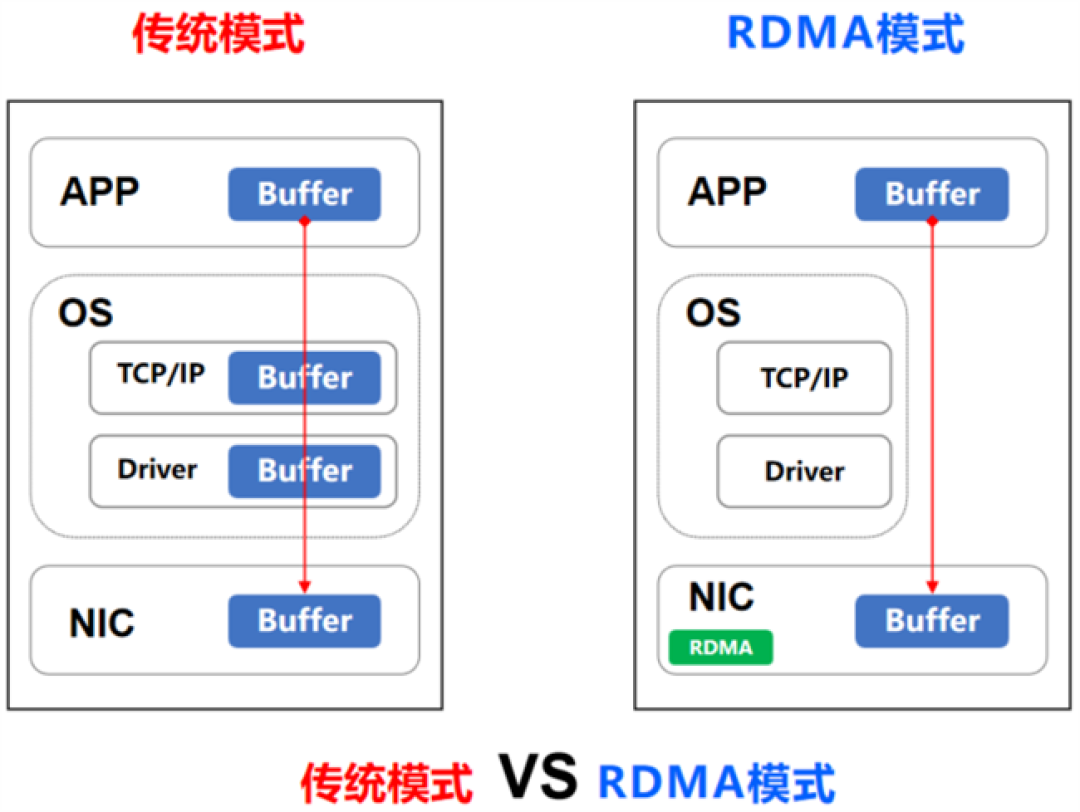
中科曙光给出的数据是:文件业务走RDMA后,GPU利用率从55%提到95%以上,训练轮次耗时缩短30%到60%。
单跳转发时延260纳秒,网卡端到端低于1微秒,三跳组网时大消息时延比主流RoCE低约63%。
这些数字指向同一件事:存储网络正在从“存储设备之间的连接”,变成“算力、存储、网络三者的公共通道”。
芯片决定下限,互联决定效能。这句话放在存储网络上,同样成立。36氪
通道越修越宽,老办法也开始露怯。RoCE靠PFC做逐跳反压,规模小的时候好用;到了万卡、十万卡,PFC死锁、反压级联、配置复杂、多路径不好均衡,问题一个接一个。
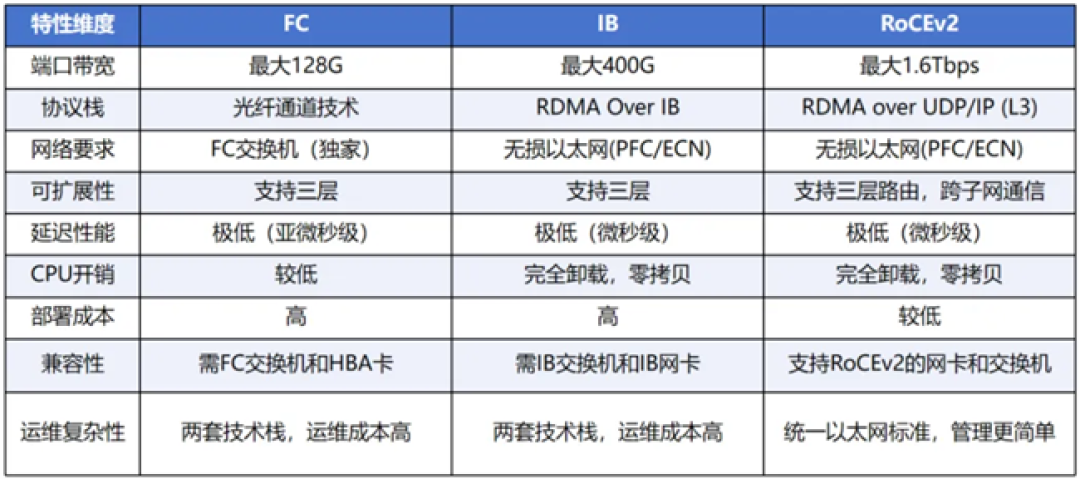
业界的做法开始转向Lossy RDMA:关掉PFC,把可靠性从网络侧挪到网卡侧。接收端流控、ECN加丢包和RTT的拥塞判决、窗口化速率控制、选择性重传,这些能力得由端侧补齐。
换句话说,网络不再保证不丢,端侧要保证丢了也能很快恢复。这不是降配。集群越大,网卡硬件规格的差距越容易被抹平,真正拉开差距的,是端侧算法补得齐不齐。
规则也在重写。10月中旬,中科曙光牵头的国家标准《智能计算集群高速网络管理技术规范》获批立项,计划号20264903-T-469。 过去厂商方案互不兼容,标准要解决的就是这套隐形成本。ICT探索
这背后是一个更大的选择:IB性能最好,但核心生态握在英伟达手里;RoCE能跑在以太网上,却要面对跨厂商兼容和调参的麻烦。
不止一家在动。字节的EthLink、腾讯的Eth-X、中国移动的GSE,都在以太网上重构协议栈;华为则把灵衢做成系统级总线。国产标准想做的,是把管理和生态拿回自己手里。
对准备建集群的人来说,存储网络这笔账,不能只看交换机的端口速率。至少要看三件事:端到端能不能跑满,拥塞时会不会雪崩,坏了一条路能不能无感切走。
标称400G不等于业务能拿到400G;无损配置也不是打开PFC就完事。最好拿真实负载压一遍,看尾延迟,看故障切换时间,看重传起来以后带宽还剩多少。
过去存储网络是机房里的水管,埋在墙里,没人天天盯着。现在它决定GPU等多久、token花多少钱。下一次训练卡住,先别急着加卡。看看数据,是不是堵在路上。