
Anthropic 最近把一件挺狠的事摆上了台面:让 Claude 自己写一段程序,来管理一群 Agent。
这套叫 Dynamic Workflows(动态工作流)的东西,已经挂在 Claude Managed Agents 里跑 Beta。它和以前的 Subagents 最大的区别是:调度逻辑不再是人写死的任务清单,而是 Claude 当场生成的一段真程序——由它决定什么时候启动子 Agent、怎么传中间结果、要不要重跑、要不要终止。参数也确实唬人:单次工作流最多能累计拉起 1000 个 Agent,同时运行的上限是 64 个,最长跑 24 小时。36氪
B站上同类玩法的视频已经跑到近 50 万播放,评论区被顶到 225 赞的一条吐槽说得很直白:“只是耗费 token 超过整个团队而已”。哔哩哔哩
在动手之前,有三个藏得很深、但恰恰最要命的细节得先拎出来。
第一,completed 不等于成功。 官方文档里有一条尤其得注意:工作流返回 completed,只说明那段程序执行结束了。哪怕一部分线程的任务失败了,甚至某个线程压根没创建起来,整个运行照样可能以 completed 结束。你要是把 completed 当绿灯直接验收,这事就废了。36氪
第二,预算不是硬天花板。 会话级预算到顶后,系统会停止发新请求、任务暂停——但已经发出去的请求还会跑完。多 Agent 并行的时候,最终账单是会越过你设的上限的。36氪
第三,子 Agent 之间不能直接对话。 它们靠编排程序加共享文件系统来衔接,线程跑完就归档。所以“让几个 Agent 互相商量一下”这种设计,在架构层面根本不成立。36氪

这三条指向同一件事:多 Agent 的难点从来不在“开得多”,而在“收得回”。有位开发者把这层窗户纸捅得特别准:子 Agent 停下来有好几种原因——正常说完、预算用光、被打断、报错,而父 Agent 很容易把这些全都读成“完成了”。36氪知乎
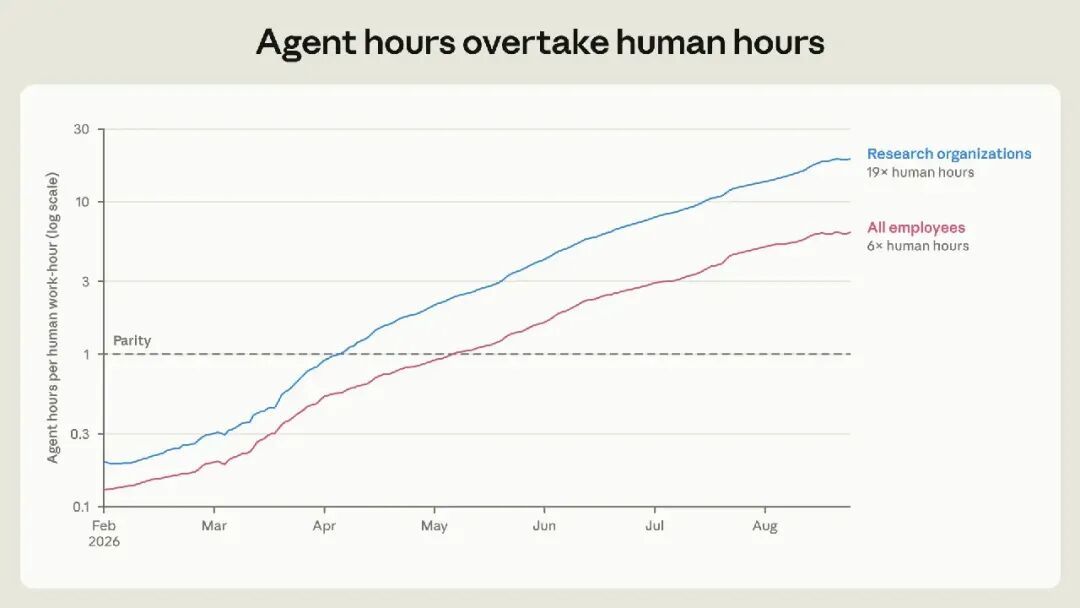
再看人的这一头。Anthropic 自己公布的数据是:截至 2026 年 8 月,公司整体 Agent 与人类的工作时长比达到 6:1,研究部门高达 19:1;技术部门初级员工占比从 2025 年初的 21% 掉到 14%,新招的人里初级只占 9%。36氪
而开发者的体感是另一回事。有位开发者算过一笔账:同时开 10 个 Agent 分别修 Bug、写测试、升级依赖、处理需求,结果是自己一天到晚在看代码、回复 Agent、解决冲突,瓶颈基本还是在自己这里,而且更累。知乎
所以真正该记下来的不是“能开 1000 个”,而是下面这几条能直接省钱的判断。
能 workflow 就别上 agent。 工具越简单,崩的概率越低,成本越好控,维护越省心。这句话比大多数框架文档都值钱。知乎
别一上来就开大任务。 有小功能先拿小功能试,五个功能五个 Agent 起步,跑通了再加。派出去的任务越大越复杂,出问题的概率越高,失败后的损失也越大。
把验收写进编排,别留在事后。 既然子 Agent 的失败会被读成“完成”,那就得在调度程序里显式判断这个结果到底算不算数,而不是等它跑完自己去翻。

别指望它自己变好。 Anthropic 的人明确说了,Dynamic Workflows 目前没有内置自我改进能力。它是一套调度机制,不是一个会自己长本事的系统。36氪
一句话收尾:这次升级真正改的,不是你能开多少个 Agent,而是“编排”本身变成了要写、要测、要 review 的代码。
Prompt 工程没了,Context 工程火过一阵,现在轮到你写调度程序了。













