今天早八,不少程序员打开KimiCode,发现模型栏多了个新名字。10月24日凌晨,月之暗面发布Kimi K3.1 Pro:2.8万亿总参数、每次激活104B、100万Token上下文,网页版、App、KimiCode和API全部立刻能用——但权重,要等到11月4日前才放。“先用后开”,就是这颗3T巨兽眼下最微妙的地方。跑分党说它把开源和闭源的差距从12分干到3分;体验党说它"狂写1.5小时憋坨大的";社区还有人在传它买KOL发软文。三条都真,三条都不完整。这篇只替用编码智能体、盯本地部署的人把三笔账分开算完:跑分账、账单、水分账。微博
先把时间线补全:它其实已经"裸考"了两天
发布会前,K3.1的痕迹是一点点漏出来的。把各平台散落的信息拼起来,大概是这么一条线:
9月底,有开发者发现月之暗面API注册信息里冒出`kimi-k3-1`标识,开放平台短暂出现过代号K311111的模型。36氪
10月中旬,Kimi官网前端代码被翻出`make3d`、`AUTOMATION_K3`、`OK_COMPUTER_SWARM`等功能标识;
10月20日前后,SGLang仓库提交了针对`moonshotai/Kimi-K3.1`的适配代码,顺带暴露了一个细节:K3.1沿用K3的Tokenizer,但把思考档位从low/high/max三档扩成四档,新增了medium。
10月21日,KimiCode配置里直接出现"k3.1",当晚再查就变404。
10月22日凌晨,Arena上冒出匿名模型Kibitz。老玩家秒懂:K2.5叫Kiwido、K2.6叫Kiwire、K3叫Kivine,K开头加后缀,这是Kimi家打榜的命名规律。追踪账号@aitrackerbot还用11个Moonshot家族特征Token做了复述测试,Kibitz连续两轮答错,和其他Kimi模型错法一致。
也就是说,正式官宣之前,社区已经替它做完了一轮"裸考"。
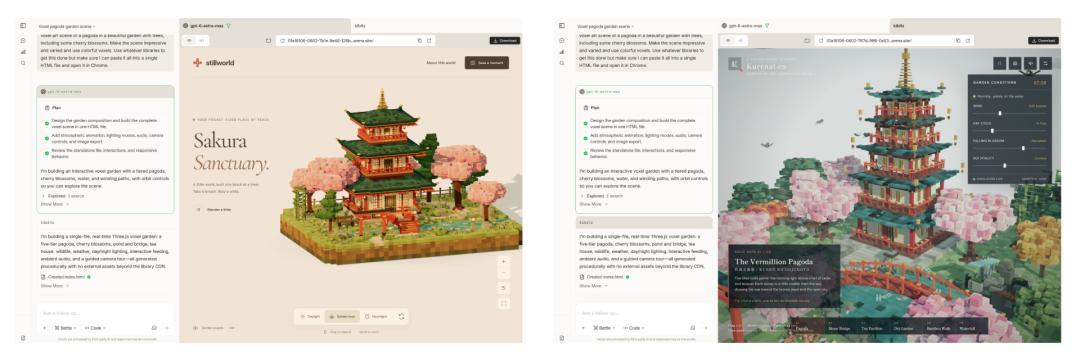
这次不一样的是官宣节奏:10月23日,Kimi官方账号发了一段24秒预热视频,复古CRT屏幕上直接写着Model: Kimi K3.1,当场用Three.js搓了个三维场景。凌晨就发布、API直接可用。同一天,智谱借1024程序员节送5亿Token。MiniMax前一天刚把"太空兔"真身M3.1 Flash(428B总参数、激活23B、1M上下文)的权重开源。国产旗舰最近像约好了似的,你方开源罢来我方开源。36氪微博哔哩哔哩
跑分账:0.7分和3分,哪个才是真的它
官方主打的叙事是"代码、Agent和知识类基准达到或接近最强闭源模型"。把公开数据摊开看,这话有底气,也有前提。
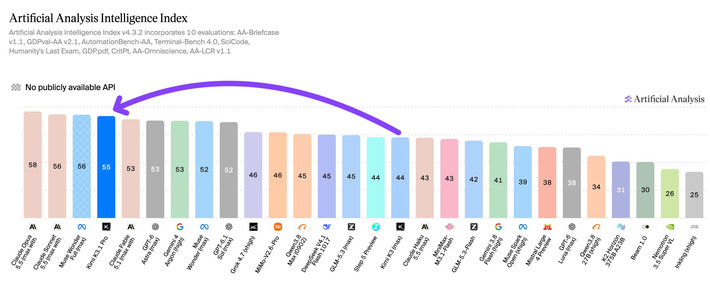
底气这边:Artificial Analysis智能指数上,K3.1 Pro拿了55分,排总榜第四,比三个月前的K3涨了11分;排在前面的三个是Claude Opus 5.5(58分)、Claude Sonnet 5.5(56分)和Muse Wonder Full(56分)。社区算得最狠的一笔账是:开源和闭源在智能指数上的头名差距,从上一代的12分缩到了3分——而且这个55分是API版的成绩,等11月4日权重放出来,它大概率就是榜单上最强的开放权重模型。分项基准里,它拿的是"偏科状元"剧本:SWEMarathon 51.7、Humanity’s Last Exam 70.0、ZeroBench 63.0都是第一。编程智能体测试Terminal-Bench 4.0拿了65.7%,超过GPT-6 Astra(58.2%),离Claude Opus 5.5(66.4%)只差0.7分。微博微博哔哩哔哩
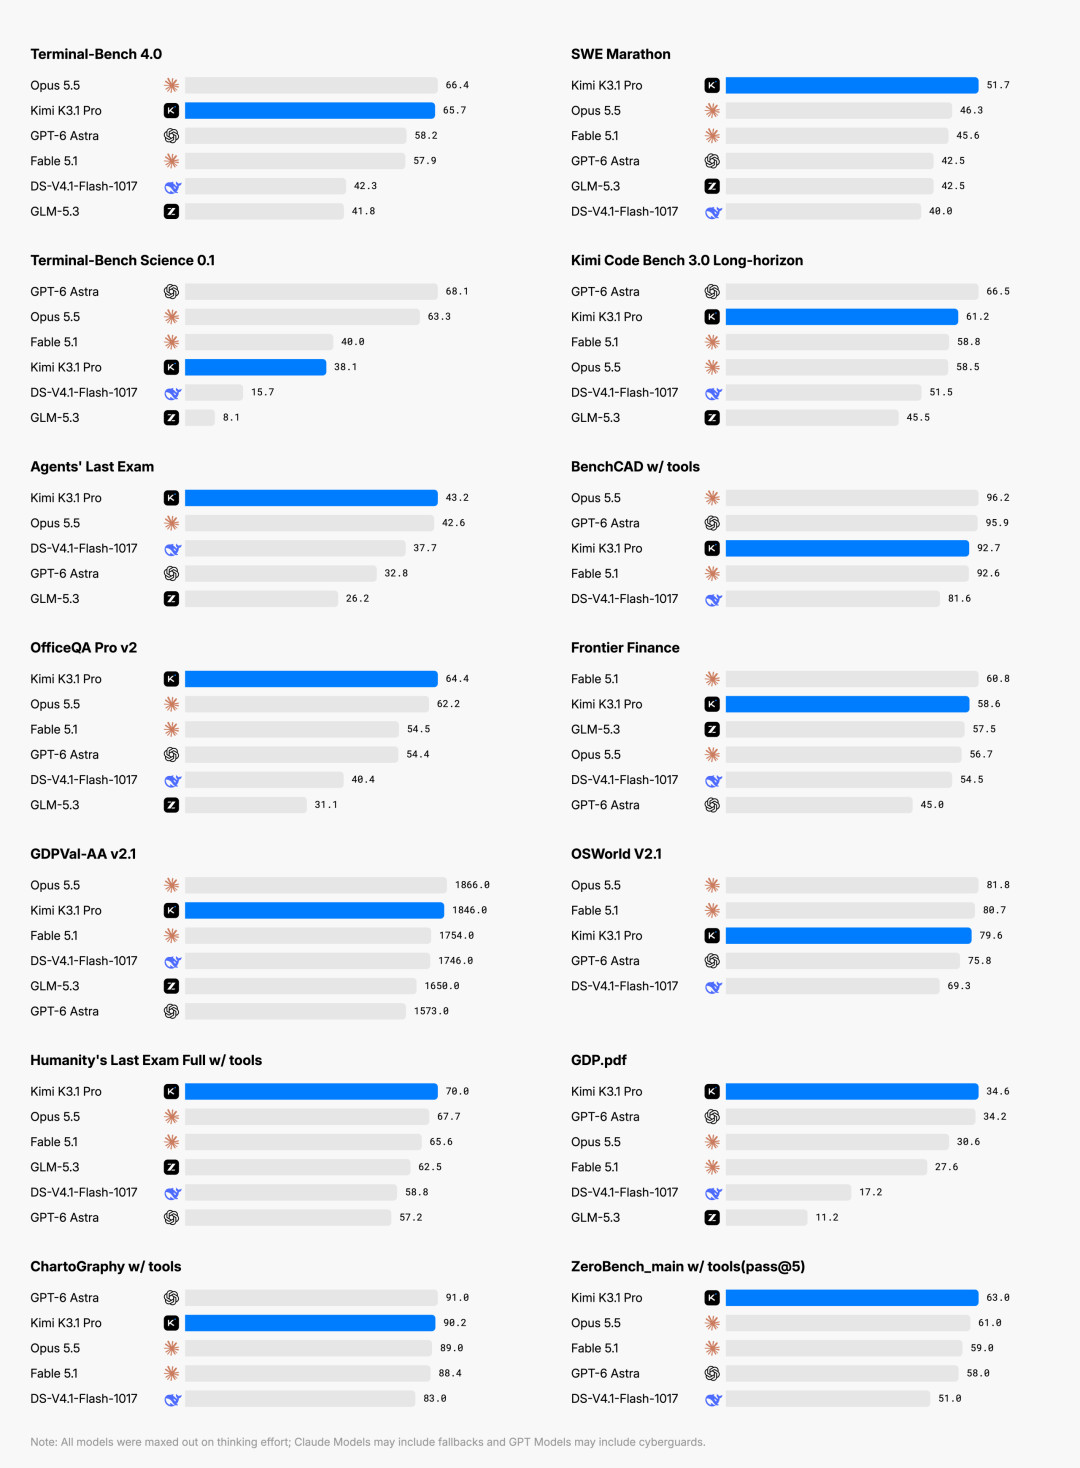
前提这边,恰好也在这0.7分和另一些榜单上。有UP主把官方14组基准逐条对完,结论是"有赢也有输":BenchCAD排第三,科学类终端任务明显落后。Arena裸考期社区实测同样不是一边倒——Kibitz做3D体素庭院只用了GPT-6 Astra Max三分之一的时长。但有人横评Kibitz、Kalmia(疑似阿里Qwen新马甲)、Gemini 4 Carbon和Opus 5.5之后,更看好Carbon的作品。换句话说:长程编程、前端、3D生成是它的主场,科学推理和精密CAD不是。你要换的是主力编码工具,还是全能助手,先想清楚这个问题再往下看。36氪
还有一个容易被欢呼声淹没的细节:月之暗面官方说,在开放权重之前先做了安全评估,主动把模型的漏洞研究得分从90.5%压到了81%。这个动作一石二鸟。OpenAI那句"最先进大模型绝不能开源,否则将摧毁网络安全",这两天刚被知乎热问围观。主动压分,既是给这套闭源话术一个正面回应,也意味着11月4日你下到的权重,和今天API里这个55分,不是同一个东西。微博知乎
账单:68元和两倍价,Kimi是读过对手价目表的
API定价这次变化值得单独算一笔:
K3.1 Pro标准版:每百万Token输入$2、输出$10(官方国内口径输出68元/百万Token);高速版Highspeed智能与标准版相当、输出快2到3倍,价格翻倍。微博
前代K3是输入$3、输出$15——能力涨了11分,价格反而砍了三分之一。36氪
对照闭源阵营:Claude Opus 5.5目前是$4/$20,Sonnet 5.5是$2/$10。
看懂了吗?K3.1 Pro把自己钉在Sonnet 5.5的价格上,却去打Opus 5.5的活。这跟上周DeepSeek把旗舰"干退役"后按任务算账的思路是同一个方向:国产旗舰这一轮竞争,价格战和跑分战是同时打的。
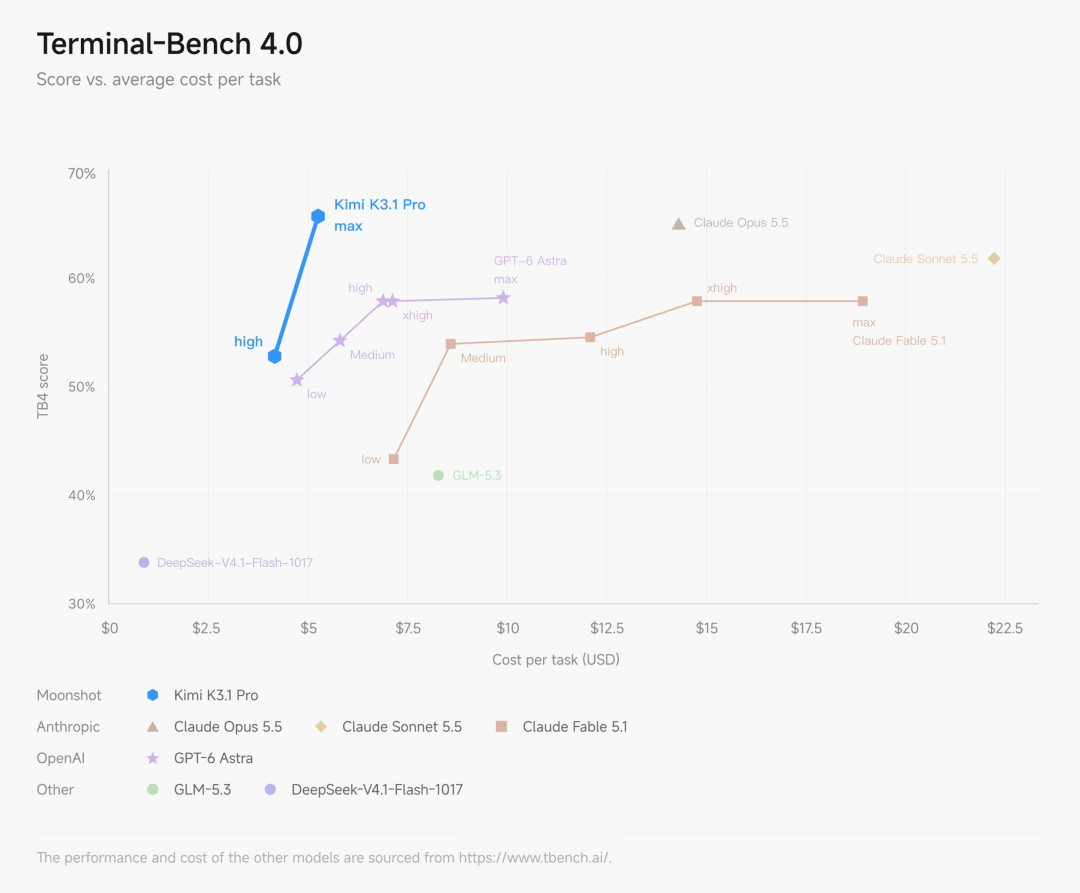
至于"等开源"那笔账,别被"开源=白嫖"带偏。2.8T总参数、104B激活,这是数据中心级玩家的体量——权重免费,推理不免费。个人本地部署104B激活的MoE,显存门槛就够普通显卡喝一壶,多数人的现实选项是租算力跑,每百万Token摊下来未必比官方API的$2/$10便宜多少。对重度agent用户,真正决定成本的不是输入输出单价,而是medium档位:以前low/high/max三档是"快或准"的二选一,现在多了一个中间档,社区预期这一档能把日常改代码任务的思考开销压下来——账单大头从来是输出Token,档位选择器就是节流阀。
水分账:软文疑云和翻车,该不该计入决策
发布当天,X上有博主爆料Kimi花钱请了不少KOL发软文,国内平台跟着刷屏,讨论热度不少但信源目前只有传闻级别,月之暗面没有回应。这条只能记"存疑",不能记"实锤"——但发布当天营销铺量、跑分海报先上,这个观感本身就够社区玩一天的梗。小红书
社区实测的信号也是分裂的:有"9个项目实测"夸它Blender建模、3D魔尺、工业纪录片的交付质量(赞91评55),也有"狂写1.5小时憋坨大的"的首测吐槽——UP主自己的原话是"刚做完有点小失望"。还有人吐槽发布这两天Kimi明显变慢、回答挤牙膏。样本就这么点,谁也别急着下结论。跑分和体感之间隔着的,是你的任务分布:它恰好是你的主场任务,实测就是"真香";它偏科的地方,你碰到的就是翻车。哔哩哔哩微博
所以判断标准别外包给任何人,包括这篇。社区已经沉淀出一套自测法:固定一组你自己仓库的任务,看四个数——一次通过率、重试次数、Token账单、人工返工时间。11月4日权重放出那天,同一组任务再跑一遍。这组数字比任何榜单都值钱。哔哩哔哩
怎么办:谁现在就该动手,谁能再等11天
编码智能体重度用户(Claude Code/Codex订阅党):可以先试用,别急着换主力。API今天可用,$2/$10的价格试错成本很低,跑上面那组四数自测;你的主链路上,Opus 5.5在Terminal-Bench上还压着它0.7分。
想本地部署的个人/小团队:等11月4日,但先把算力账算明白——104B激活不是消费级显卡的事,SGLang适配代码已提交,权重放出应该就能跑。租算力跑开源版和直接买API之间,大多数人的答案是后者。
只把Kimi当聊天/办公用法的轻用户:不用动。网页版和App默认升级,你不碰API账单和权重部署,这次的3分差距跟你暂时没关系。
看热闹的:这轮值得记的不是"国产追平闭源",而是一个趋势——上周DeepSeek、前天MiniMax 428B、今天Kimi 2.8T,国产厂商正把"旗舰级开源"变成常态动作,而Anthropic、OpenAI在用反蒸馏和"绝不能开源"叙事筑墙。12分缩到3分只是这一轮的比分,墙两边的路线之争才是接下来半年真正的主线。微博
继续盯四个信号:11月4日权重是否如期放出、放出后的安全阉割版(漏洞研究81%那条线)实测和API差多少、Terminal-Bench那0.7分有没有第三方复现、软文爆料有无实锤或回应。到时候再决定站队,来得及。