10月20日,DeepSeek 官宣把自家生产级的推理引擎开源了,名字叫 DeepInfer。哔哩哔哩微博
注意 README 对它的定义毫不含糊:这是实际支撑 DeepSeek 大规模生产服务的推理框架——不是"教学玩具",是真在扛线上流量的那套东西。GitHub
这波在开发者圈的讨论度不低。B站的解读视频《DeepSeek最新开源的推理框架DeepInfer是什么?》上线于 10 月 27 日。几天下来近 8000 赞、6.7万播放,评论区还在玩"这公司就梁文峰没开源[doge]"的梗。但玩笑归玩笑,大家追问的方向出奇一致:这东西能干什么,和它不干什么。哔哩哔哩
它能干的:不只是更快,主要是"跑对"
DeepInfer 不是另起炉灶,README 承认它是基于 vLLM 搭的,再参考了 SGLang 和 TensorRT-LLM。PD 分离这种事 vLLM、SGLang 早就有了,不算独门绝活。真正值钱的,是三个偏"正确性"的功能:GitHub知乎哔哩哔哩
批次不变性:换了 batch 组合,模型输出逐位不变,开一个环境变量就能用。GitHub
确定性采样:同输入、同采样参数就是同输出,调试终于不用"跑十次取三个样本"。
结构化输出:原生支持正则、JSON schema、EBNF 语法约束。
知乎上的分析还点出,配套放出的 deepseek-recipe 是这次发布里最实用的部分:system prompt 怎么拼、思考模式标记怎么插、工具调用怎么序列化、多轮对话里推理内容留不留,以前全靠各家第三方自己摸索,现在有了官方参照实现。知乎
它不干的:把"省钱"的部分留给了自己
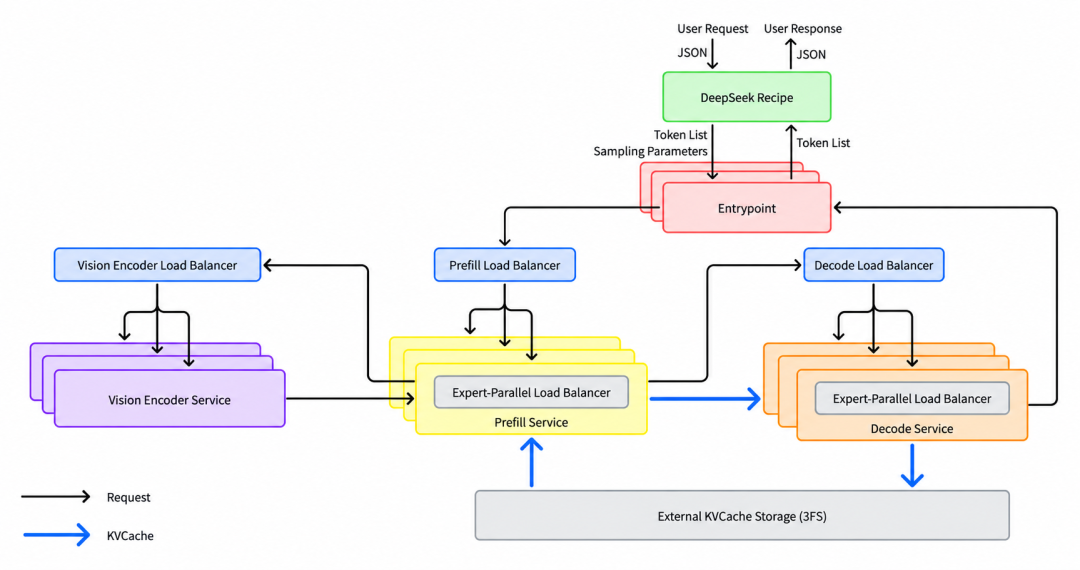
README 末尾的 Required 清单才是本次开源的关键:跑一个完整服务还需要 KV cache 系统、Prefill/Decode 分离部署、跨副本负载均衡——这些都没包含。视频评论区有句话挺有代表性:“PD分离那段终于听懂了,但调度器不开源有点可惜”。这个切分很清醒:正确性开源,对生态和品牌都好;调度层是真正的成本护城河,留给云厂商和自己的 API 继续竞争。GitHub哔哩哔哩
三类人要重新看这张牌桌
买"低价满血"API 的人:官方参照实现摆在那,以后拿官方评测对着第三方逐 token 比对就能验证有没有缩水,靠信息不对称吃差价的空间会被明显压缩。
vLLM/SGLang 用户:官方参考实现成了明确考纲,哪个社区框架离官方基线更近,跑分一目了然。
打算自部署的人:硬件支持 NVIDIA SM100 和华为昇腾 950,但批次不变性和确定性采样目前仅 NVIDIA 可用,昇腾上性能路径通了、可复现路径还没打通。知乎
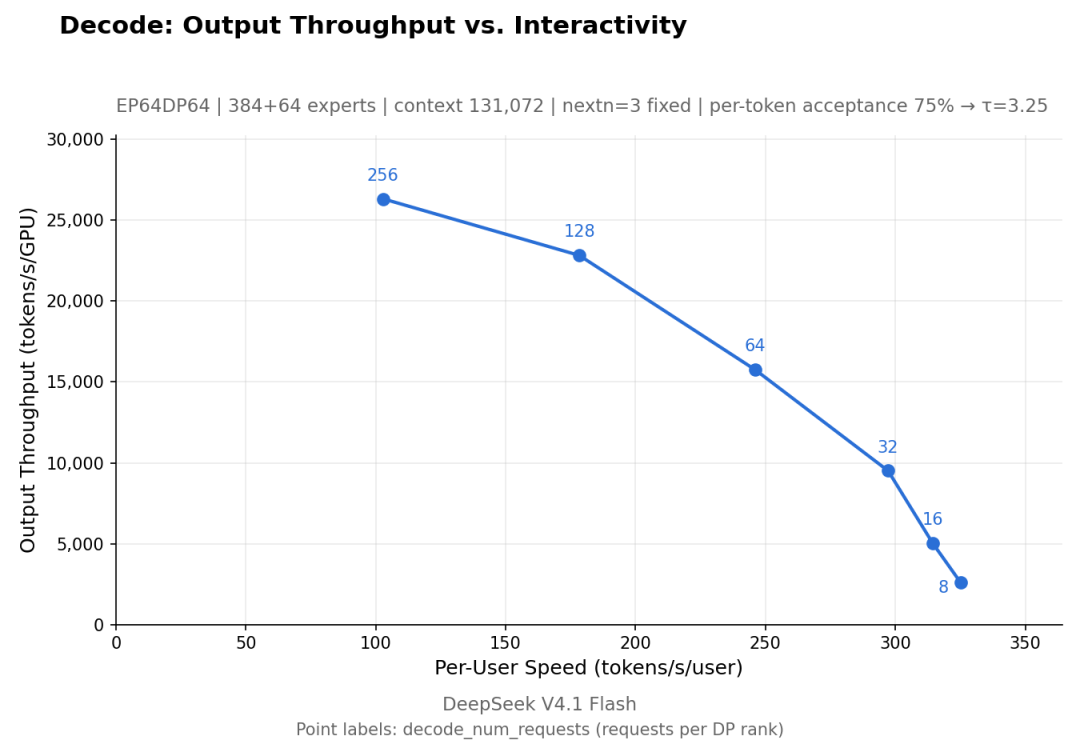
要不要跟? 已经在用 vLLM/SGLang 跑通用模型的,不急着重构,更划算的第一步是先跑一遍官方 eval 立起自己的质量基线。目前它只适配 DeepSeek-V4.1-Flash,默认 checkpoint 名字里就带着 1017,是刚出炉的版本。许可证 Apache 2.0,商用改造没什么顾虑。真正值得盯的是趋势:开源模型正从"开放权重"走向"开放行为"——权重只是文件,行为才是用户实际感受到的东西。DeepInfer 是这个转向的第一份官方示范。GitHub知乎