10月15日晚上,三家公司同时放出了权重:蚂蚁百灵的 Ling-3.1-flash(总参数560B、激活约25B,MIT许可)、阶跃星辰的 Step 5 Preview(600B/27B)、Meta 的 Muse Spark Open(816B/42B)。宣传语都精准戳在本地部署党的心趴上——“部署从8卡降到4卡”“两台Mac Studio就能跑”。知乎
第一处小字:4卡的"卡",是谁的卡?
百灵的省法是真刀真枪:512个路由专家压到4-bit(MXFP4),dense层保守留在block-FP8,权重占用砍掉45%、从约534GB降到292GB,官方测试配置里的服务部署从8卡降到4卡。但把官方部署建议展开看,推荐的是8张H200或4张GB300,"4卡"是数据中心级的卡——同期阶跃的Step 5 Preview FP8版本同样要单节点4张B300或8张H200。对比一下真实社区:小红书上晒自建机的玩家,主力是12G显存的RTX 3060跑量化模型,顶配也就一张4090。36氪知乎

官方自己都在冷水段写得明白:实际卡数随上下文长度、并发量和服务配置变化,4卡是特定测试条件下的数字,不能直接当采购清单。36氪
还有个仓库细节:已发布配置的 max_position_embeddings 是262,144——"百万上下文"目前写在模型卡的目标栏里,今天真能验证的是256K这一档。 这和9月30日"免费体验只给25.6万、百万窗口等付费"被骂的顺序,几乎是同一个剧本。36氪
第二处小字:跑分之前,先问考具是谁。
Terminal-Bench 4、SWE-bench Pro 这两组成绩,是在百灵自家的 LingCode 框架上跑出来的,而 LingCode 本身尚未开源——用没开源的考具考出来的分,别人暂时没法复现。36氪
更稳的信息来自独立口径:ArtificialAnalysis 给出智能指数41、输出速度约每秒210 token;KiloCode 的托管价输入$0.30、输出$0.90、缓存读取$0.06(每百万token),是典型的"执行层"定价。上手实测则立体得多:MindStudio 测下来,它SQL调优能单点命中最高影响的修复方案、单发SVG质量不错、医疗问答结构完整;但到了需要长链条工具调用的复杂Agent任务——比如从Blender到Godot搭一个完整游戏管线——成品是"能跑完,但游戏是坏的"。低资源语言同样短板明显。同一天撞车的三家也各有打法:阶跃选"窄而深"的92层结构、把上下文压缩直接纳入端到端训练;Meta 在 SGLang 里配了自动调优的 Helion GPU kernel,官方称在 NVIDIA 与 AMD 上拿到1.03到3.95倍的kernel级加速;蚂蚁则用63层线性注意力配9层Gated MLA按7:1排布。竞争的计价单位,正在从"跑分"换成"每卡每天能跑多少活"。36氪知乎
第三处小字:算自己的账,别只看厂商的账。
知乎用户Mr Lu晒了真实网关账单:9天19539次请求、输入1810万token、输出849万token、缓存命中99.11%,按官方API定价折算9天65.39美元、月均约218美元、人民币1500块上下。知乎
自建这边呢:跑个能用的32B模型,24G显存是底线,二手4090一张1.3万起步,加机箱电源散热,一次性接近2万;租云GPU,A10每小时3到5元,7×24跑满一个月2200到3600元。还有三笔不写在账单上的隐性成本:量化损耗(INT8/INT4之后长文本理解和工具调用的掉点是实打实的)、上下文与并发(单卡把上下文开长直接OOM)、缓存(官网API的缓存读取价只有输入价的十分之一,本地省不掉,因为显存成本本来就是你自己的)。知乎
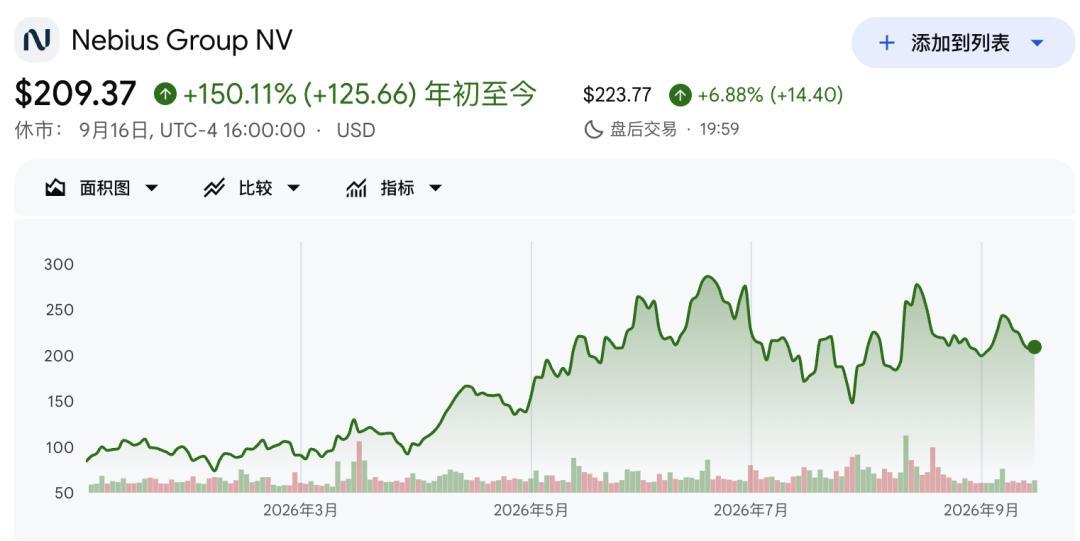
算力这条曲线也还在往上走:Nebius宣布10月1日起全面上调GPU云服务定价、平均涨幅约20%,覆盖H100、H200、B200及B300多款芯片,这已是其今年5月以来的第二轮涨价;台积电Q3净利同比涨68.7%,管理层直言先进制程需求依然强劲、产能仍紧。想等算力降价再上项目的人,双11这个节点大概率还要再等。知乎36氪
三类人,三条路线
个人轻度用户(写代码、写文案、查资料):先别动。继续用API就行,KiloCode上架价输入$0.30、输出$0.90/百万token、缓存读取$0.06,正好拿来对照你手里订阅是否贵了。等第三方复现跑分、等LingCode开源,再谈换主力。36氪
小团队(数据出不了内网、月账单超2000元):只有"数据不能出内网"和"月账单超过两千块"两条同时成立,本地部署才开始回本——这是社区实测下来最硬的一条判断线。SGLang、vLLM部署路径已随仓库放出,官方口径本来就是让团队在自己的任务和算力环境中检验模型,先拿真实业务在256K档试一轮,别拿榜单当采购清单。知乎微博
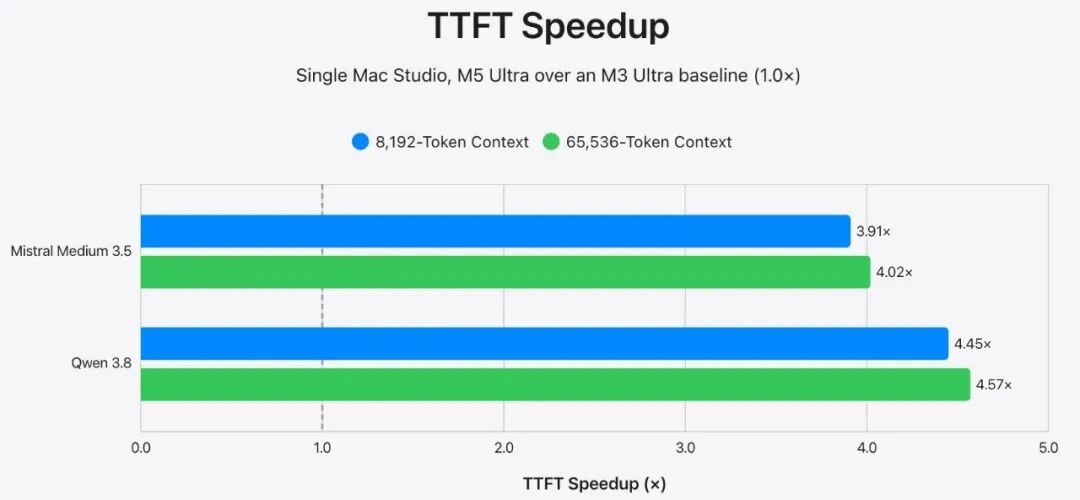
果系生态、想单机尝鲜的:Muse Spark Open压缩后权重约493GB,单机放不下,需要两台512GB统一内存的M5 Ultra Mac Studio,或者四台256GB的;苹果同日晒出MLX技术博客,演示其在两台至四台M5 Ultra Mac Studio上本地运行,四机张量并行达36.7 token/秒,高于人的平均阅读速度,演示里模型完全离线地给一个开源iOS应用提交了真实代码改动。门槛是"Mac Studio级"的预算,买的是"数据不出门"。知乎36氪
许可小字也要读:蚂蚁把 Ling-3.1-flash 放在 MIT 许可下,任何人都能下载、修改,并直接塞进商业产品;阶跃的StepFun Model License 1.0是Apache风格但带署名与商用条件;Meta的Muse Model License设有商业限制。Meta首席AI官Alexandr Wang说得更直白:公司原则上不会对最强性能的模型开源,但会持续向开发者社区开放性能稍低的版本。"开源"在2026年10月不是开关,是旋钮。知乎
接下来值得盯的信号:百万上下文配置什么时候真正进仓库、LingCode何时开源、OpenRouter用量榜(Step 5 Preview据OpenRouter截至10月15日数据已位列token用量周榜与日榜全球第二)、以及双11期间显存和显卡的价格走向。知乎
权重已经在那儿了,256K这一档今天就能跑。要不要为它掏钱建机,你的业务账单会给答案,宣传稿不会。