10月26日下午,Anthropic向SEC递交了IPO招股书(Form S-1),文件里一句话直接冲上微博科技热搜第三:2026年9月他们对代码库的贡献中,超过90%由Claude完成。 评论区照例裂成两派:一派喊程序员要失业,一派说AI写的我根本不敢用。微博知乎
但把招股书、官方博客和中文社区的讨论盘完一圈会发现:传播中最热的几个数字,口径全被搬错了。而这份招股书里真正该被每个用AI写代码的人认真读的,不是90%,是另一个几乎没人提的组合数字——合并的PR翻了一倍多,回滚率反而降了四成以上。
先把这波数字的口径分个类
"90%"不是全公司口径。 招股书写的是"对代码库的贡献",Claude Code团队官方博客里给的口径更保守:真正合并进生产环境、可归因到Claude的代码行约占80%。 知乎上点赞靠前的考据回答也指出,90%只对Claude Code自己的仓库成立,脚本和实验代码都算在内,且"过半由内部Claude Tag合并"是另一条公司级口径。知乎知乎
"人均产出45倍"要小心读。 招股书披露2026年7—9月每位工程师日均贡献代码量是2024年平均值45倍以上,同期员工总数涨了5倍。注意口径是"贡献的代码量",不是"干的活的价值"——AI一天提交的diff里,大量是过去不会由人手敲出来的部分。这个数字更适合读成:写代码环节不再是瓶颈。知乎
"日均改动2500到30000"也不是Claude Code仓库。 这是Anthropic单体仓库(monorepo)每天合并的改动量,今年5月约2500个,9月超过30000个。它是理解审查压力的背景板,不是某个工具的战绩。知乎
把错位的数字归位之后,剩下的问题就一句话:当AI把代码写得比人读得快,这套系统靠什么没崩? Claude Code团队在10月底首次完整公开了自己的代码审查流程,答案是一摞"带洞的筛子"。微博
六层筛子:每层都会漏,叠起来就很难漏到底
Claude Code约九成的代码由Claude自己写,他们的审查流程分六层,大部分是自动的,人力集中在高风险处:
第一层:提交PR前先"自证"。 不让AI一句"做完了"就交差,而是要求它当场跑测试、跑构建、把界面截图和设计稿比对,展示运行结果。之后由一个全新上下文的子Agent重读diff挑毛病。Claude Code创建者Boris Cherny估计,给Agent配一套验证流程,能把产出质量提升两到三倍——这比换模型本身的增益还大。知乎
第二层:每个PR上的AI审查。 审查Agent结合整个代码库和作者声明的改动意图检查diff:问题是否真被解决、能否融入现有架构、会不会破坏别处;修bug的PR还要找出根因。发现的问题先由多个Agent交叉核验、投票判断真实还是误报,风格类意见直接过滤。意见按严重程度分三档:Important、Nit、Pre-existing(既有问题不苛责本次作者)。这套产品(Code Review for Claude Code)内部上线后,收到实质性审查意见的PR比例从16%涨到54%。知乎
第三层:可阻断合并的安全审查。 只要还有未解决的安全问题,PR就合不进去;误报可以附理由关闭。官方同时开源了对应的安全审查GitHub Action。
第四层:自动化检查。 lint、类型检查、全平台测试、构建——一个典型的CLI PR在任何人看到之前,已经跑过几十项检查。
第五层:按风险分级的人工批准。 风险等级由"改动内容"决定,不由"作者是谁"决定。三条硬规则值得抄:Agent的批准不算数,不能替代人工批准;批准只对当前commit有效,后续推了新代码就必须重新批;认证、计费、CI、发布流程这类高危路径,固定要人点头。知乎
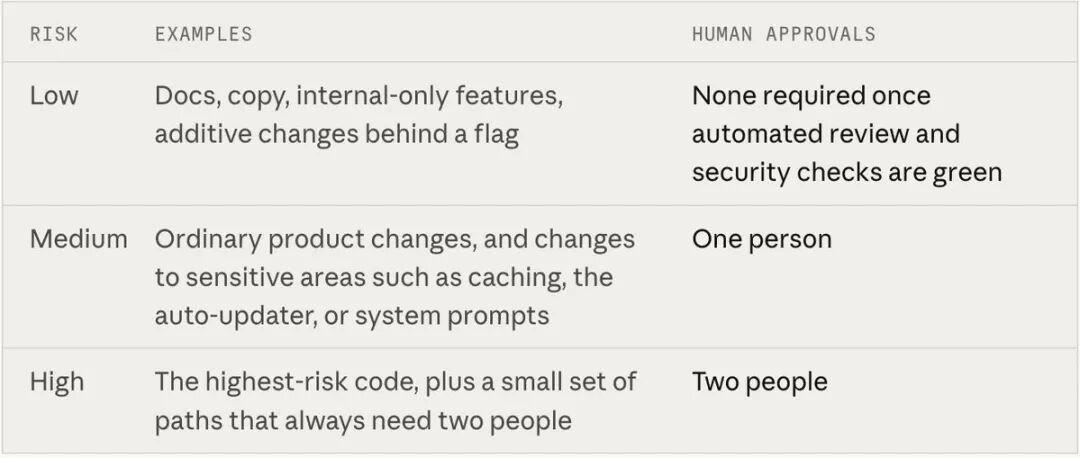
第六层:合并队列、功能开关、分阶段发布。 合并队列防止两个各自通过的PR合在一起把main搞挂;新功能先放开关后面内部试用,出事几分钟内可关可回滚。他们的团队共识是"谁合并,谁负责",前提是改动粒度小、一切可回滚。OIL译站
两个最不体面的数字,反而最值得抄
官方博文里坦白了两个翻车现场,比任何方法论都有用。
一次CLI项目的PR,作者Agent和审查Agent来回拉锯,一晚上循环了五十多次,最后是人工叫停的——不然它可能没完没了。 团队后来用git blame统计反复被标记的代码,发现约59%在第一轮审查时就已经存在:多轮审查很少抓到新引入的bug,更多是在每一轮里又翻出几个旧问题。知乎知乎
于是他们加了"收敛机制":审查三轮封顶,三轮不过就停下来重想整体方案;首轮之后的重审只看新增diff;报告要给出bug类别让作者一次修完同类问题;再让审查Agent每晚对整个代码库做全量扫描。引入之后,内部每个PR的平均审查轮次显著下降——下图是官方公布的收敛前后对比:一轮审查就修完的比例从65%升到78%,需要五轮以上的从8.9%降到1.5%。知乎

反常识结论就在这:审查轮数不是越多越安全,不收敛的多轮审查本身就是一种成本。 而那句更适合贴在每个人工位上的话是——如果你说不出自动化检查会漏掉什么,就别只求别人点个👍,你需要一次真正的人工审查。OIL译站
人力该花在哪:AI拿不走五件事
按官方说法,人类审查者依然不可或缺的只有五类:这东西到底该不该做(产品判断);计费、自动更新器、CI这类高危代码的审计;确立后续规范的架构审查;核验证据(测试输出、命令记录、截图);以及承担责任——每一个上线的改动,最终都要有一个具体的人负责。知乎
还有个容易被忽略的连锁问题:如果绝大部分"读代码"的活都交给了机器,团队对代码库的共同认知从哪来?官方给的做法是让任何人想了解哪块代码,就让Claude对那块生成一份讲解文档甚至可视化小工件——几分钟拿到永远是最新的解释,而不是逐行去读一行文案改动的diff。OIL译站

从个人到团队,抄作业的三档姿势
个人vibe coder(今天就能抄):提交前本地跑`/code-review`和`/security-review`,或开一个全新上下文的子Agent审改动。 把可运行的检查写进一份简短的CLAUDE.md;戒掉"它说做完了=做完了",要求贴测试输出或截图。小红书那位给自己做查房工具的外科医生、B站那条一晚31次提交把询盘从5做到43的SEO视频,卡点全在同一个地方:验证。知乎
10人以下小团队(一两周内抄):PR模板加三问——怎么测的、风险在哪、怎么回滚;建一份REVIEW.md沉淀反复出现的审查意见;按改动内容定风险等级,常规改动快速过,高危区域才上深度审查(官方给了Quick/Standard/Deep三档)。
正规工程团队(按月推进):合并队列、功能开关、以线上故障和回滚记录建评估集,每次改审查工具的提示词或模型就重新打分;追踪"每个PR人工批准数中位数/P95、人工评论数、等待时长",同时把回滚率和故障率当护栏指标——这两个指标一涨,说明你没省人力,只是把成本转移了。Claude Code团队把这套迭代叫做"我们的事故就是评估集":

最后:那一成不是留给谁证明"人还在"
热搜底下最高赞的吐槽是:剩下的那一成,是留给谁证明自己还在? 但把招股书和审查流程连着看完,结论恰好相反:Anthropic员工总数涨了5倍、PR翻倍、回滚率还在降,说明人的活没消失,是换了形态——从敲代码,变成写验证清单、定风险分级、审查证据、为合并按钮负责。微博
接下来值得盯的信号有三个。Code Review for Claude Code已对Team/Enterprise客户开放。 官方口径是,低风险改动在自动化检查全过后自动合并的边界还会持续外移。 审查工具本身的效果评估也值得盯——他们拿故障当eval每天打分。至于各家竞品跟不跟这套"六层筛子",很快就能见分晓。别为90%焦虑,先问问自己:你的AI说"做完了"的时候,你能不能拿出它漏掉了什么的证据——答不上来,才是这波热搜里最该改的那件事。知乎知乎