十月下旬开始刷 B 站本地大模型分区的人应该都发现了:教程的关键词变了。以前是"保姆级安装"“一次讲透显存量化”,现在从 10 月 26 日的 DeepSeek-V4.1-Flash-1017Strata 版部署教程(半天 3300+ 收藏),到更早那期《本地大模型保姆级教程|安装、概念、接入 Agent,你自己的 AI》,卖点都从"装得上"换成了"会干活"。哔哩哔哩
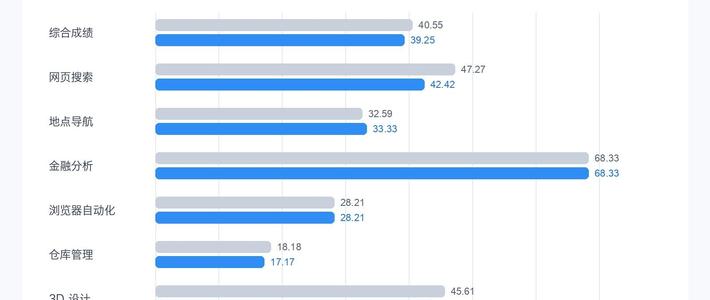
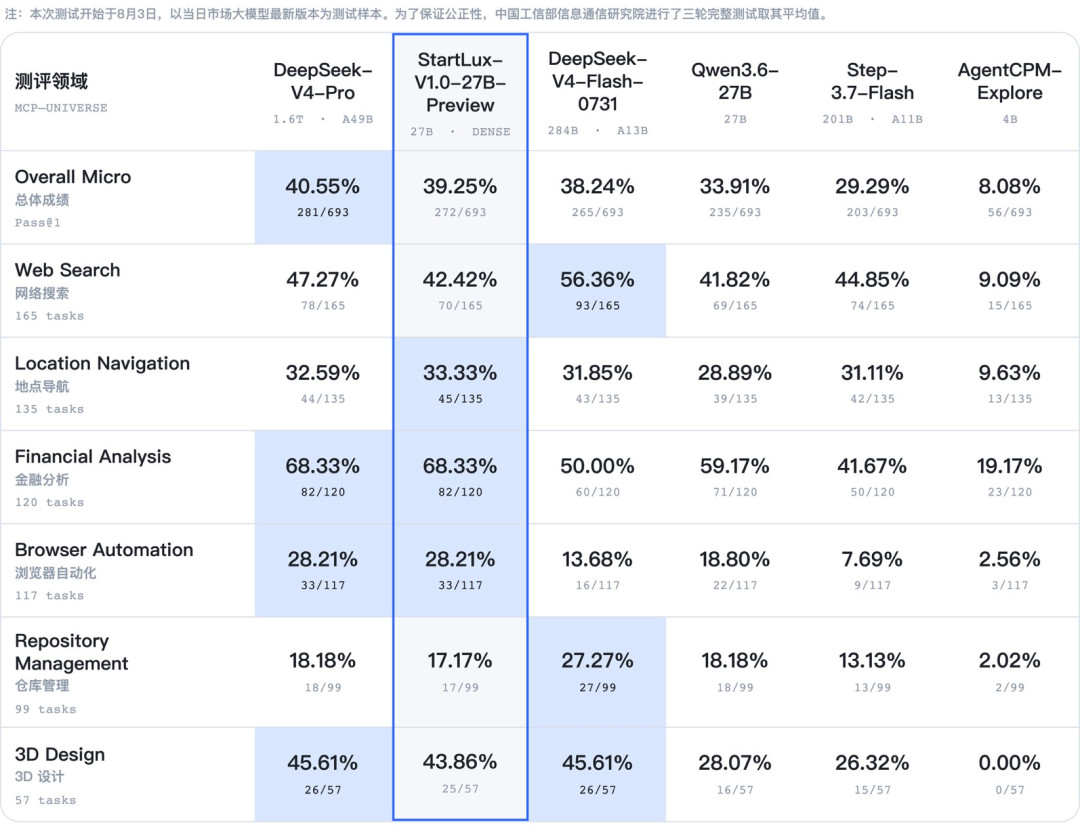
变化背后有一份硬成绩单:中国信通院人工智能研究所公布的可信 AI 大模型基准测试 MCP 专项里,27B 的本地模型 StartLux-V1.0-27B-Preview 以综合得分 39.25 排名第二,超过了 284B 的 DeepSeek-V4-Flash-0731。 知乎问题《中国信通院测评:27B本地模型接近万亿级旗舰模型,这意味着什么?》下,高赞回答把这轮测试拆到了任务粒度:231 个任务、完整跑三轮共 693 次,StartLux 做对 272 次,1.6T 的 DeepSeek-V4-Pro 做对 281 次。36氪知乎
对手里已经有一台能跑 7B/8B 的存量机、正琢磨"要不要把本地模型接进 Agent 工作流"的人来说,这份成绩单改变的不是装不装得下的问题,而是你该先看哪几笔账。
第一笔账:这张榜单的含金量——证明了什么,没证明什么
先看参测名单:DeepSeek-V4-Pro(1.6T)、DeepSeek-V4-Flash-0731(284B)、Step-3.7-Flash(198B)、StartLux-27B(27B)、Qwen-3.6-27B(27B)、AgentCPM-Explore(4B),任务覆盖位置导航、网页搜索、浏览器自动化、金融分析、代码仓库管理、3D 设计六类,外加一项综合评估。36氪
反常识的部分:27B 在工具调用上反超 284B,按过去两年"参数量=能力"的直觉,这事不该发生。原因写在训练路线里——StartLux 以 Qwen3.6-27B 为基座做了后训练定向增强,专门对着多工具协同、任务拆解这类能力练。 另一个常被忽略的细节:1.6T 的 V4-Pro 是 MoE 架构,评测图里在 DeepSeek-V4-Pro 后面标了 A49B,也就是每次推理大约激活 49B 参数,而 StartLux 是 27B Dense。 拿 1.6T 直接除以 27B 会夸大单次推理的计算差距,更接近真实的对比是"激活 49B 打 27B"。36氪知乎
但把分项拆开,冷水就来了:金融分析 StartLux 和 Pro 都是 68.33%,浏览器自动化都只有 28.21%;网页搜索 StartLux 42.42%,输给 Pro 的 47.27%,更远逊于 V4-Flash 的 56.36%;代码仓库管理 StartLux 只有 17.17%,V4-Flash 是 27.27%。 成绩散开的方向,恰好把每个模型的训练路线暴露出来。知乎
所以这份证据能支撑的结论是:定向后训练的 27B,能在 MCP 工具任务上逼近旗舰;它支撑不了的是:任何 27B 都能平替云端旗舰——写作、复杂推理、多模态、长代码根本不在这张表的覆盖范围内,通用能力需要另外测。 还有一个所有人都该看清的数字:这套任务的榜首总成功率也只有 40.55%,Agent 干活这件事,目前连云端旗舰都还没考及格。知乎
第二笔账:门票——你的机器跑 Agent,账要算在量化和 KV 上
先把 27B 的硬件账摆平:只算权重,FP16 约需 54GB 显存/内存,8bit 量化约 27GB,4bit 量化约 13.5GB,再加上 KV Cache、长上下文和运行时开销还在往上加。 这也是为什么"8-16GB 显存能跑 27B"的社区读数全部建立在深度量化加异构分片(比如 Strata 这类把权重摊进系统内存的方案)之上,“能跑"从来不等于"跑得舒服”。知乎
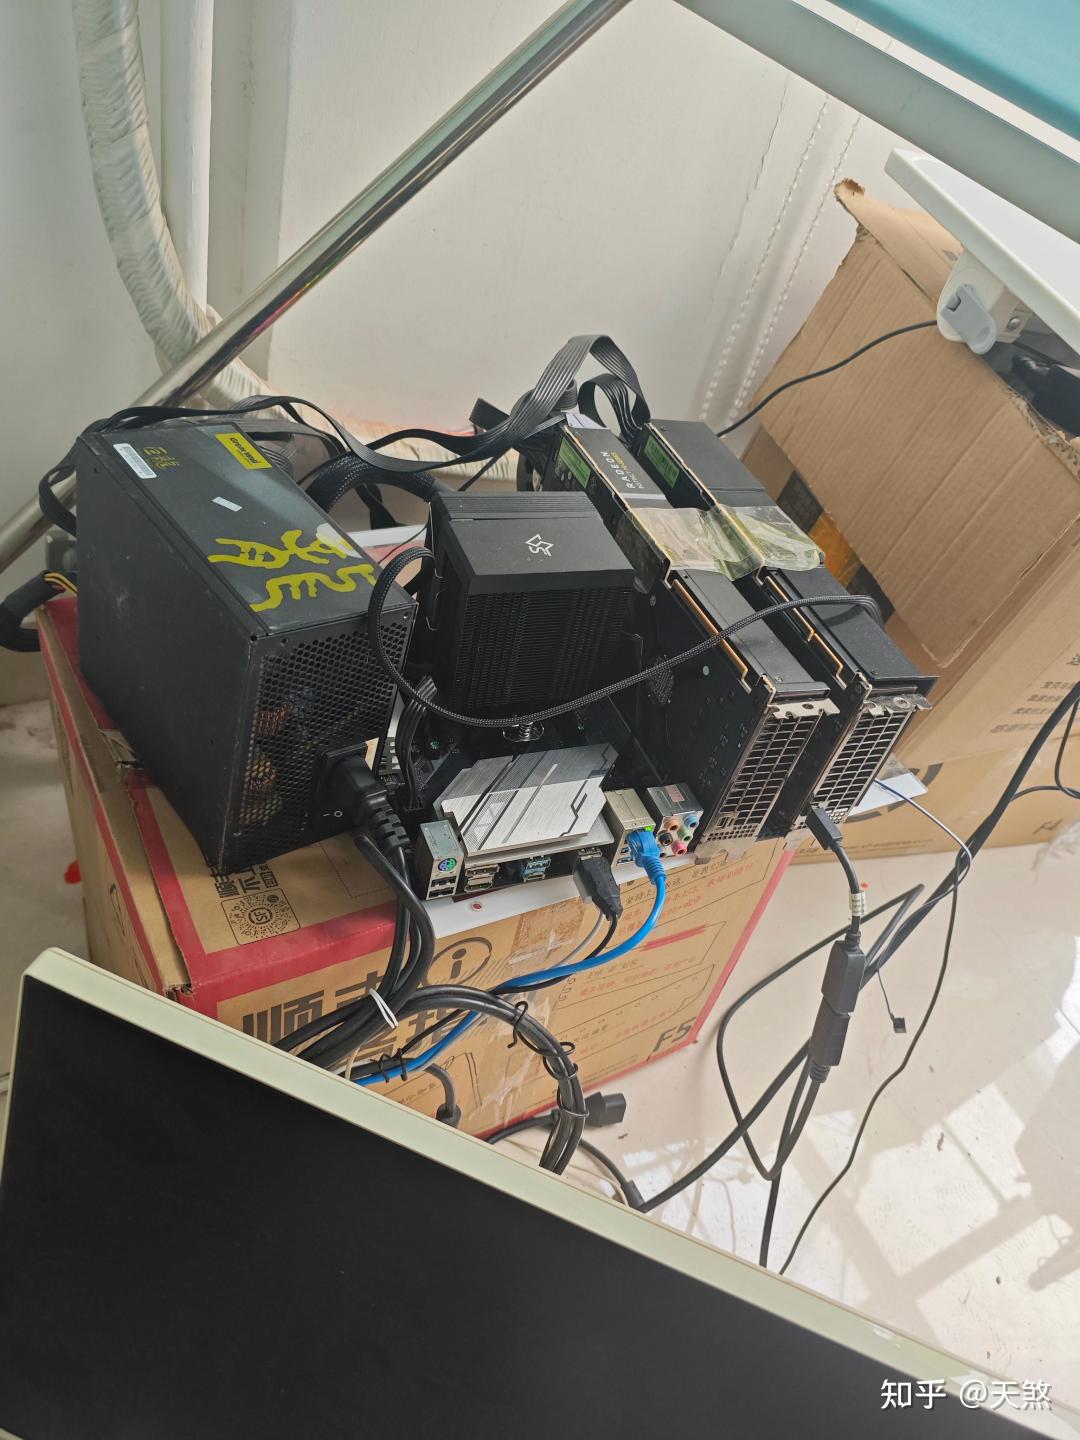
12GB 显存这一档,教程生态已经在推 DeepSeek-V4.1-Flash 的 Strata 版,连标题都直接写"12GB显卡就能跑"。 4B 这一档,像参测名单里的 AgentCPM-Explore,是老机器/核显入门 Agent 玩法的现实档位。存量机的极限操作也有真实样本:有人用两张 16GB 的 MI50、整机不到 2500 块钱搭了一台 Qwen3.8-27B 推理服务器,开网络端口给全家台式机笔记本供 token。哔哩哔哩知乎
判断自己的门票,别看跑分,看这三行:量化后的权重体积、你最常用上下文的 KV Cache 占用、推理引擎吃不吃得到你的显卡。三行都对上,才谈干活。
第三笔账:token 账——聊天一问一答,Agent 是吞金兽
云端 API 党感受不深,是因为按量付费、速度不是问题;本地部署党两头都要自己扛。上面那位 27B 服务器作者给出的实测细节很具体:所有通用 Agent 基座首次接入模型时,会先发一段两万到六万 token 的系统首轮提示词,他自己的 WorkBuddy 是 4.5 万,干脆把它砍了。 你以为说了一句"你好",模型实际收到的是一整个小论文再加"你好"。这还只是开场,之后"拆任务→调工具→读结果→纠错重试"一个来回,token 消耗是聊天的几十倍量级。知乎
工具兼容性也是坑:他把自己环境里 Agent 用到的 28 种工具逐一拿去喂 Qwen 27B,有 4 种压根不识别。知乎
工具生态倒是先就位了:GitHub 上几天涨了 33 万星的 REA,干的事是把本地已装好的老工具通过 MCP 接口桥给 Agent——这波不是模型突然变强,是老工具终于有了自动调度的手。 于是瓶颈完全回到你的"模型+量化精度+推理引擎"组合的吞吐上。最朴素的验收标准:拿一个你自己真实的重复任务压测(不是跑 demo),看它能不能在一次任务里不循环、不超时地把活交完。信通院榜单上 40.55% 的天花板也提醒所有人:Agent 任务的失败率本来就高,本地模型还要叠一层速度惩罚,动手前把心理预期调到"半个实习生",而不是"数字员工"。哔哩哔哩
三类人现在值得动手,三类人再等等
值得动手的:有一类高频重复任务(批量抽字段、格式统一、固定流程搜索整理),本地不限量不按次收费、越跑越摊薄的人;数据不能出门、又拿不到合规云端方案的人;手里 16GB 以上显存或大内存、就想把 Everything 搜索这类小场景接上端侧模型的折腾党。
再等等的:把大模型当搜索引擎、一天问两句的(云端免费额度完胜);指望装个 27B 就彻底告别云端旗舰写长文的(这张表没测这些能力);机器低于 8GB 显存又没有大内存的——先接受 4B 档位的能力天花板。
接下来盯什么
三个信号:信通院这轮 MCP 专项会不会扩参测名单、出完整榜单(现在只有 6 个模型、6 类任务的覆盖,结论边界就在这);StartLux 说好的"年内推出第一代本地智能解决方案"能不能落地;以及端侧推理这一层——面向端侧的流式 MoE 推理框架 Edge0 已经开源,首发带 35B 和 8B 两个预览模型。 如果"跑得动"的工具继续下放,27B 们今天试卷上的第二,明年可能就是存量机的入场标配。微博
(文中信通院 MCP 专项的数字:综合得分与参测名单来自 36 氪对报告的公开转述,任务成功率与分项数字来自知乎回答对测评图表的逐条引用;量化硬件账、首轮提示词与工具识别数均为对应作者自报实测,口径不一,请以自己任务的实测为准。)