过去72小时,"16G显存跑Qwen3.8-27B"把本地AI圈的信息流整个刷了一遍:126K上下文、40 token每秒、IQ3量化、魔改20G卡、850块的数据中心二手卡……叠加上内存显卡这一轮涨价,"老卡突然又值钱了"的叙事,让每张插在机箱里的12-16G卡都看起来跃跃欲试。
作为手里正好攥着一张16G卡的本地党,我把B站、知乎这两周的实测帖子翻了一遍,挑出10组有卡型号、量化格式、KV设置、上下文和速度的完整实测,把标题里的数字逐条对账。结论先放这:27B确实能在16G上跑起来,但几乎每个炸裂数字背后都有一个没写出来的前提。上车之前,先把这五个数弄清。
先说为什么这波是"27B"
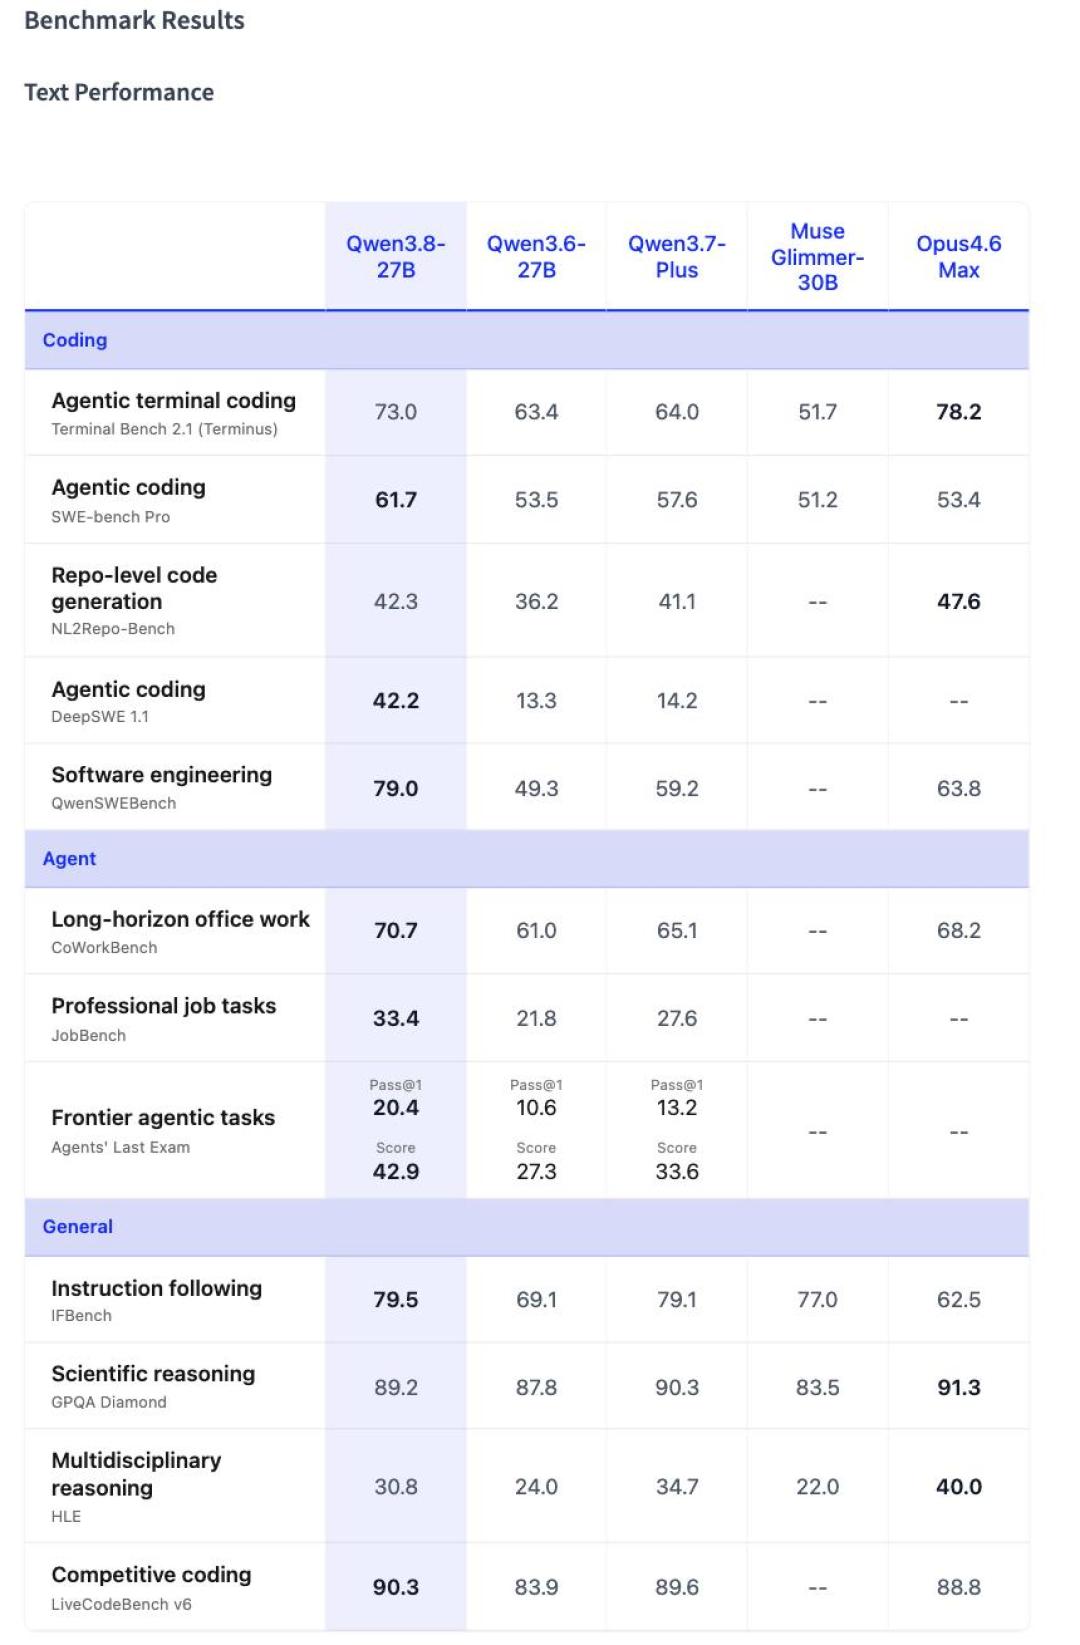
Qwen3.8这一家子版本号有点绕:8月26日开源的是Qwen3.8-Flash线(MoE,总参125B、单token激活6B),而刷屏的是另一条——27B的dense多模态版本,Apache 2.0协议开源。 按Qwen公布的评测口径,它在Agentic Coding、软件工程、竞争性编程、指令遵循等项目上压过了同榜的Claude Opus 4.6 Max。 Artificial Analysis上它拿了52分,社区口径是"跟DeepSeek-V4-Pro基本一个水平",而量化完能塞进24G消费级显卡——能力和门槛这两点凑一起,才是本地党破防的真正原因。 还有个出圈的段子:Anthropic CEO 因为"27B模型得分超过Opus 4.6 Max、还能跑在一张900美元二手显卡上"而紧急约见立法者的玩笑刷遍X,发布者随后澄清除了"紧急开会",其他细节都是真的。知乎36氪知乎
物理基础也很直白:官方4bit权重17.74G,社区魔改IQ3量化能压到11.8G。这就是"16G跑27B"的全部秘密——不是显存变大了,是文件变小了。文件小了以后发生什么,就是下面第一个数。
第一个数:11.8G——权重塞得下,智商塞不下多少
"27B压缩到11.8GB直接下载就能跑"是这波传播里最强的钩子,但实测圈对IQ3的态度相当分裂。哔哩哔哩
知乎上跑了三周3090 Ti的玩家结论最干脆:别纠结,直接用官方4bit——17.74G对24G卡友好,速度反而是各版本里最快的。 他试过Unsloth那套Q3/Q4/Q5动态量化,指出理论精度优势要靠自建model.yaml手动配思考档位参数兑现,“配错了直接跑不起来,收益却感知不明显”。有人做过敏感度分析:量化的伤主要落在output层和full-attention层,Q5以上基本无损。知乎
而16G阵营用IQ3,是显存逼出来的。B站那个"16G跑126K"视频的评论区给了一个样本:4080S上IQ3+量化KV能开110K上下文、全程50-70解码、1700左右预填充。 但同一批人聊IQ3的真实体验是"聊天蠢"“编程任务输出又臭又长,压缩好几轮做出来还是一坨,不如Q4”。3060 12G那位更是明牌:选IQ3就是为了100%全显存驻留,拿精度换"跑得动"。哔哩哔哩
给你的判断:能用Q4_K_M就别碰IQ3;只有16G以下卡、且接受聊天质量打折,IQ3才是权衡项而不是福利。
第二个数:Q5——KV Cache的悬崖,比权重量化还陡
这波真正的硬核分歧不在权重,在KV。上下文一长,KV Cache吃显存比模型本身还狠:按每token约22KB估算,256K满载要吃5.5G,128K也要2.8G——16G卡上这就是三个身位的差距。知乎
于是人人都在量化KV,而量化KV是有悬崖的。B站专门做KV量化横评的UP主(“IQ3S神了,速度鬼了,FP16神了,无脑冲了”)评论区里流传着结论:Qwen3.5这一系架构(3.6到3.8)的KV在Q5_0处有断崖,K和V低于Q5会瞬间变弱智。 另有玩家拿KLD基准对过账:q8_0的KV损失已经和unsloth ud-q6_k的权重量化差不多,比大多数人直觉里"KV随便砍"要敏感。哔哩哔哩
再细分还有不对称性:K是注意力分布,砍狠了长上下文召回直接失败;V主要影响生成细节。所以"k8v4""k6v4"成了社区甜点位。但评论区同时有人踩过反向坑:K和V量化等级不对等时,decode会卡在等CPU,都是q8v8才没这个问题——省显存的参数,可能是拿速度换的。哔哩哔哩
给你的判断:KV量化从q8_0起步,想省再往k8v4/k6v4挪,别碰对等低于Q5的配置;每次只动一个参数,一次提示词的输出来随机性大到不够你下结论。
第三个数:220t/s——你看到的吞吐,不是你打字的速度
标题里的"t/s"有两个含义,社区自己经常装糊涂。
2080Ti那位晒"鹈鹕骑车220t/s峰值"的,是batch并行下的总吞吐;单开一个窗口跟你对话,速度是它的零头。 而"单路40tok/s"才是你盯着屏幕的真实体感。哔哩哔哩
更隐蔽的是"看似全在显卡里"。知乎那篇4090D榨干指南抓到了这波最有价值的细节:128K上下文下显存显示22.5GB、没撑满,但ollama ps显示有12%被卸载到了CPU——显存带宽1008GB/s对PCIe约25GB/s,差40倍,被卸的层每生成一个token都要过一遍,输入再短也躲不掉。 作者原话:"判据永远是 ollama ps 的 PROCESSOR 列,不是 nvidia-smi 的数字。"另一位双3090跑27B Q8_0的玩家把这个坑的代价量了出来:262K满上下文下,带5% offload只有25.7 tok/s,100% GPU是44.8 tok/s,差1.7倍;而8K和64K下两者都在45上下——这个坑专门坑长上下文用户,短对话用户会永远认为它不存在。知乎知乎
给你的判断:对比任何速度帖,先问batch几路、单路多少;装完模型先跑一次`ollama ps`,看到CPU占比高,你的"40t/s"就是宣传画。
第四个数:92%——默认思考档吃掉的算力,比量化狠
跑三周3090的作者排出的第一个大坑居然不是量化:默认xhigh思考档。固定prompt下,312个输出token里286个是思考token——92%的算力和时间花在自言自语上,让写个Hello World它能给你设计一个"高扩展模块化"版本。 日常任务切medium甚至low,“效果几乎不打折”。注意`reasoning_effort`只认xhigh/medium/low三个值,传high或auto直接报500,而且只能启动时设置,不支持请求级切换。知乎
魔改卡视频的高赞评论还补了一刀:思考强度其实才是影响这个模型质量水平的关键因素,Q3到Q8的质量影响最多也10%以内,但从xhigh往下动不动就是20%-40%的波动。 先调思考档,再纠结量化——这个顺序很多帖子是反着讲的。哔哩哔哩
第五个数:128K——甜点,262K是大坑
官方口径是原生262K、YaRN外推100万,模型卡自己也写了"至少128K以维持思考能力";实测社区一致把脚踩在128K这边,因为128K显存减半,而实际使用里几乎够用。知乎
硬上262K的代价是具体的:Windows长上下文是TDR重灾区,262K满上下文+长生成迟早给你一个0xC0000409崩溃,第一件事是注册表调大TdrDelay。4090D作者还有一句忠告值得裱起来:最好别用边界配置——卡在临界点会出现生成到一半卡死、无报错无进展、跑着跑着OOM这类诡异故障,比完全放不下更难排查。知乎
对完数字,按卡型各归各位
3060 12G:IQ3全驻留+llama.cpp,64K@22t/s、32K@26-28t/s。12G卡把27B榨到100%全显存驻留、首字吞吐破400t/s是真的,"达到真实生产力需求"这个说法也成立。 但也就到这了。哔哩哔哩
5060 Ti / 4070 Ti Super / 4080S 16G:这波主战场。IQ3+量化KV能开90-140K;进阶玩法是把KV扔内存里——KVMem方案(github上kvmem/kvmem-llama.cpp,llama.cpp分支)在5060 Ti上把256K用满、中间33次tool request、decode大概37–41 tok/s,质量基准"差别不大"。 注意这是分支,社区共识是"等合入主干再用",主线目前甚至把turbo分支视为废案——尝鲜党专属。知乎
3090 / 4090(D) 24G:官方Q4_K_M+MTP变体,80K省心档;4bit标准解码56-62t/s,MTP=3峰值87——“一行参数接近翻倍、质量无损”,这是24G卡唯一的必开项。硬挤128K会掉进CPU offload陷阱。
双卡/魔改:4070TiS+850块Tesla T10凑32G,Q4加fp16 KV开128K上下文、速度30~40t/s;16G魔改20G卡能让4070TiS从90K到128K。 都是真实存在的方案,也都是无保固、风险自负的折腾路线,新手别把"性价比"排第一。哔哩哔哩
想跑125B Flash线的:双RX7900XTX 48G实测Qwen3.8-Flash日常38tok/s、48K长文本跑稳——AMD卡这波存在感不低,Day 0支持就是官方给的。
最后一笔账:现在到底要不要为27B买卡
这波热潮的背景板是涨价:时代周报实探华强北的样本里,RTX 5060 Ti 8G一周涨700元、RTX 5070一周涨了1000元,5090系列一周涨价近4000元。 知乎"内存显卡什么时候回归正常价"的问题下,共识是这轮是DRAM结构性紧缺——HBM和服务器DDR5吃掉产能,2026Q3涨幅收窄但合约价仍在涨;有人判断2027年先观察涨价停止,真正回到比较舒服的价格区间更倾向看2028年。 显卡内部还要分层,中端卡(5070、9060XT这类)可能靠促销回落,高端卡供货紧未必跟降。36氪知乎
把这笔账合起来算:你的16G+IQ3/KV量化已经落在"能用"档,差的只是从"能用"到"很舒服"那一档——而为这一档买单的时机,恰好是显存最贵的秋天。结论:不为27B买新卡。真要上台阶,二手3090或T10组合这类路线的体验增量都比"咬牙上50系"划算;愿意等的,把"自己想买的档位是否促销"当观察信号,别信"双十一全线回落"。
至于"本地部署=token自由"那个95万浏览的经典争论,这波实测潮又给了反证:有5090 32G玩家晒过最激进的账——部署完开256K上下文,prefilling约1600tps、decode约120tps,单路claude code一天24小时不停"蹬",约等于每天1.1亿token。 但27B干长程agent任务不行——思维链太长、几轮下来注意力漂移,等它跑完一个完整任务你得等到怀疑人生;合理的姿势是27B当planner拆任务、执行丢给小模型(同门MoE的Qwen3-30B-A3B在4090上能到196tok/s),或者干脆用Flash线API。 本地27B的定位是单轮深度问答、代码生成、文档处理——这个尺寸里最能打;长程多工具agent,还没轮到消费级单卡。知乎知乎
继续盯这五个信号
KVMem、kvarn、turbo这批分支有没有合入llama.cpp主干——合了,16G党的长上下文才算安全区;
unsloth和社区魔改版对Qwen3.8-27B的Q4级优化(11.8G的下一代),质量能不能追上官方4bit;
Qwen3.8-35B MoE到底发不发——社区已经在拿Nex-N2.5、Ornith-1.5当替代品了;
DRAM合约价拐点:2027年Q1之前,任何"显卡大跳水"都按段子看;
魔改20G卡的翻车率——二手商开始推"AI专用改"的时候,通常就是该观望的信号。
数字对完,这台机器还能再战两年的结论是成立的——前提是别按标题里的速度期待它。你手上是哪张卡、跑出来什么数,评论区对个账。