9月14日,B站UP主 frank-quant 把8家厂商的14个大模型按在同一张考卷上:同一份题目、同一份数据、同一笔手续费、同一个目标函数,各自用自己的官方编程harness现场写一套能做多也能做空的量化策略,再扔进一个模型从没见过的年份。这条横测视频两天冲到4.2万播放、2300多人收藏,评论区167条几乎全是火药味。哔哩哔哩
几乎同一时间,另一份更"学术"的答卷在量化圈流传:QuantCode-Bench,arXiv上的公开基准,让17个大模型做400道从真实社区里扒出来的题,全部要求生成能编译、能回测、能产生交易信号、而且语义和需求对得上的Backtrader策略代码。 两份评测,一个问题:大模型到底能不能替你做量化建模?答案比"AI炒股神器"和"AI量化都是割韭菜"这两种阵营话术精细得多——而这层精细,恰好是个人量化玩家最容易踩空的地方。知乎
成绩单:语法早不是问题,死在半路的都是同一类
QuantCode-Bench的判分方式很狠:四道关卡连过才算对。知乎
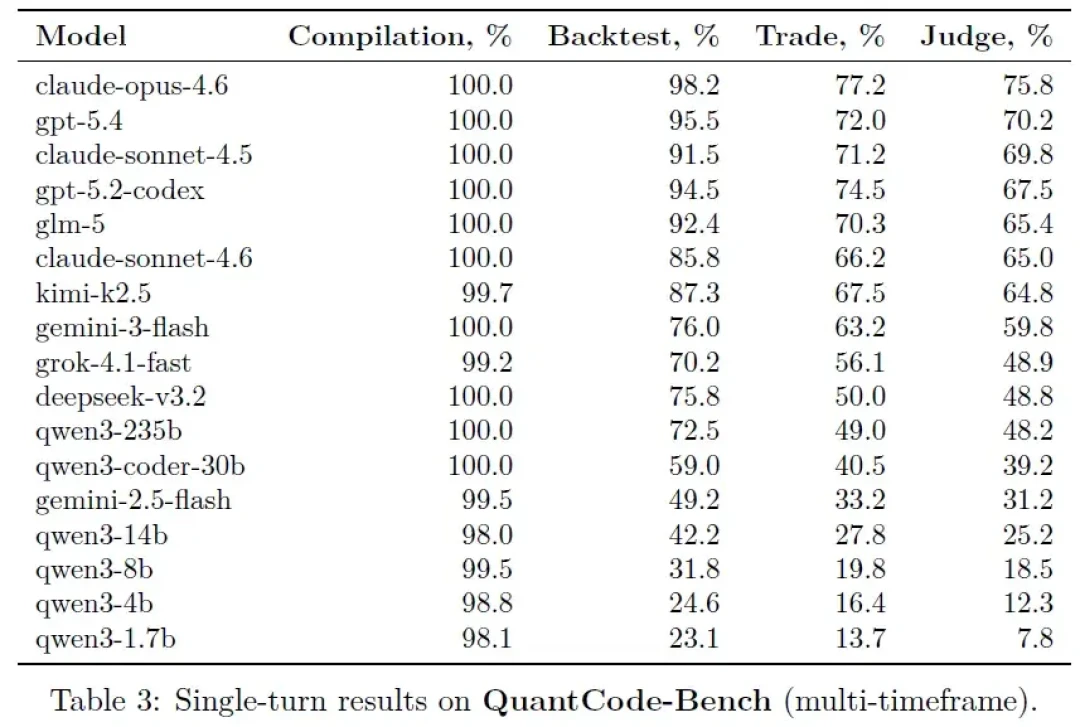
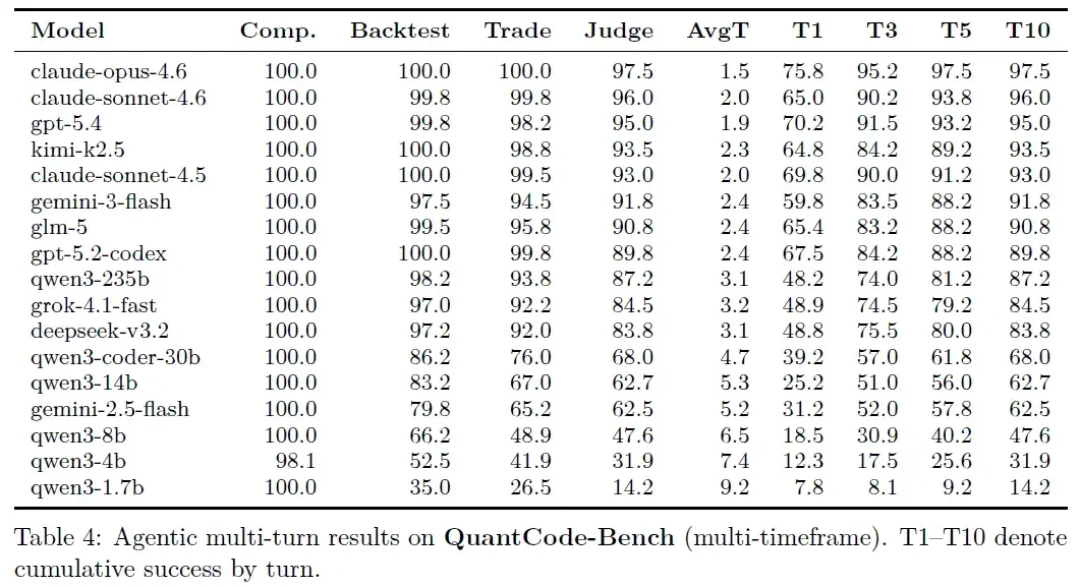
结果出来后,几个数字值得逐条看:
所有17个模型的编译通过率都接近100%。写一段语法正确的策略代码已经不是能力边界。
但单轮模式下,最强的Claude Opus 4.6也只有75.8%的全关通过率。没有任何一个模型能一次写对所有题。知乎
第三关是真正的分水岭:很多模型写的策略,编译没毛病、回测没报错,但从头到尾一笔交易都不产生。用评测作者的话说,等于写了一段"在历史上完全不动手的观察代码"。知乎
多轮反馈能把能力显著挤出来:Claude Sonnet 4.6从65%拉到96%,DeepSeek从48.8%拉到83.8%,Opus 4.6多轮达到97.5%。允许模型根据编译错误、回测异常迭代最多10次,通过率抬高20多个百分点。
小模型完全不行:Qwen 3 1.7B单轮多轮都在个位数到百分之十几徘徊——这个任务对推理规模有硬门槛,本地随便跑个小模型接不了这活。
frank-quant的实弹横测则给出了更扎心的一幕:主榜14个模型全部跑赢了同期跌44.95%的大盘,但样本外收益为正的只有1个(Qwen3.8-Max,+1.74%)。而且他把账算到了成交明细里——冠军的469笔交易中,452笔按模型自身信号平仓净亏94.3,赚的268.1全部来自回测末根K线的机械强平。把强平剔掉,14个模型全部为负。 这个分布对个人玩家的第一层警示:"AI写的策略能跑起来"和"AI写的策略真的在做事"是两件事;"回测赢了"和"赚钱"又是两件事。GitHub
评论区才是真实战况:机构泼冷水,散户真在用
frank-quant那条视频的评论区,几乎把整个圈层的分歧摆上了台面。
机构出身的人冷水泼得最狠。一位自称曾在中高频私募负责截面模型优化和剪枝的用户留言:私募的回测系统比开源和个人自建的复杂"极其多",毫秒级延迟带来的滑点都要建模,每跑一次公司回测接口要花一下午;并给出经验判断——永远不要相信能用AI跑到夏普比率进入1.0,很多接口和高频数据都需要有资质才能拿到。哔哩哔哩
另一条冷水来自博弈视角:交易是对手盘,大家都用AI coding,那么就都一样。还有人直接点出代码层面的坑:大模型自带未来函数——用当天收盘价做当天决策这类前视偏差,AI写得毫无心理负担。哔哩哔哩
但散户侧的真实使用强度远超想象。小红书上"花两天用ChatGPT和Claude搭了个80因子的多因子模型"的笔记拿下829赞、726收藏、164条评论;“用AI写量化策略第七天"的跟练笔记有1200多赞;甚至有人问"纯靠AI写的策略能不能拿去量化实习面试”。另一边,"我用AI写了个量化盯盘系统,赚惨了"的帖子下面,热评第一反手一句灵魂拷问:大家都用量化赚钱了,那谁在亏钱? B站另一条6.5万播放的视频把中间派立场说得很直白:别把AI炒股当量化,AI荐股不是量化,没有回测才是硬伤。 三派吵的其实不是同一个问题:数据资质党回答的是"机构级alpha怎么来",博弈党回答的是"公开策略有没有超额",动手党回答的是"我能不能快速把想法变成可回测的代码"。把三个问题混在一起,就只会得出"AI量化是骗局"或者"AI量化包赚钱"这两种错误结论。小红书小红书哔哩哔哩
别拿评测当提款机:回测和实盘之间还隔着一个市场
说清楚边界,才知道该让AI干什么。
已经能证明的:把自然语言需求翻译成可执行、可回测的策略代码,这件事在成熟框架下正被"接近解决"——多轮模式97.5%的通过率就是证据。这是确定性的生产力,还在手搓每一行样板代码的人是在浪费时间。知乎
两份评测都没有证明的:通过率和赚钱没有任何对应关系。QuantCode-Bench考的是"代码是否忠实实现需求",不是"需求本身是否赚钱";frank-quant全程dry-run,仓库里连"诚实披露"都写得明明白白:样本外那年是熊市、币池是今天回头挑的(幸存者偏差)、滑点从宽、每个模型只考了一次,相邻名次差距小于重复跑的方差——这是一次考试的成绩,不是模型能力排名。GitHub
再看真实世界的对照组:就在上个月,量化私募还经历了一轮全行业"双杀"——7月有业绩展示的指增产品平均收益-16.51%、平均超额收益-2.03%,Beta与Alpha双杀,8月才靠因子回归常态和模型纪律反弹回血。机构花几千万建超算、养团队的量化模型尚且会被单月风格切换打穿,指望一段免费大模型生成的策略稳定赚钱,属于把两份评测没证明的东西脑补成了证明。东方财富
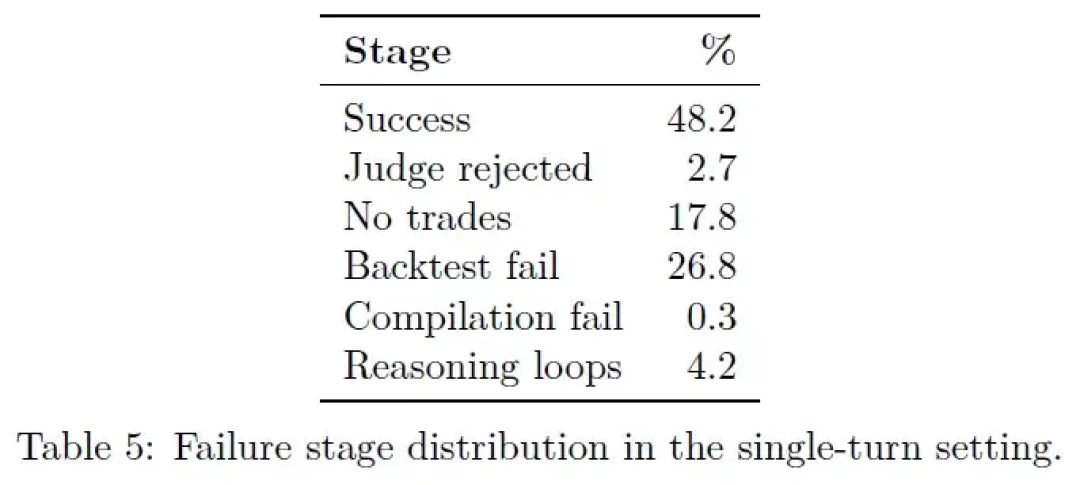
知乎上"回测完美、实盘亏钱"是量化类浏览量最大的题型之一,多个相关问题浏览量20万+,社区共识朴素得可怕:当你觉得一个回测收益非常离谱的时候,就是过拟合了。AI没有改变这个规律,只是把生成离谱回测的速度提高了100倍。QuantCode-Bench的单轮失败阶段分布恰好给这个老规律提供了新数据:编译失败只有0.3%,回测失败26.8%、无成交17.8%——失败的形态从"报错"变成了"静默"。知乎知乎
给个人量化的分工清单:三件事放权,三件事收权
放心让AI干的(省时间,风险低):
需求到代码骨架:描述清楚入场/离场/仓位规则,让模型生成Backtrader/VectorBT骨架,多轮喂报错让它自己修——这是通过率最高、多轮提升最大的部分。
数据清洗和工程杂活:复权处理、缺失值对齐、日历对齐这类没有智力含量但吃掉一半时间的活。
策略的"翻译"对照:让AI把研报逻辑翻译成可回测代码,或反向把代码讲回自然语言,检查语义有没有走样。
必须人来把关的(AI最容易静默失败):
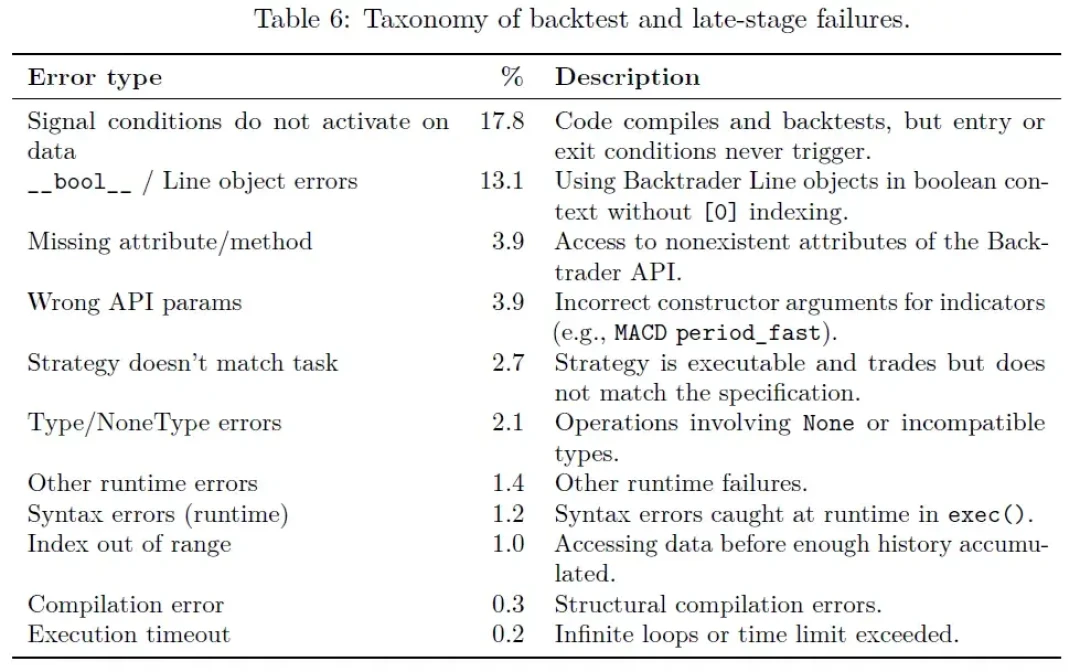
“它到底交没交手”:任何AI生成的策略,第一件事不是看收益曲线,而是确认交易笔数非零、开平仓时点和题目要求一致——评测的失败类型表里,“信号条件在数据上根本不激活"以17.8%排第一,bool/Line对象误用13.1%排第二,全是这种"静默失败”。知乎
未来函数与成本模型:逐行检查决策点用了哪些字段;滑点、手续费、成交时点必须显式约束,AI默认"想成交就能成交"。
有效性判断和实盘决策:过拟合检测、样本外验证、参数敏感性——社区原话是"我不认为有任何有效的方式能彻底排除过拟合,只能尽量削弱"。这层判断AI目前连可靠的代理都做不了。线上真实环境和回测环境是不是同一套逻辑,也只有人对着代码路径能查清楚。知乎知乎
值得一提的是,头部的量化机构恰恰在用同一条分工线:九坤投资创始团队2026年1月开源了代码大模型IQuest-Coder-V1,其40B旗舰在SWE-bench Verified拿下81.4%的成绩,超过Claude Sonnet 4.5和GPT-5.1,而定位就是给软件工程提效;它们真正的alpha引擎,是2020年就投资过亿建起来的"北溟"AI超算和数据、算法、交易执行三大实验室。从幻方量化孵化出DeepSeek,到九坤养出至知研究院,量化圈养大模型的路径全是"帮干活",而不是"替下判断"。微博
上钱之前跑三问:回测交易笔数是否非零且频率符合预期?收益是否"好看到离谱"?线上执行和回测是否同一套代码路径?三问过了,再谈模拟盘。
接下来盯什么
frank-quant已把考题原文、14个模型的完整交付物、审计脚本和逐月盈亏全部开源到GitHub(ai-trading-videos项目EP007),连"两套夏普口径别混用"的坑都写了文档——评测可审计,才是可信评测。GitHub
评论区已有up主在搭"模型+TradingAgents"的6个月擂台模拟盘。值得等的不是下一次跑分,而是第一份长周期、可审计、带成本模型的实盘对比。哔哩哔哩
QuantCode-Bench支持接入自有模型跑400题,国产新模型什么时候刷进第一梯队,值得再看一眼。
大模型没有把量化变成印钞机,但它确实把"想法到回测"的距离从一周压缩到一个下午。省下来的时间花在哪儿——花在堆更多因子,还是花在检查它有没有真的交手——这才是今年个人量化玩家之间真正的分化点。