
9月25日凌晨,B站UP主SPOTLITE发了条视频:《3000多整了4张大船的T10,跑Qwen3.8 27B FP8有一种能飞的感觉?》。一夜之间9400多播放、238条评论。 评论区刷屏最快的不是速度演示,是一句「这视频一出,T10又要涨价了[笑哭]」——紧接着有人报到:「感谢博主分享,我今晚上车的,已经涨到1100了。」哔哩哔哩
两天后的9月27日凌晨,又有人把「两张V100跑NInfer NVFP4,27B突破110token/s」的实测扔了出来。哔哩哔哩
这个九月,本地部署圈本来就被两件事夹着:内存显卡连着涨,知乎9月24日刚有人问:怎么内存、显卡价格这两天又疯了? 另一头,API在一路降。而NVFP4量化+NInfer推理引擎+dflash2投机解码这波工具链更新,等于在夹缝里给老卡党凿出了第三条路:不买新卡,用退役数据中心卡和两三年前的游戏卡,把27B跑出接近"能用"的速度。知乎
这篇只服务一种人:预算三千到六千、想在家里跑27B长上下文、正在闲鱼大船和二手V100之间纠结、又听说"跑分有水分"的折腾党。已经在用API的轻度用户、想要开箱即用的成品党,可以直接跳到文末,我告诉你为什么这篇跟你无关。
一、先摆事实:这一周社区到底测出了什么
把散在B站各UP视频和评论区里的数字拼起来(都是社区自测口径,不是统一基准),老卡阵营的速度地图大概长这样:
路线 | 卡与成本(社区报价) | 社区实测表现 | 主要门槛 |
|---|---|---|---|
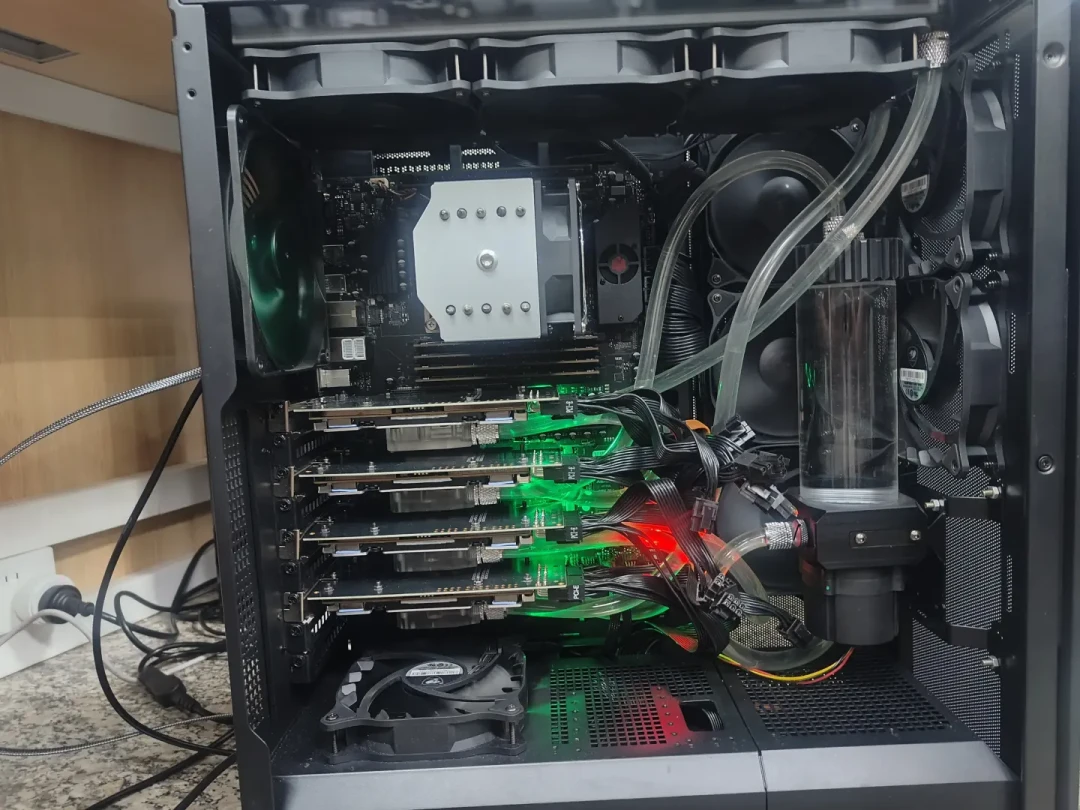
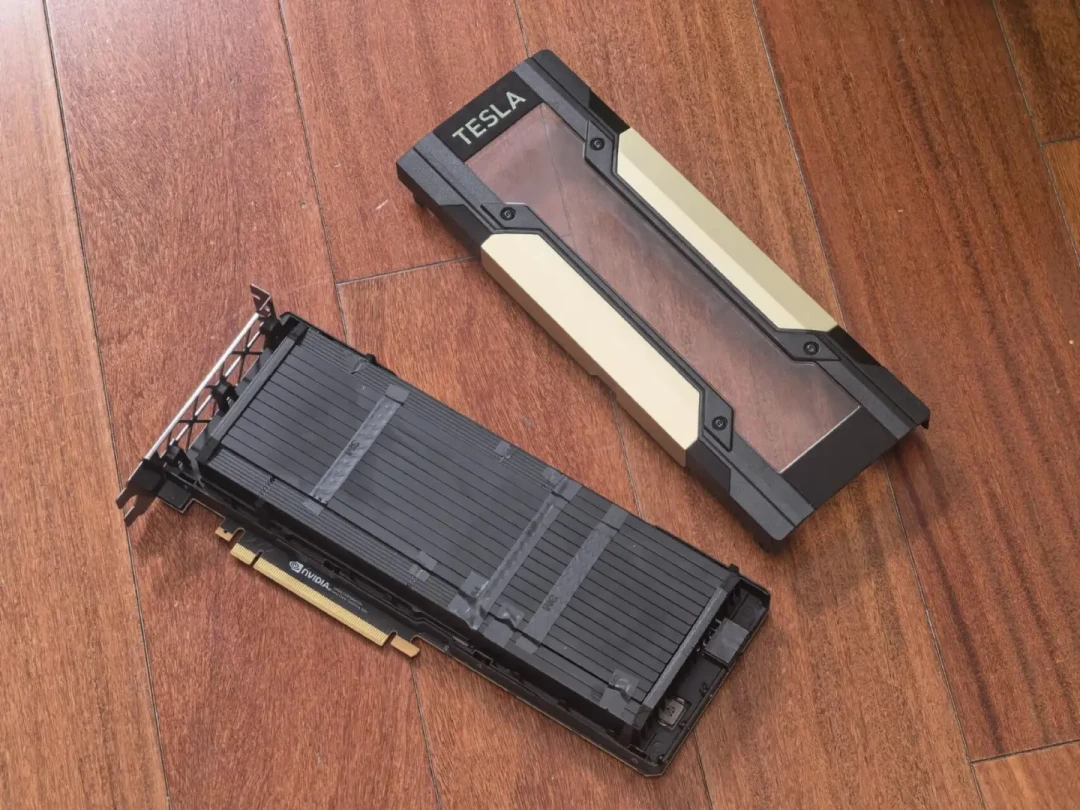
4×T10(图灵,16G/张,大船卡) | 上月929/张→视频发布当晚报到1100/张,四张3000多 | Qwen3.8-27B FP8,64G总显存,UP主形容「能飞」 | 无NVLink,靠PCIe p2p,主板通道要算;Linux为主 |
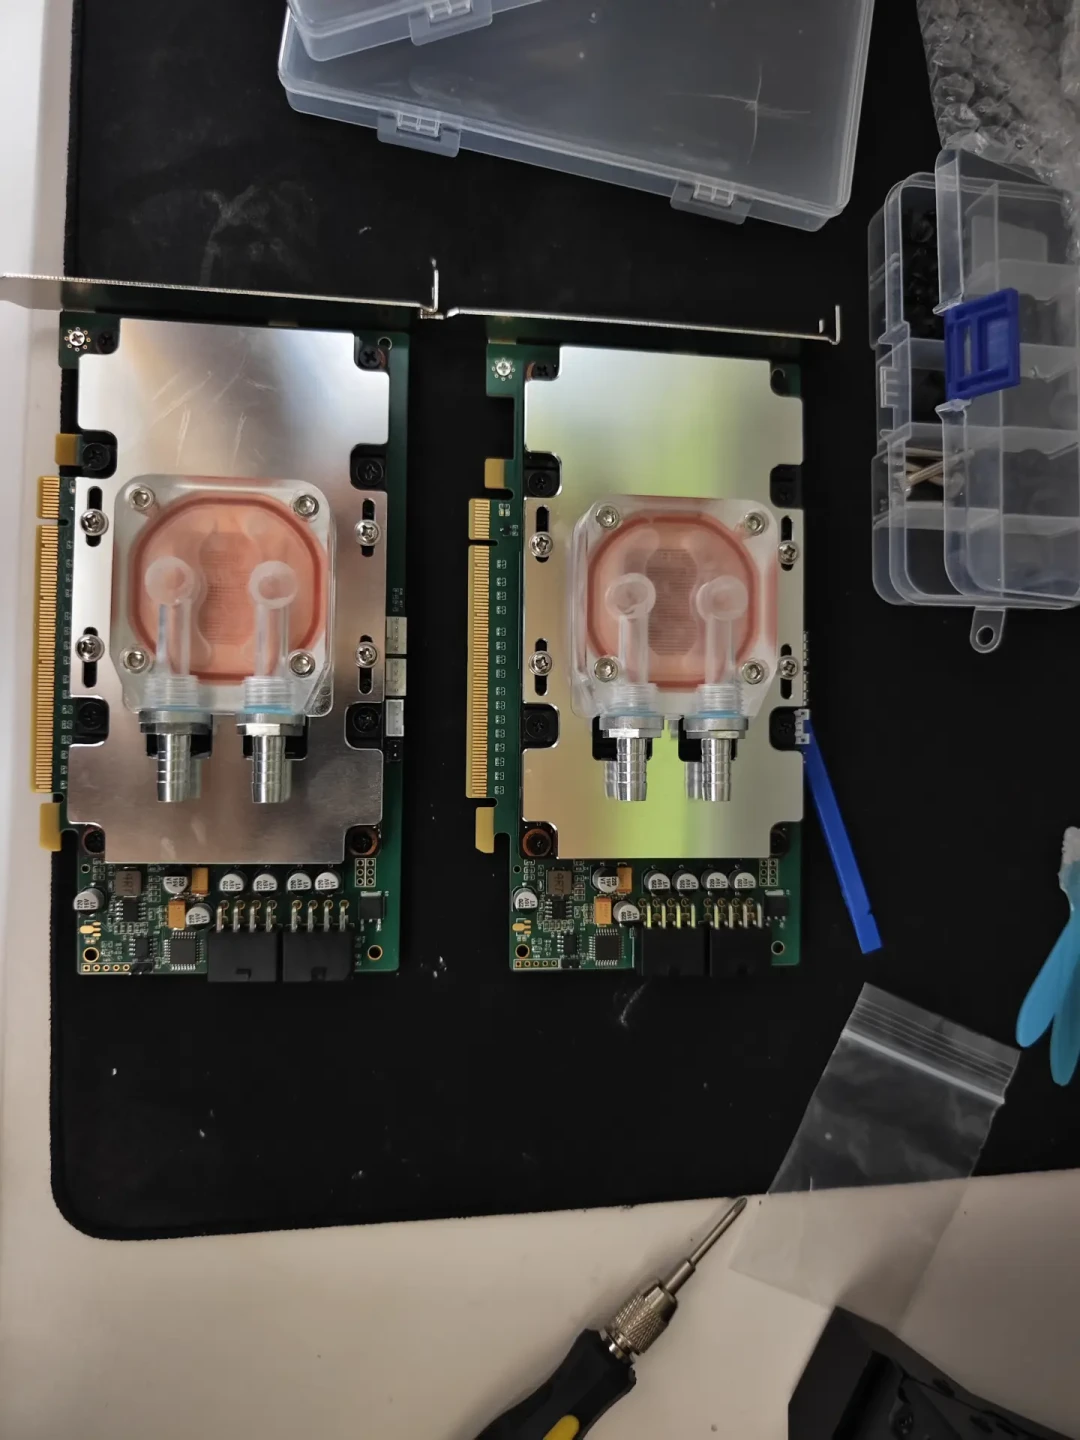
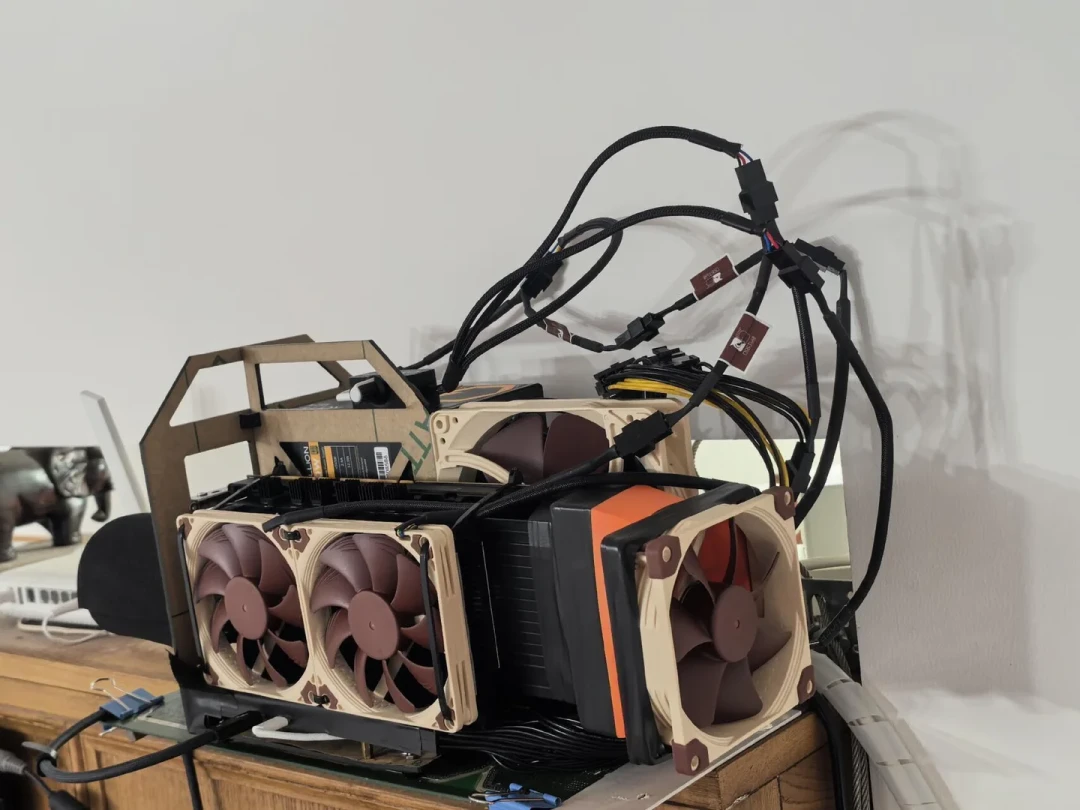
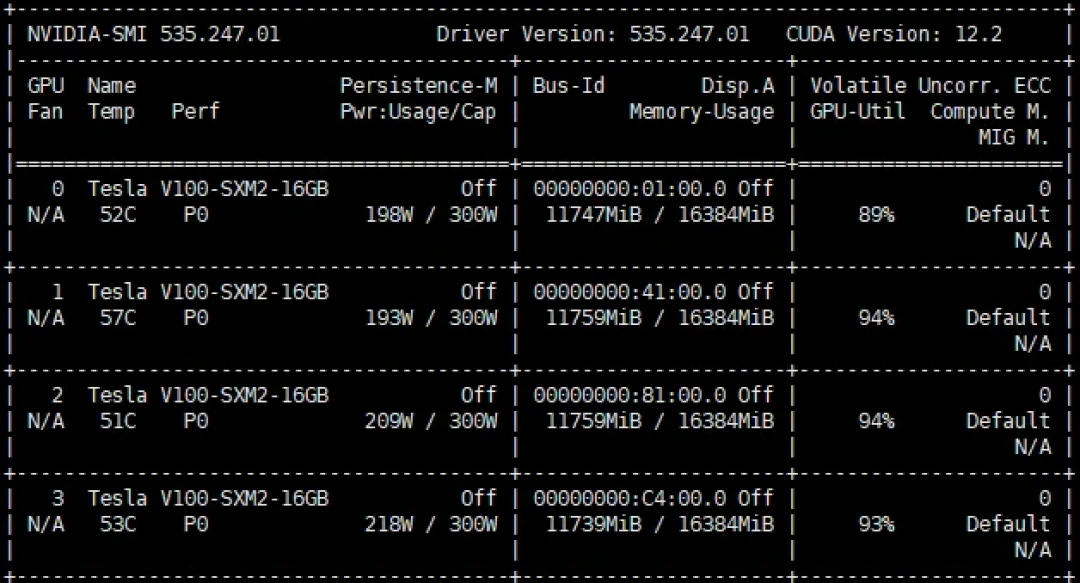
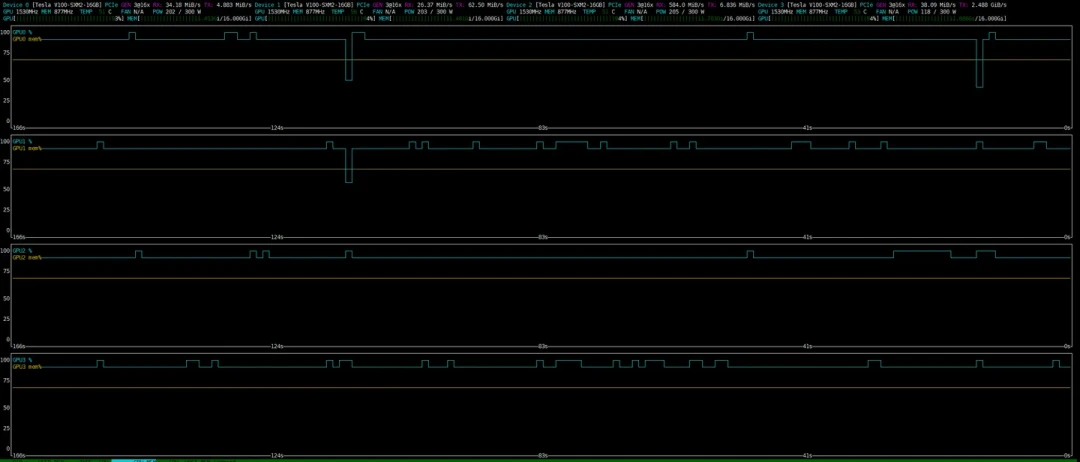
2×V100 Duo | 有评论称「T10 16G比V100 16G还贵」 | NInfer NVFP4,27B破110 t/s(9月27日新视频) | 大船SXM2要转接板;Volta在ComfyUI里基本残废;散热/水冷 |
2×5060Ti 16G | 有评论后悔「当时3400没舍得买」,现价已水涨船高 | NVFP4 27B报120 t/s@256K上下文(9月22日) | Windows/WSL2开不了NVLink,有人只跑到45;主板要打补丁开p2p |
单张V100(对照组) | 此前几百元级 | 8月自测50 t/s出头,当时已被称「涨价环境下最具性价比」 | 同上Volta限制 |
同一批视频里还有几个参照点:Qwen3.8-Flash-Next单卡NVFP4报到135 t/s(MoE,另一回事);vLLM+dflash2方案给V100的decode提速3倍、prefill提速15倍。 9月24日还有「双16G入门显卡跑Q4+长上下文」的完整实测在补容量派的课。哔哩哔哩
一句话总结这波:速度不是靠换卡换出来的,是靠量化格式(FP8/NVFP4)+引擎(NInfer)+投机解码(dflash2)三个软件件叠出来的。所以它的保质期完全在引擎作者和英伟达手里——这既是它的魅力,也是它的风险。知乎9月23日那篇《别再加钱上3090!一张8G破显卡,我把1500亿大模型跑起来了》,同属这股「不买新卡」的暗流。知乎
二、三笔账:真金白银的、看不见的、以及用精度换的
第一笔:速度值账
把「每1000块钱买到多少t/s」摆平:
4×T10约4400元(按1100追价算):目标速度对标的是社区报的百来t/s档;
2×V100:单卡价更低但平台折腾成本高(转接板、水冷方案9月22日刚发布,视频1984播放都在问功耗);
2×5060Ti 16G约7000元:报到120 t/s,但同一片评论区就有人泼冷水:同配置双5070Ti实际只有64-75。哔哩哔哩
对比基准别忘了站内前几篇算过的账:5090D已经11599,二手3090涨到8000均价,租卡盈亏线在7000小时。老卡方案买的是「单位价格的速度」,赌的是「你折腾得动」。这条路上有个高频反驳值得记住,来自T10视频评论区:有人接KVMem说「现在对显存需求没那么大了」,立刻被顶回去——能跑和能用来工作是两个概念。哔哩哔哩
第二笔:隐性成本账
评论区自己把坑都晒出来了:
平台比卡贵:有人8张T10上车后发现「最后买下来是平台比卡贵,内存点到128GB」;有人用华硕X99-E WS,「现在这板子涨价厉害,不是很值了」。哔哩哔哩
通道账:PCIe 3.0 x8对解码影响不大,x4可能掉速;有人打算上PLX拆x8组8卡,属于运维地狱进阶版。
散热与电:V100要改散热甚至上水冷;T10锁100W可以不动散热,但5卡党纠结「多一张怎么办——卖掉一张吃顿好的」;有跑分贴按整机550瓦算电费。 照这个口径,民电六毛一度,常年挂机就是一笔固定支出。哔哩哔哩
时间成本:给主板打补丁开p2p、等NInfer追版本修复、踩完dead-loop再回来修——你不是在装机,是在给自己开一个运维岗。
第三笔:精度账(最容易被偷走的一笔)
120 t/s这个数字,值不值,要看它是不是用你看不见的东西换的。目前证据只够画一条「分歧线」,不够画「结论线」:
怀疑派:百万粉UP「黑纹白斑马」9月22日搬运的NVFP4解析视频(8396播放、263收藏)评论区高赞说「FP4精度太差了,就算是老黄全力优化想各种法子也没办法弥补这个损失」,并以DLSS5最终跑在FP8上为据。;还有人给出实测感受——「向来Q6量化能保住几乎全部效果,再低很快就没法用」。哔哩哔哩
辩护派:「你不能拿同一个模型的Q6和NVFP4比,得拿同文件体积比」;英伟达官方此前给Qwen3.6-35B出过NVFP4量化版,宣称显存暴降3倍、精度几乎不掉。哔哩哔哩
阵营外的第三种声音:国内大厂在格式上倾向开放标准的MXFP4而不是私有NVFP4——「发镜像都是mxfp4,实际跑的还是有不少nvfp4」。 格式之争没落幕,你囤的量化权重有半页押在了站队上。哔哩哔哩
所以买卡前,先用你自己的任务(写代码?长文档?出图?)跑一个你信得过的版本。跑分视频给不了你这个。
三、四个坑,每一个都有人刚踩过
追涨价差。T10从上月929到本周报到1100,「视频一出就涨价」已经发生一次。大船价格双向波动(也有人报「之前1350、现在降到960」),但你追的是热点后的价,不是方案本身的价。
平台生态墙。整套红利目前主要给Linux原生党:NInfer 0.1.16之前WSL2开不了NVLink,实测速度只能停在45左右。 AMD阵营官方vLLM文档「只写了Linux」,RX7900XTX插上就跑这条路官方没给。 异构混搭(5090+5060Ti)会被慢卡拖累,不建议。哔哩哔哩哔哩哔哩
稳定性。9月3日就出现过「Qwen3.8-27B-NVFP4出现EngineCore dead-loop特征」的翻车报告。 引擎还在高速迭代期,版本间的行为差异要靠你自己当测试员。哔哩哔哩
残值玄学。图灵大船卡今天的「AI性价比」建立在引擎作者继续维护、量化格式继续胜利这两个假设上。评论区已经有人半开玩笑:「T10最好的归宿是挖矿,两个月回本」——矿、AI、吃灰,三种归宿的残值完全不同。
四、谁该上,谁再等,该盯什么
现在就值得上:家里躺着X99/多通道主板+Linux环境,明确要27B长上下文高频输出(代码代理、批量整理、长文档),且享受折腾本身的人。这波NVFP4对你们是实打实的白捡速度。
再等等:纯Windows办公用户——等引擎把WSL2/p2p适配补齐再进,现在的体验是半价;手里只有16G卡、指望「能跑=能用」的轻度玩家——KVMem和Q4已经让你跑起来了,别为跑分视频加钱。
不该上:日均调用不高的,API+租卡的旧账仍然成立;想要开箱即用的,成品NAS/迷你主机那条线才是你的终点站,折腾多卡TP不是。
值得盯的四个信号:①T10/v100大船下一波到港量和闲鱼成交价(一周内见分晓);②NInfer/dflash2的Windows支持与版本修复记录;③MXFP4 vs NVFP4的镜像发布口径会不会倒向开放标准;④最关键的——云栖大会一口气放出的四张Qwen4牌里那张「留给你本地跑」的27B,落地时是不是直接带原生4bit权重,那会决定今天所有FP8/NVFP4的折腾是资产还是过渡票。哔哩哔哩
这波老卡速度革命,本质是软件红利提前透支了硬件折旧。红利是真的,水分也是真的——钱可以追,追之前先把你自己的任务跑一遍。
评论区聊聊:你手里的老卡这周测出多少t/s?有没有人发现「宣称速度」和「干活速度」差了几个档位?





校验提示文案
校验提示文案
校验提示文案
校验提示文案