你现在每天都在用的大模型,追根溯源时,课本都会指向 2017 年 6 月那篇标题很狂的论文——《Attention Is All You Need》,字面意思是"你只需要注意力,别的都不需要"。知乎
流传最广的故事版本是:一篇论文发明了注意力,顺手打开了 AI 时代。
问题是,这个故事几乎每一环都讲错了。而且不是我说的,是论文自己和学术史料说的。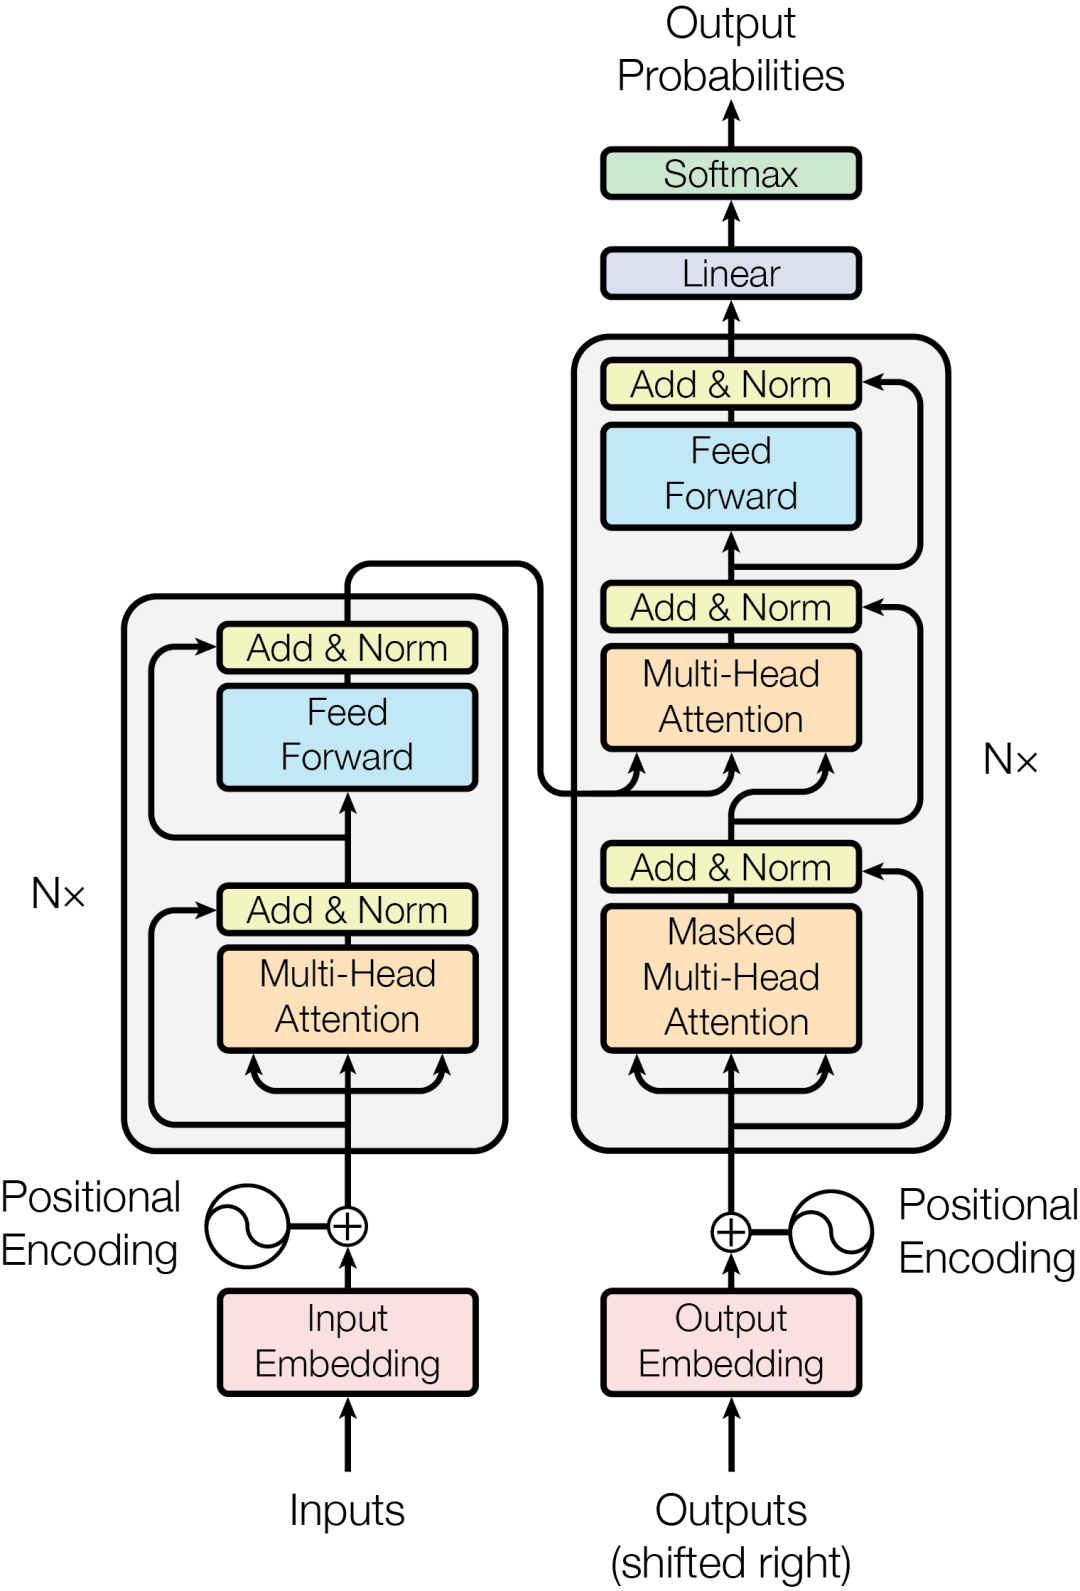
一、它确实没评上最佳论文。
知乎上有人问"它为什么没评上 NIPS 2017 最佳论文",这个问题被浏览了 159 万次。赞得最高的一条评论一针见血:“Transformer 的主要贡献不是 attention,而是 all you need——是不是真的 all you need,得经过更多任务检验。” 也有人不服:"这种影响力,值得图灵奖。"谁也说服不了谁,这才是对一篇论文最诚实的态度。而被顶了 25 个赞的那句比喻最妙:“类似于乔丹没当上状元。”(乔丹是 1984 年的探花,也没耽误成 GOAT。)知乎
二、"注意力"不是它发明的。
真实谱系第一环在 1993 年:IBM 的 Brown 团队发表统计机器翻译 Model 1–5,用词对齐概率刻画两种语言间词的对应——"软对齐计数"正是注意力权重的概念前身。第二环是 2014 年:Bahdanau、Cho、Bengio 为了解决 seq2seq"整句话挤进一个固定长度向量"的瓶颈,造出了可微分的注意力机制(arXiv:1409.0473)。知乎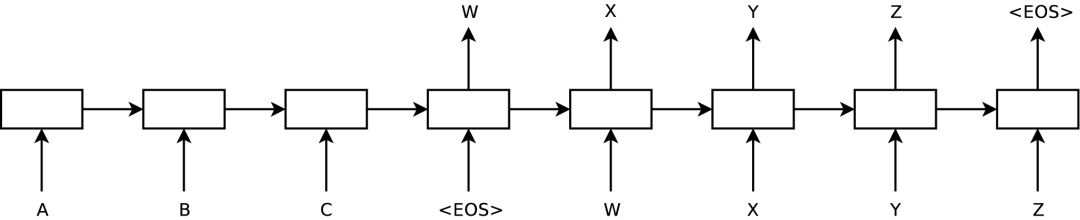
注意力的诞生不是颠覆,是修补。2015 年 Luong 把它简化成点积注意力,2016 年"自注意力"已经出现在机器阅读模型里。所以那篇论文真正做的,是一次减法验证:干脆删掉 RNN,只留注意力,结果还更好——顺带解锁了并行训练,这才是后来 scaling 能成立的工程前提。它不是发明者,它是最成功的一次"证明配角可以当主角"。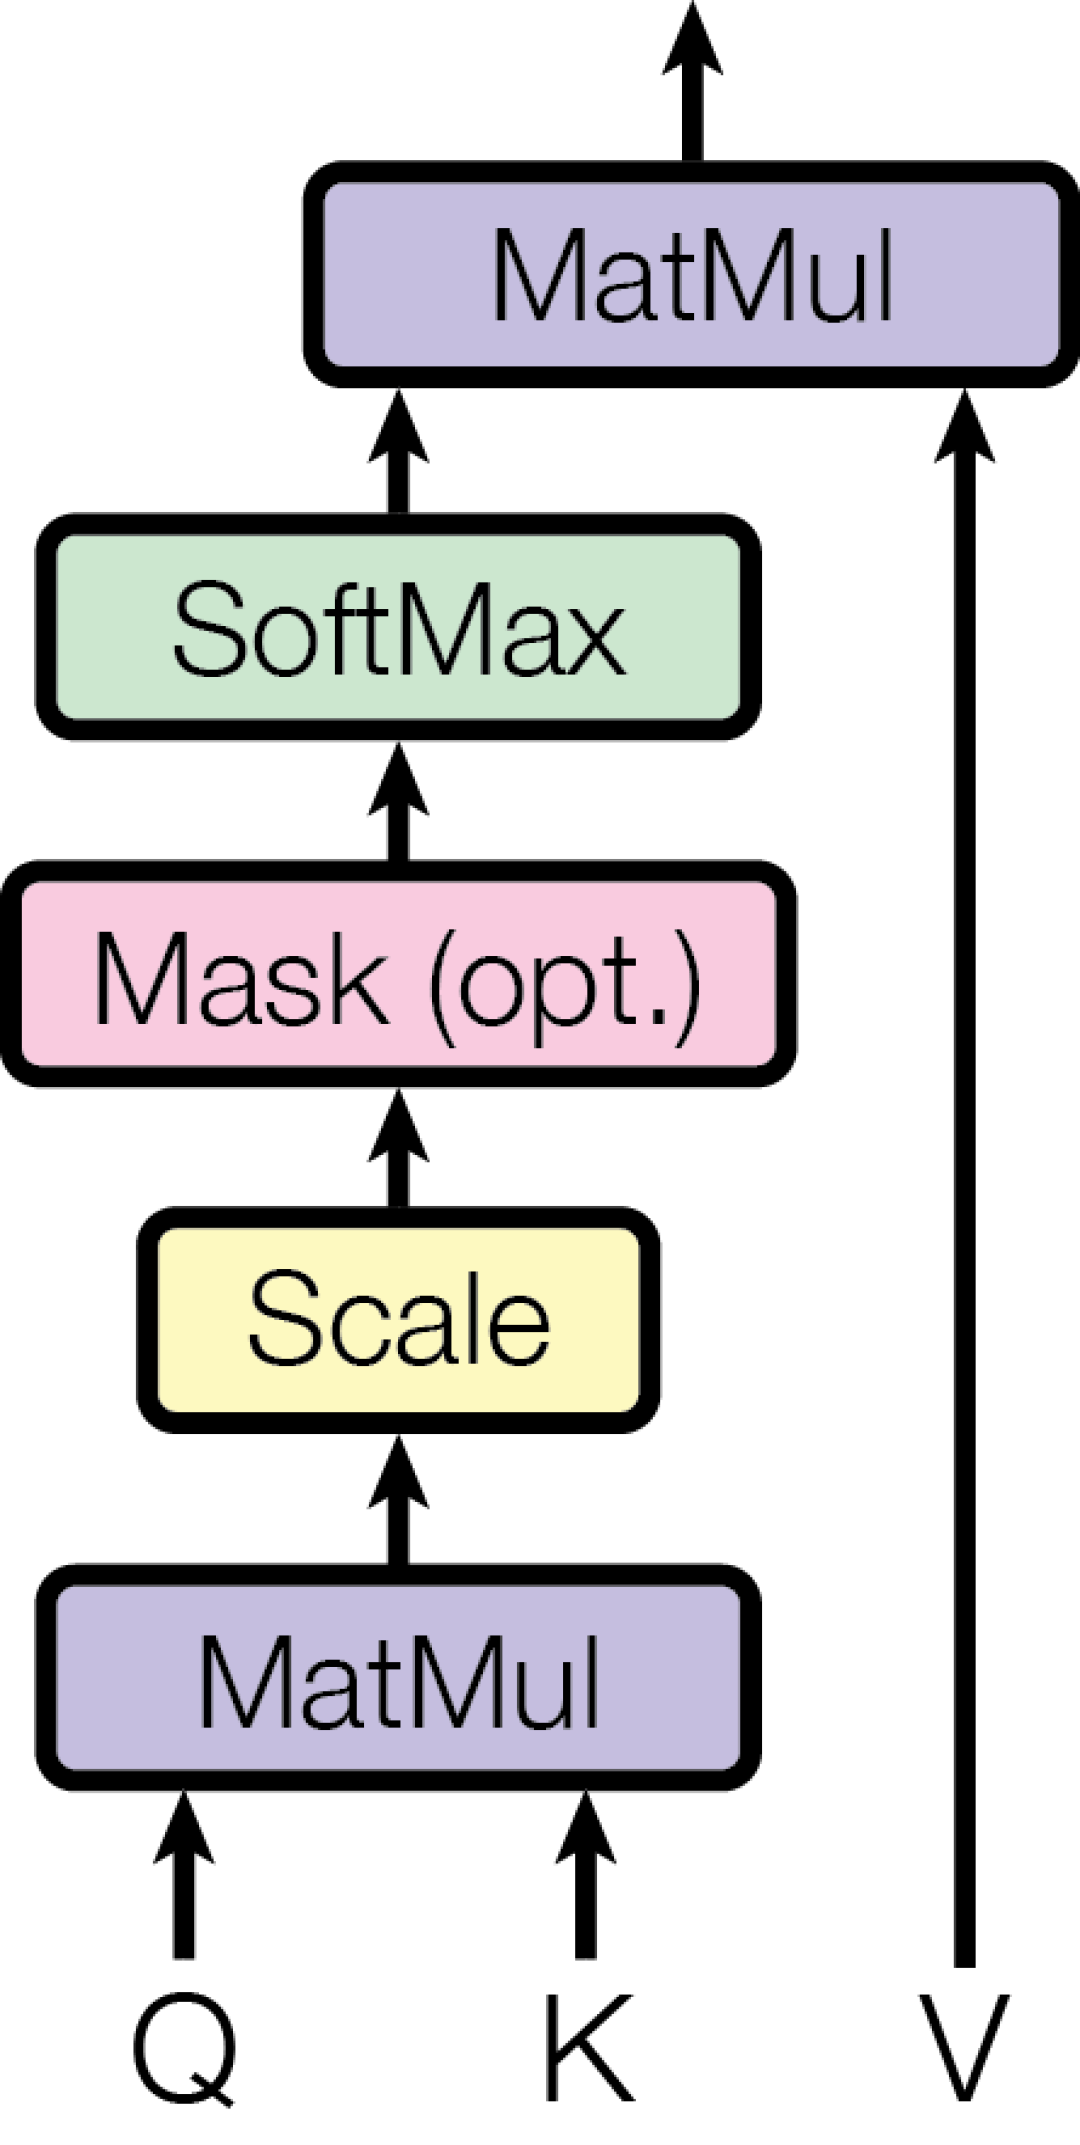
三、这篇论文没有第一作者。
论文第一页脚注原话:“Equal contribution. Listing order is random.”——八位作者全部同等贡献,连名字顺序都是随机排的。你看到的署名顺序,本来就不排座次。知乎arXiv
四、今天大模型的直系祖先,还真不是它。
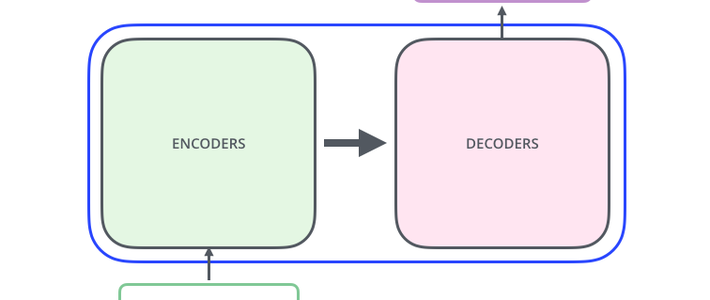
这篇论文是 encoder-decoder 结构,为翻译设计。文中那个 cross-attention,今天的 decoder-only 大模型里根本不存在。decoder-only 路线是 2018 年 GPT-1 独立确立的,缩放定律(2020)和 RLHF(2022)是另外的独立链条。截至 2026 年,这篇论文被引超过 25 万次,Nature 2025 年的统计里它是 21 世纪被引第 7 多的论文。但引用量放大的是可见性,不等于原创性的完整分布。arXiv知乎
把技术史放回原位,故事反而更动人:科学里没有一笔定乾坤,伟大突破是一场 30 多年的接力——1993 年从 IBM 的概率对齐起跑,一棒一棒,经 2014 年的"修补"、2017 年的"减法",交到 2020 年之后的 scaling 手里。那个狂妄的标题,只是谱系上最显眼的那个节点,不是起点。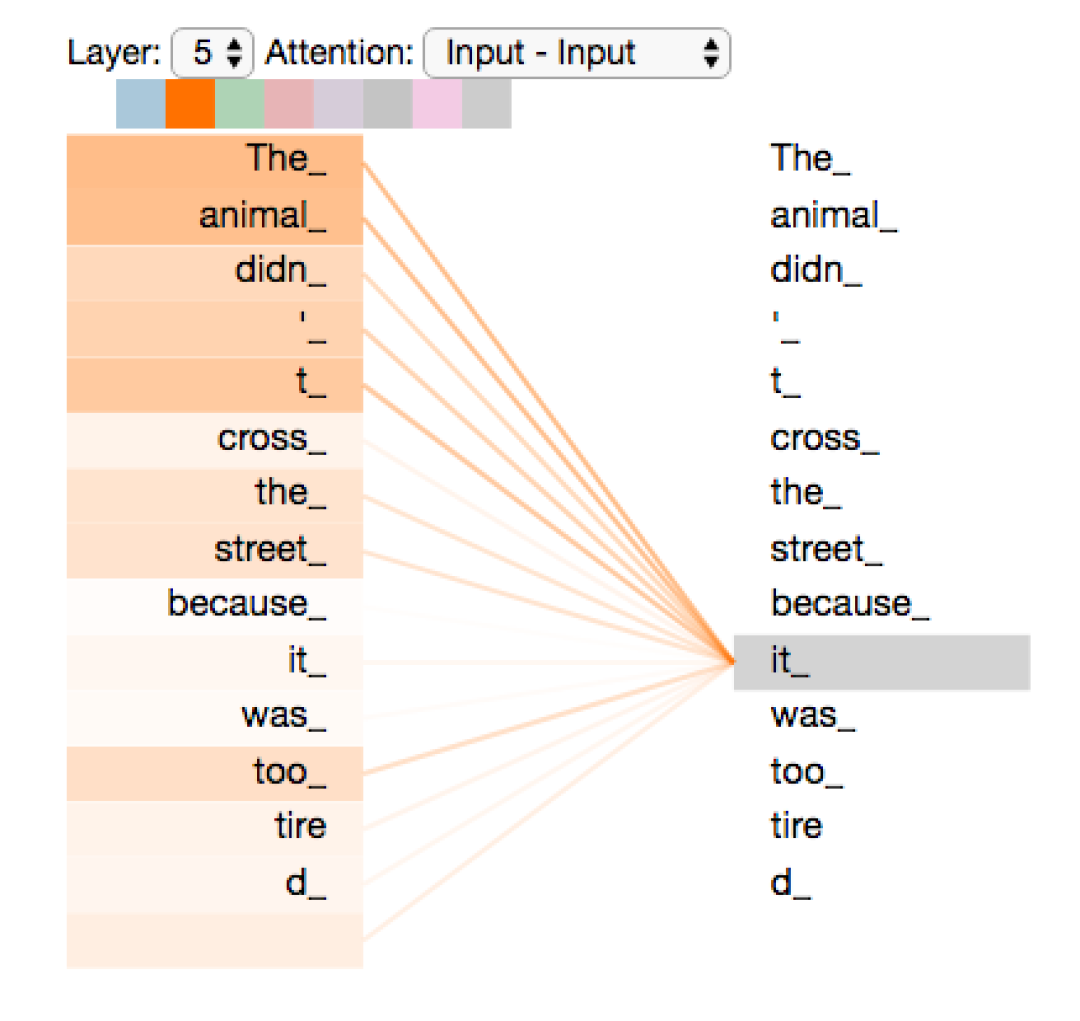
下次再有人说"大模型 = 2017 年那篇论文",你可以笑着补一句:它用的"注意力",其实大家已经接力研究了 30 多年。