极客湾10月31日的直播里,一位观众把这个问题抛给了云飞。这段切片在B站拿下3.3万播放、92条评论。背景大家都熟:几天前的旗舰芯片大横评里,骁龙8EE6被实锤能效倒退,云飞一句"太抽象"火遍数码圈。追问的本质其实是一句话——这颗芯片的坑,系统更新填得上吗?哔哩哔哩哔哩哔哩
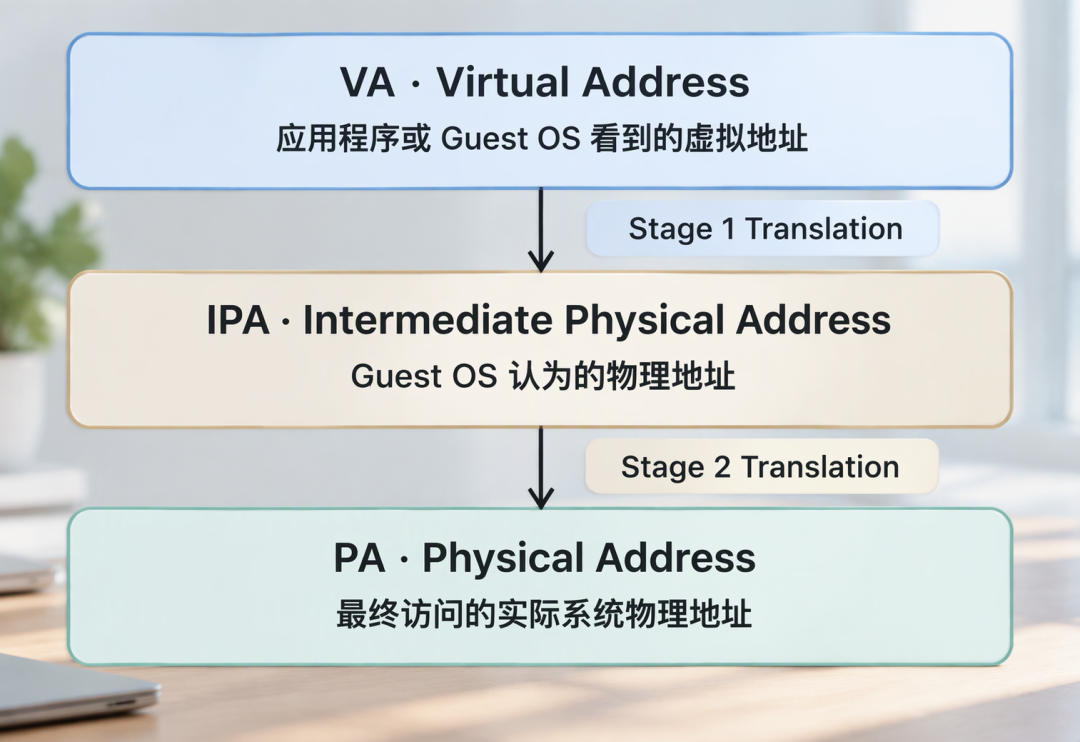
先把"16KB页"翻译成人话。系统管理内存像图书馆编目,页就是编目的最小单位,安卓多年来一直是4KB一页。应用越来越大,编目卡就不够用了——CPU找数据要先查"地址翻译"索引,表太细太长,缓存索引的TLB一转不过来,就得去内存里慢悠悠查页表,又费电又费时间。改成16KB一页,一张编目卡管的书翻四倍,查表次数直接砍下来。
这不是新概念。苹果从A9起就原生支持16KB页;安卓直到Android 15才引入,Google Play也已要求新应用适配。10月初的Linux Plumbers Conference上,小米展示了折中路线:保留4KB基础页,在文件缓存和匿名内存里用16KB大单元(mTHP)。初测18款应用冷启动总耗时从52.16秒降至48.74秒,减少约6.6%;内存回收线程kswapd的CPU占用降约9.5%;代价是驻留内存多出约7.44%。用一点内存换全生态流畅,这笔账不亏。知乎
那问题来了:16KB页是全安卓的红利,为什么偏偏救不了8EE6?
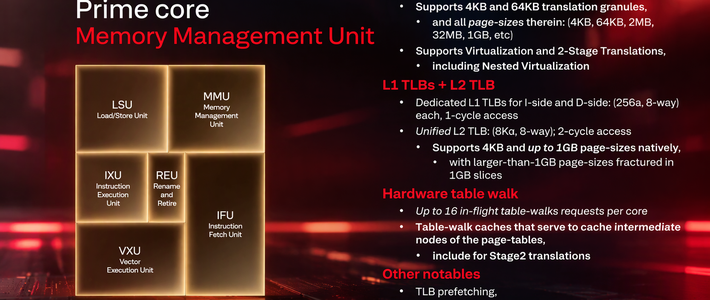
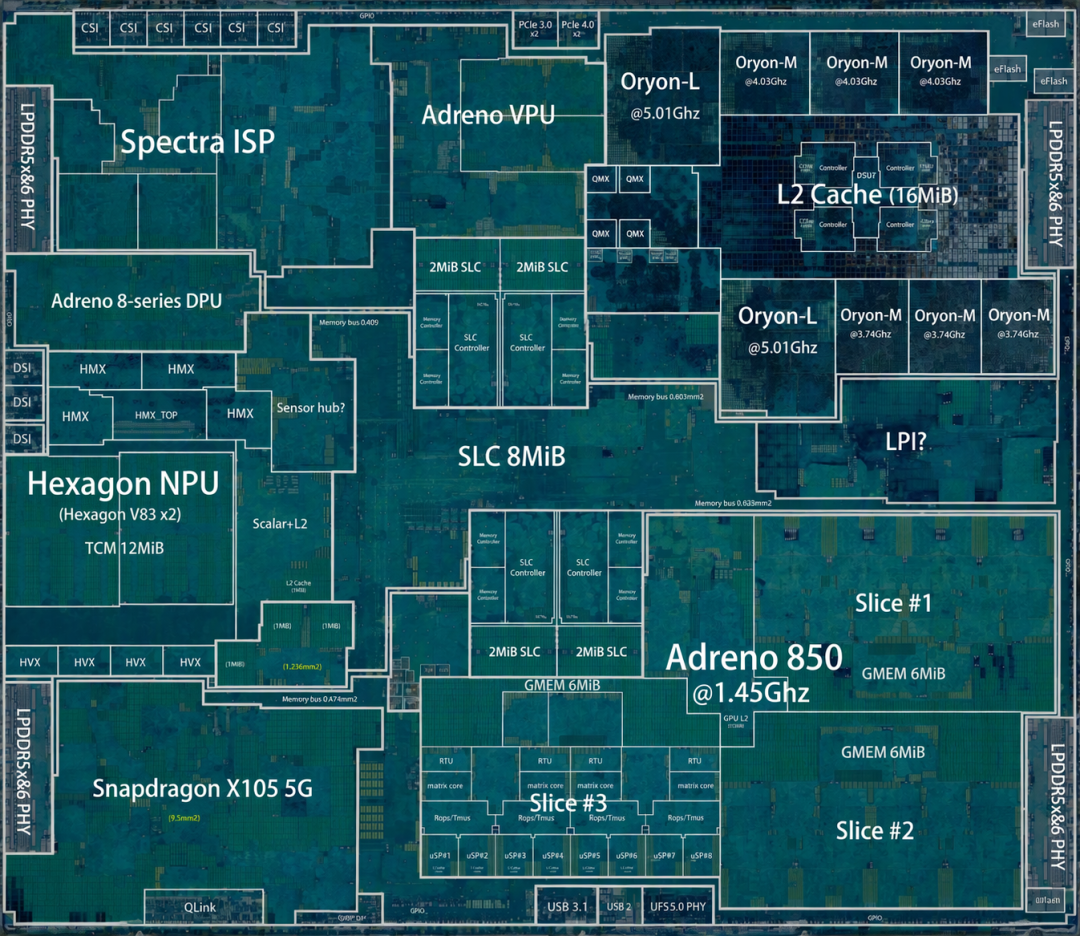
因为8EE6的病根不在系统,在硅片。知乎一篇《朝花夕拾——谈8ee6缓存设计》(23赞、389收藏)把根子挖了出来:高通Oryon架构脱胎于苹果Firestorm,但它的MMU从第一代起就没有原生16KB页粒度,只有4KB和64KB;第二代加上2MB、32MB、1GB,唯独16KB始终缺席。高通抄核心抄了个大概,却没把内存管理这层作业一起抄来。知乎
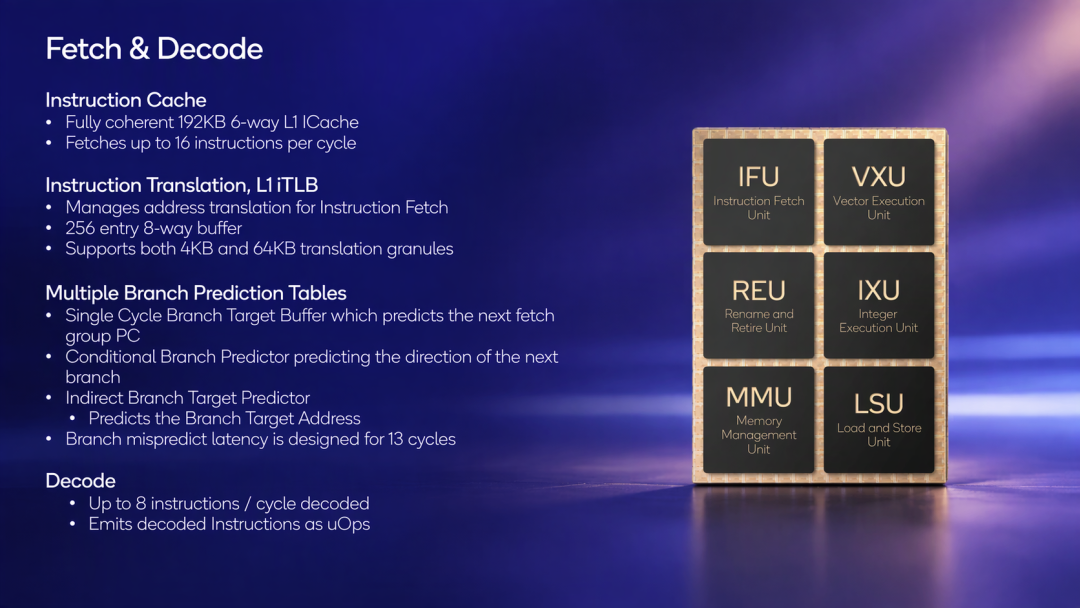
没有原生16KB,高通用"奇偶页配对"打补丁:把两个相邻4KB页凑成一个大映射塞进TLB,配对成功省位置,失败反而空占坑。结果是上代8E5的中核随机访问16~32MB内存基本不用查页表,8EE6的中核超过1MB就得查;TLB miss后一次页表遍历延迟还从约50ns涨到77ns。查表更频繁、查得还更慢,能效横评里那些难看的曲线,底层原因之一就是它。知乎
另一半坑在FlexCache。8EE6把16MB共享缓存跟高频中核的时钟域、电压轨绑在一起:中核要缓存性能时,FlexCache没法及时拉频,延迟变大;真拉了频,共用电压轨又让闲着的小核陪着耗电,实测外围功耗能在53mW到763mW之间横跳。多核负载时每个核分到的缓存比上代更少,Oryon的预取器又偏弱——缓存一缩水,性能立刻原形毕露。知乎
TLB粒度、FlexCache的时钟域和电压轨,全是流片那一刻写死的硬件。系统更新能改调度、改温控,改不了硅片上刻好的电路。所以答案是残酷的:16KB页是安卓生态的降压药,不是8EE6的救心丸——缓存债既卡在纸面生态,更刻在硅片里。就像给近视的人换盏更亮的灯——灯是好灯,治不了眼睛。哔哩哔哩知乎
对准备双11换机的人,三条实在建议:
第一,别等"OTA救8EE6"。查表延迟和缓存设计是硬件级的,等不来。
第二,8EE6机型什么价值得买?云飞在直播里给过标准:和上代卖一个价,才可以。否则同价位的天玑9500机型、已降价的老款8E5旗舰,都更稳。哔哩哔哩
第三,真正的"修复"要等下一代芯片。这轮横评说明了一件事:不是2nm工艺不行,是设计功力分高下。
高通这一课,学费有点贵。