










 深耕数码、汽车、AI兴趣领域





22
28
从“跑模型”走向“交付任务”,龙擎空天瞄准端侧智能体
2026-11-16 11:21:18
0点赞
0收藏
0评论
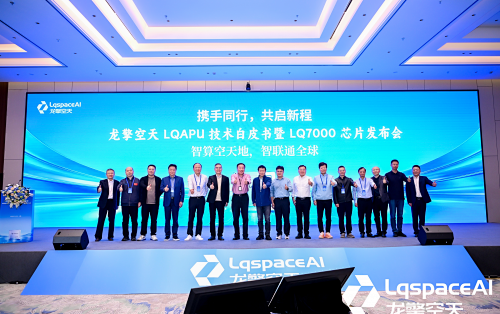
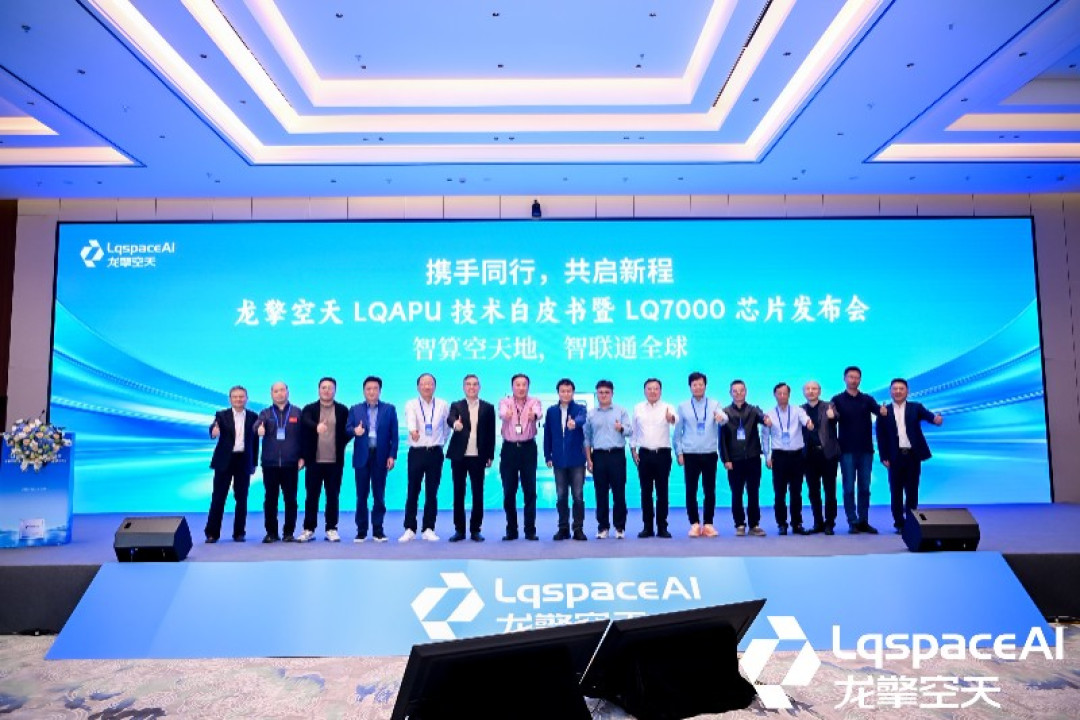
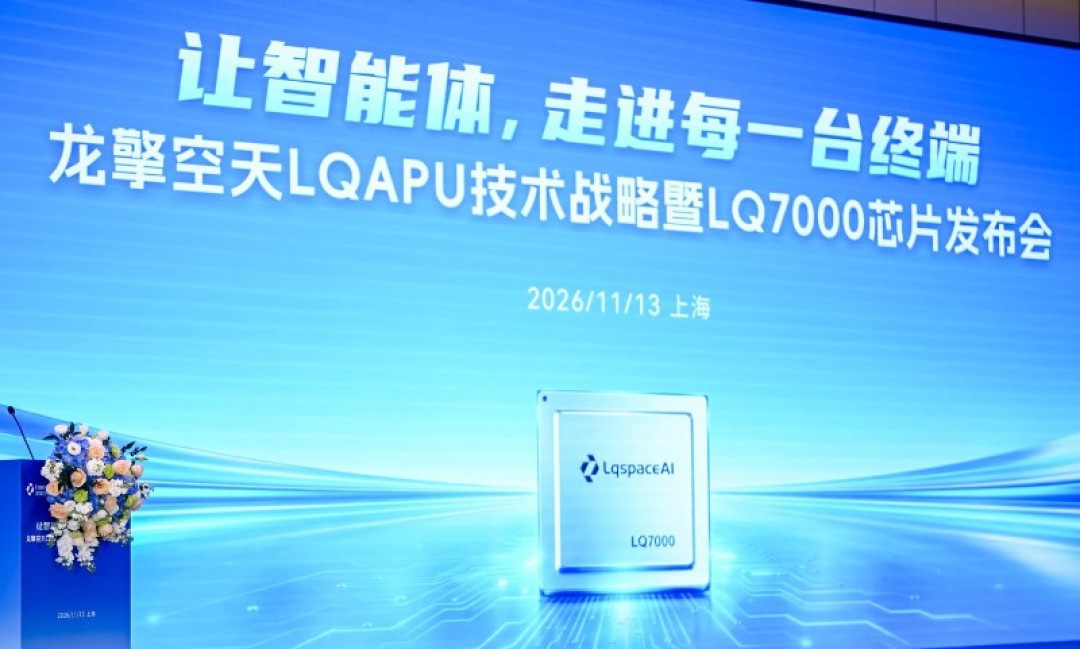
11月13日,龙擎空天LQAPU技术战略暨LQ7000新品发布会举行。伴随大模型从“回答问题”走向调用工具、处理多步骤事务,端侧AI芯片面对的已不只是一次推理的速度,更包括任务如何排队、上下文如何保存、工具如何安全调用,以及中断后如何恢复。围绕这些问题,龙擎空天在发布会上提出以“智能计算+智能连接”为双轮驱动,发布LQAPU智能体处理器技术架构,并带来首款产品LQ7000。
 f7729e6c73b33ccefccebe77f8107bdb
从公开分享的技术思路看,LQAPU架构所瞄准的并非单一模型的跑分竞争,而是智能体完成一件具体事情的全链路效率。以会议资料整理、知识检索、邮件发送等任务为例,模型推理只是其中一个环节;数据准备、调用外部工具、等待反馈、权限校验和人工确认,往往共同决定了最终的完成度。
把“完整任务”而非“单次推理”作为优化对象
发布会上对APU的阐释,首先来自对智能体工作方式的重新理解:智能体需要在授权范围内调用模型和工具,并根据结果继续推进流程。与传统面向单次模型推理的加速路径相比,LQAPU更强调软硬件协同,将计算、状态、任务调度和可信执行放进同一套框架。
其功能架构分为五层:底部两层为异构硬件底座、计算与上下文协同,中间的智能体运行时由软硬件共同完成,上面两层是软件与应用。整体可概括为“1+5+1”:一个可编程计算基础、五项智能体机制、一套软件平台。硬件侧将稳定、高频且可验证的机制固化下来;模型选择、业务规则与权限策略等变化更快的内容,则保留在软件层。这种分工的关键,是在保证效率的同时,避免把仍在快速演进的业务逻辑锁死在芯片里。
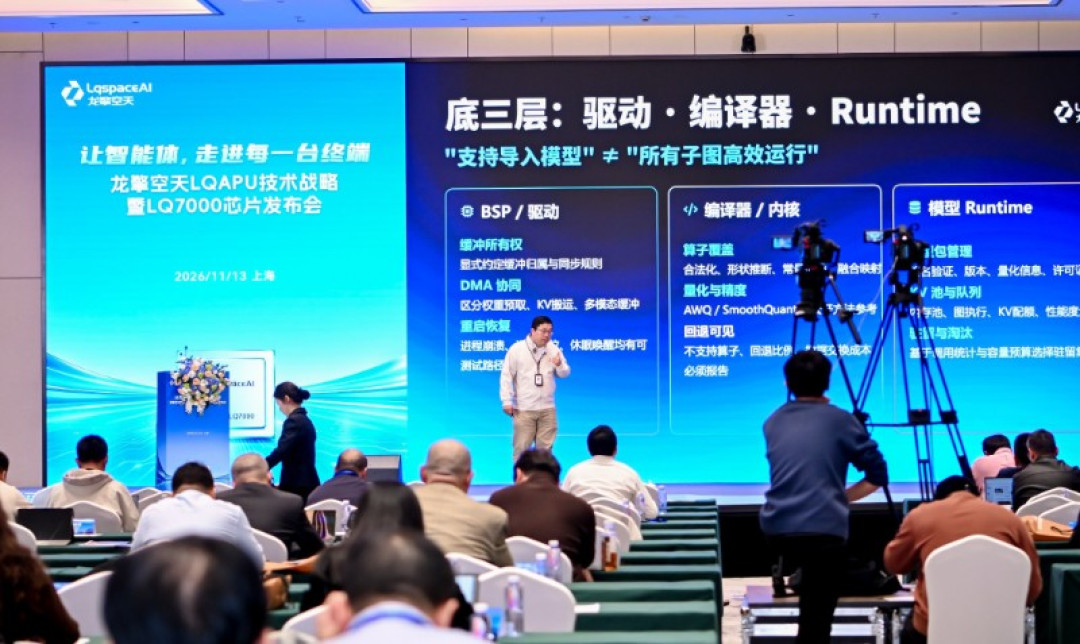
状态可保存、任务可恢复:为长链路智能体留出“记忆”
智能体任务常常跨越多个模型、工具和数据源,长上下文与多轮协作也会带来持续的资源占用。LQAPU的上下文与记忆管理,把模型权重、KV缓存、会话与任务状态、长期知识四类状态分类管理,并按使用频率分为活跃、驻留、持久三个逻辑层次;其中KV缓存随对话增长,是端侧内存的主要压力,以“页”为单位调入换出,每页带版本与权限。在任务执行上,执行状态与资源状态分开记录:任务在等待工具或人工确认时可让出计算资源,条件具备后再恢复。简单来说,它希望让“任务仍在继续”与“资源始终被占用”成为两件可以分开处理的事。
在调度层面,分享中提到双层任务调度:上层决定先处理什么,下层决定在何时、在哪种计算资源上执行,并支持抢占与恢复。配合跨模型、工具与设备的统一标识,将模型计算、缓存命中率、等待时间等信息串联起来,系统才能真正定位一项任务慢在哪里、卡在何处,以及下一轮应该如何优化。
端侧本地闭环,安全不能只靠“有权限”
LQ7000以RISC-V处理器负责通用控制,由自研可编程GPNPU承担模型计算,标量、向量、矩阵统一编程;目前以M.2与PCIe两种智能加速卡形态提供评估,AI Box等整机形态在规划中。在LQAPU架构中,LQ7000提供可编程计算基础,智能体运行时目前由软件实现,计算交给LQ7000执行。发布会展示的方向包括会议智能体、行业知识库、离线AI PC等:用户在本地设备上调用模型与工具,数据、模型及新生成内容可留在本地处理,以减少对云端接口的依赖。
安全机制是这套叙事里的另一层重点。技术分享强调,指令格式正确、用户有权限,并不等于动作可以执行:上下文管理、身份与权限校验、结构化输出检查、执行记录以及高风险场景的人机确认,缺一不可。尤其涉及支付、敏感数据或关键指令时,系统需要有额外的拦截与人工确认机制;硬件层面的可信加载、数据隔离、可恢复与状态监测则为执行链路再增加一道防线。
热点科技观察
大模型走向智能体,芯片的价值判断也在发生变化。用户最终在意的不是模型回答得有多漂亮,而是一个任务能否稳定、可控、可追溯地完成。LQAPU架构选择从任务管理、状态保存与安全执行切入,LQ7000作为其可编程计算基础率先落地,正是在回应端侧智能体走向真实业务后的共性难题。若后续在本地化模型适配、工具生态与行业验证上持续形成闭环,这类面向“任务交付”的处理器,有机会成为AI PC、行业终端和边缘计算设备中的一块关键拼图。
作者:马小斌