「12G显卡跑125B,每秒93个词元」——这条视频在B站冲到28万播放那天,不少人把吃灰的旧卡翻了出来。一个半月过去,开源项目Strata从0.1一路更到0.2.14,11月15日的0.2.14把提示词读取换成了自研kernel,NVIDIA和AMD同步覆盖。但真正装上机器的人,正在评论区排着队泼冷水:这玩意儿省下来的是显卡,吃进去的恰恰是内存,外加你的耐心。哔哩哔哩GitHub
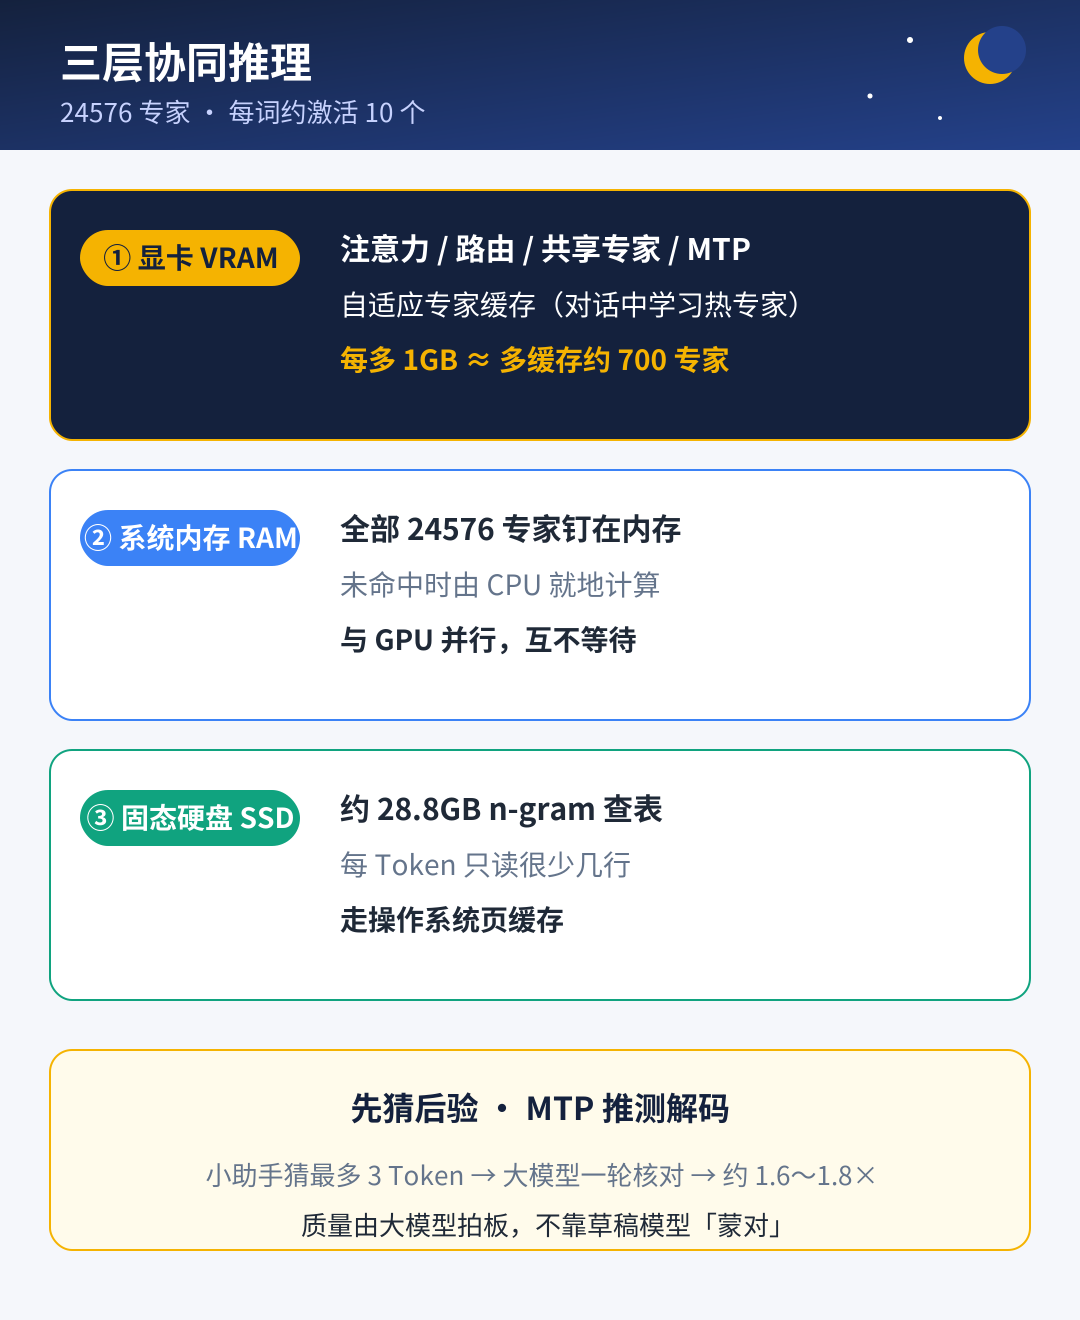
原理一句话:Qwen3.8-Flash-Next这种MoE模型有48层、每层512个专家,加起来两万多个,但写一个token每层只需要叫醒约10个。Strata的做法是最活跃的那几千个专家常驻显存、全部专家塞进内存、28.8G的n-gram查找表放SSD,显存+内存+SSD拼成"穷人版统一内存"。官方给过一个好记的换算:显存每多1G,约能多缓存700个常驻专家。小红书知乎
速度这事,一机一天花。11月15日的官方发布说明里,同一版引擎在5090上跑chat能到254。Mac M5 Max 94.7,5070Ti却只有17~22。官方在RTX 5070上自报94。社区用同一张5070(12G)+64G内存实测87,2080Ti+96G内存勉强跑20。也有狠人榨出240:换Q4量化、上下文扩到512K、把tail_skip从默认的7改成1、线程数固定成4。所以官方数字从17到254都摆在那,起跑线得看你的内存、带宽和肯不肯调参。GitHub小红书微博小红书
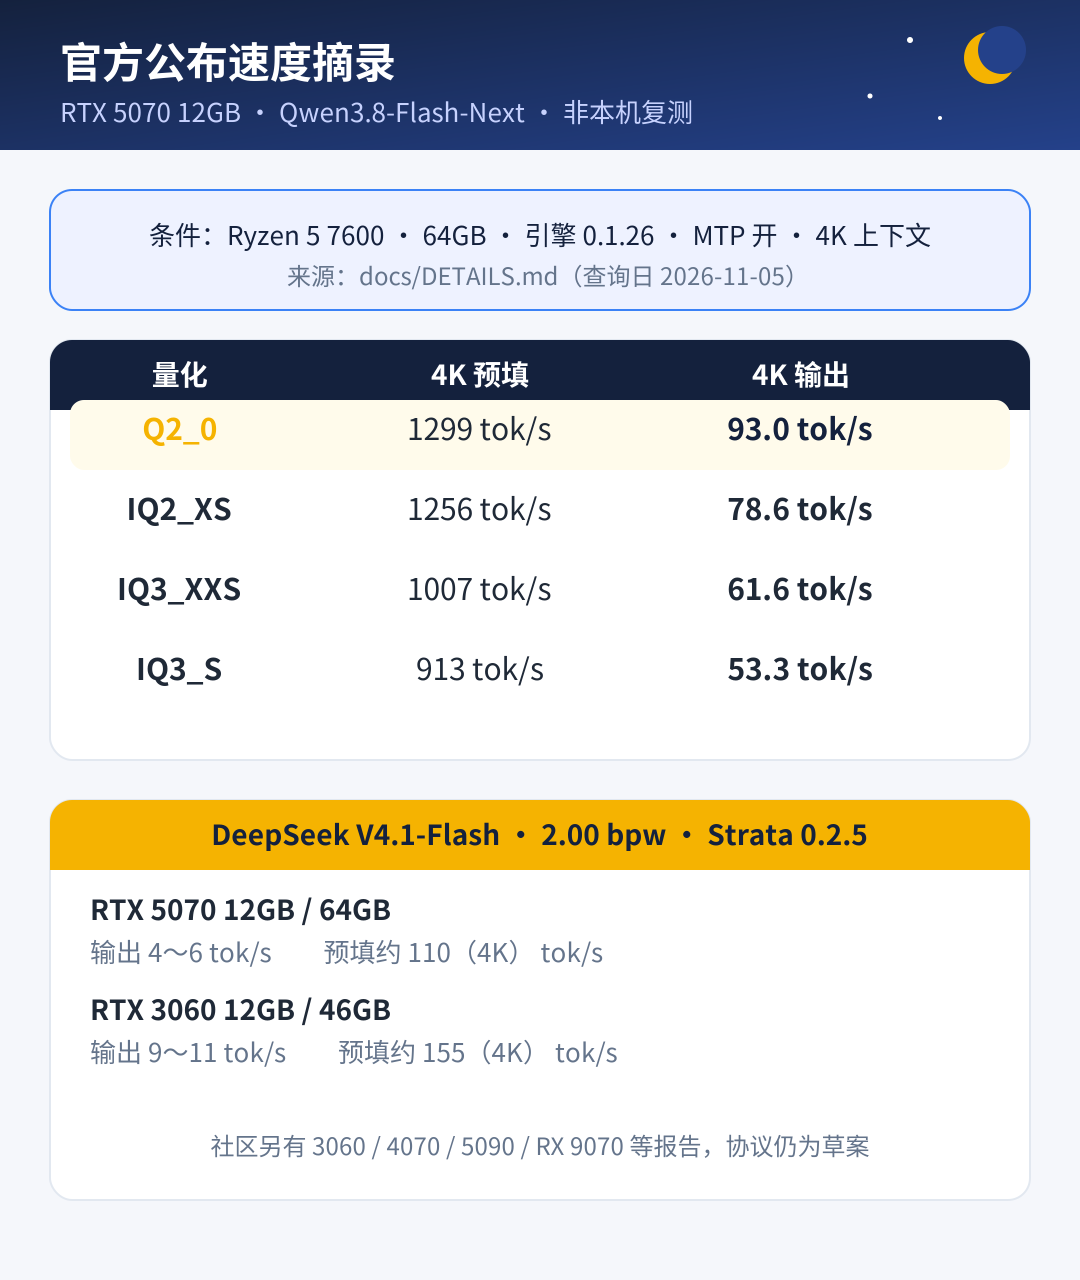
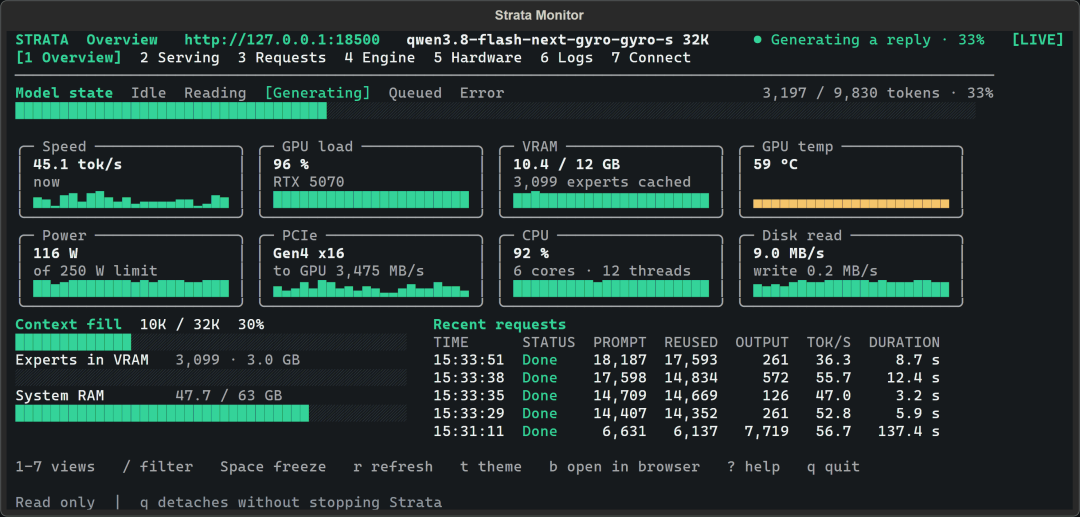
真正卡脖子的是内存。Strata官方最低门槛32G,说的是内存+显存的总和(再减5G余量)。评论区28赞总结很扎心:12G显存是幌子,64G内存才是入场券。而且decode本质是带宽题不是算力题,5090+192G内存照样只跑到100出头。瓶颈在内存带宽不在显卡。冷知识:DDR4均价已经涨了一两百。哔哩哔哩哔哩哔哩小红书哔哩哔哩
装之前记住三个坑:
① 降量化会变笨:实测IQ2_XS档在需要写过程的数学题上比IQ3_S低5~7个百分点。小红书
② 长任务可能死循环:个别量化版配合MTP会陷入重复输出、跑分塌方,社区目前给出的解法是把并发改成单次请求串行。tail_skip=1的速度翻倍是真的,但"拿质量换速度"的争论至今没停;哔哩哔哩
③ 老版本的坑别照抄:0.1.39按宿主机核数默认CPU worker数,小机器上全是无效自旋,0.2对齐worker后同条件仍快1.5倍以上,首字等待从约1秒降到0.5秒。Linux还能再省约23G内存占用;AMD的自研kernel要到0.2.14才补上,Intel Arc还停在旧引擎。小红书
挑战者Basalt已经被社区拿来做对比实测。Maya等同类项目也在被拿来比较,分层卸载这场仗刚打第一年。想本地跑125B,先算算内存和SSD够不够,再回头看那张12G的卡。哔哩哔哩