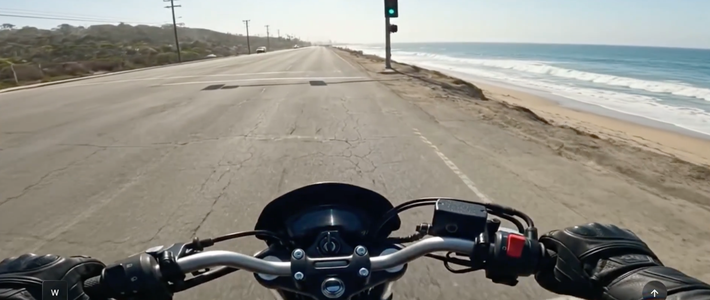
美东时间10月27日,谷歌DeepMind发布了新一代世界模型Genie 4,官方称这是其迄今最逼真、交互能力最强的世界模型。 它目前仍处于研究预览阶段,用户可以在模拟运行的过程中输入提示词来修改场景。 和一年前的上一代Genie 3相比,这次真正的增量不是“画面更高清”:生成的世界第一次自带同步的声音,并且允许你在它运行的过程中随时改写。 官方划定的边界同样清楚——单次生成的交互体验最长约2分钟,恰好是前代上限的翻倍。华尔街见闻新浪科技36氪
先说Genie 4多出来的东西
第一是原生音频:风穿过树林、海浪、配乐,甚至角色的即兴对话,都随画面实时生成,Genie 4是该系列首款同步生成声音和画面的产品。 第二是实时编辑:模拟进行时输入文字指令,场景会当场响应,你可以修改天气、移动镜头、加一个人物。未来图灵36氪
更深层的变化是Gemini被拉进了模拟循环。谷歌把这条路线称为“混合世界模型”:Genie 4负责渲染,Gemini系列模型负责让画面贴近现实世界的外观和行为,把目标拆成一步一步,再一帧帧检查每一步是不是真的完成了。 官方演示里,Gemini 4 Argon承担任务拆解,在Apollo人形机器人下棋演示中把目标拆成步骤、驱动Genie 4逐步呈现执行过程。 提前拿到访问权限的a16z合伙人Justine Moore实测,创建世界通常不到30秒,而且推开一扇门、转身离开再走回来,那扇门依然开着。知乎·数字生命卡兹克36氪新智元
但“最逼真”是个只有两分钟、会漂移的世界
数字要先看准:网上流传的“24帧、720p”是2025年Genie 3的官方口径,这次谷歌没有公布分辨率和帧率。 官方博客明确承认,Genie 4仍是一项早期研究成果,长时间交互中视觉细节和物体的持续存在性仍可能发生变化或偏移。 谷歌承认,复杂物理互动、可读文字以及长时间维持环境一致性等问题仍有待解决。梦兽编程机器之心华尔街见闻
社区的质疑更具体:在Hacker News的讨论里,做强化学习的观点认为模拟器的确定性才是命根子,加音频是产品化而不是技术突破。梦兽编程
谁能先玩到,以及它先冲击什么
现阶段Genie 4首先向少量经过筛选的测试者开放,未来数周计划向Google AI Ultra订阅用户提供使用权限,并向部分开发者开放Gemini API和Google AI Studio的早期访问。 谷歌已经开始内测Genie 4,Ultra用户可以去申请waiting list。 生成的视频和音频都将包含Google的SynthID数字水印,用于识别AI生成内容。华尔街见闻新智元机器之心
游戏、影视创作端,创作者可能不用再花大量时间搭场景;但演示惊艳和稳定生成,是两回事。 DeepMind产品经理Diego Rivas给的说法同样克制:公司正在与合作伙伴共同研究这项技术如何融入现有工作流程,以及它的能力边界在哪里。 谷歌也把机器人训练列为方向之一,让它们在进入真实世界之前,先尝试执行复杂任务——如果成本足够低,这可能才是世界模型真正改变现实的入口。微博华尔街见闻机器之心
下一个值得盯住的信号是:Genie 4向更多用户开放之后,帧率、长时一致性和“两分钟”的实际体验,能不能经得起未经剪辑的实时演示检验。