







 深耕数码兴趣领域






13
14
AMD Radeon AI PRO 9700 32GB评测:后AI时代的高性价比专业显卡
2026-10-12 18:04:21
0点赞
0收藏
1评论
Radeon AI PRO 9700是AMD在2025年底推出的一款RDNA4架构中端专业工作站显卡,定位 “AI 推理+专业创作” 双核心场景,以 32GB 大容量显存、专用 AI 加速单元与专业级驱动生态为核心卖点,在300W功耗档位下实现了 AI 算力与图形渲染能力的均衡配置,瞄准万元级专业显卡市场的高性价比赛道,在如今“按显存定价”的市场上,其万元价位拥有32GB显存显得性价比尤为突出。
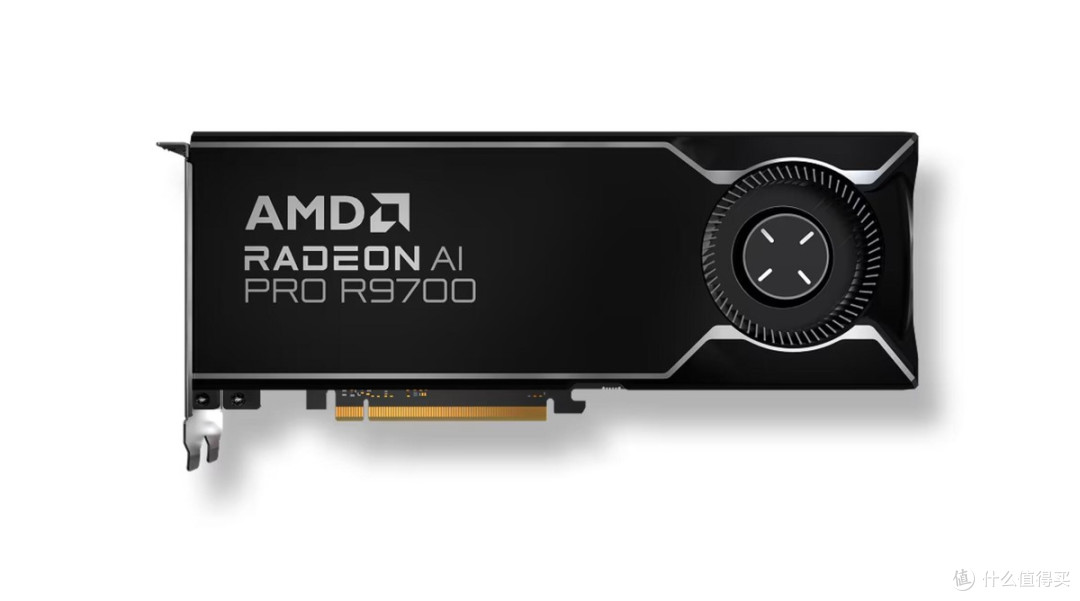
本次评测将围绕理论3D性能、专业应用性能、生成式AI测试三个方面展开,量化评估该产品在 “后 AI 时代” 的综合竞争力与场景适配价值。
产品规格
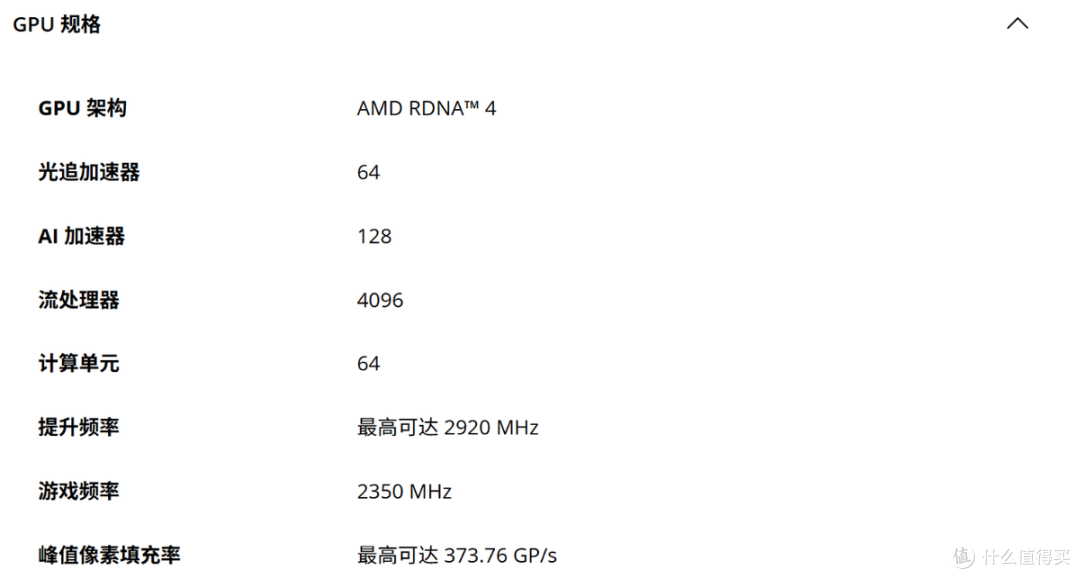
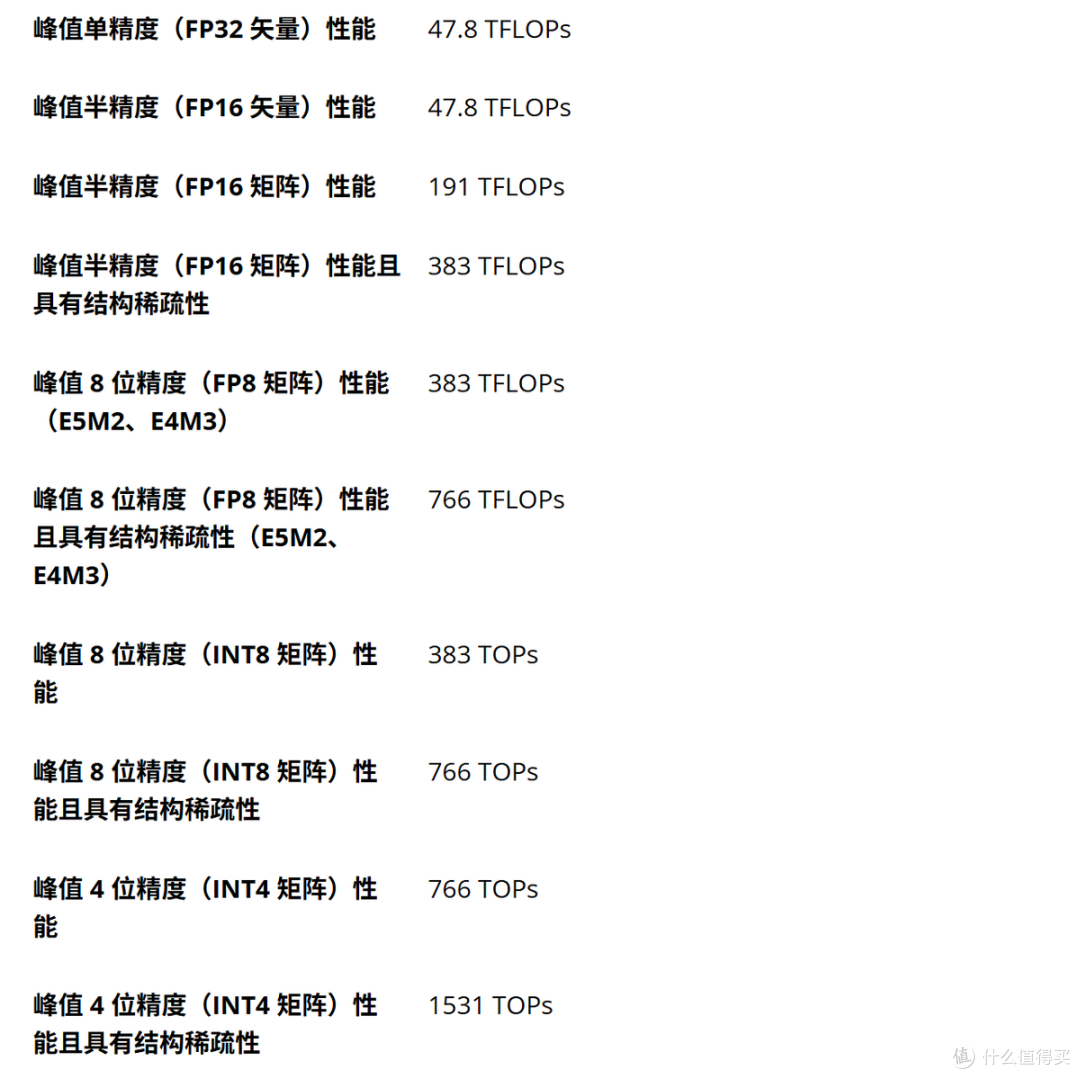
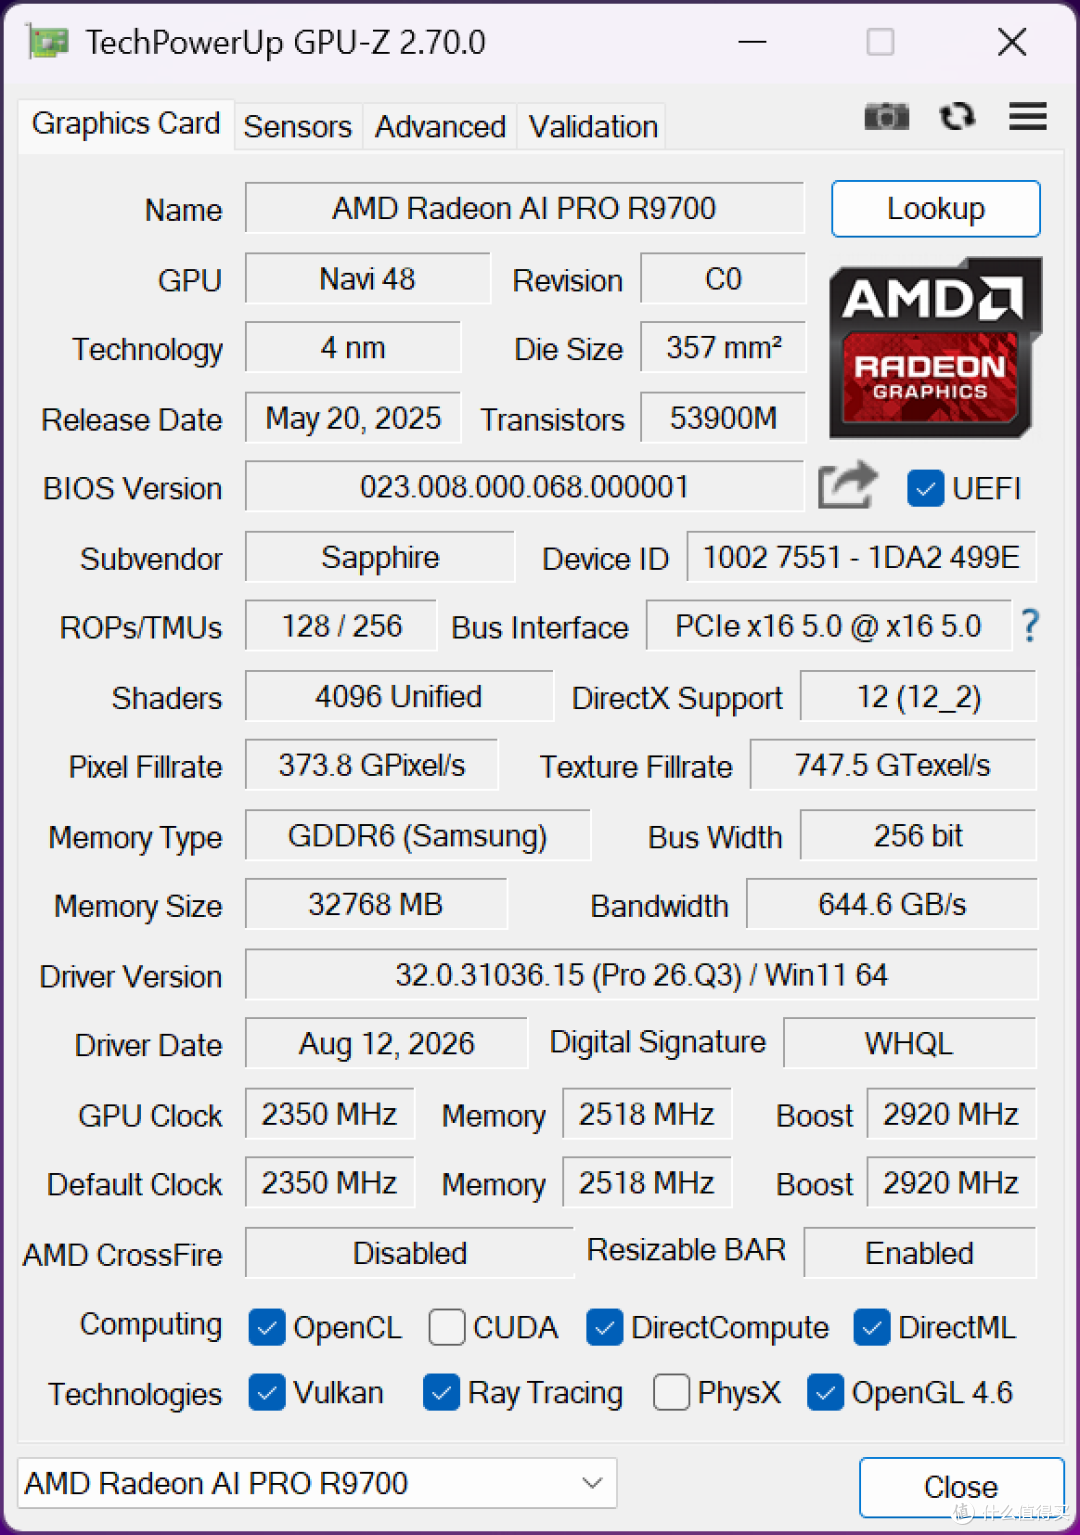
该卡采用台积电4nm工艺的Navi 48 核心,RDNA4 架构,核心规格为64组CU(计算单元)、4096个流处理器,集成64个第三代光追加速器与128个第二代AI加速器,原生支持INT4/FP8混合精度推理,理论单精度FP32计算能力为47.8TFLOPs,整卡TPP计算能力为3062,与桌面级显卡Radeon RX9070XT同源,可同时兼顾专业渲染光影计算与AI高吞吐推理需求。
显存配备 32GB GDDR6,256bit位宽下带宽可达640GB/s,Linux环境下完整支持ECC纠错,可原生承载30B参数级大模型单卡部署与8K级素材渲染,避免显存溢出导致的计算中断。供电采用12V-2×6接口,标准TBP功耗300W,推荐搭配750W以上工作站电源,单位功耗算力比相较上代Radeon PRO W7900实现显著提升。
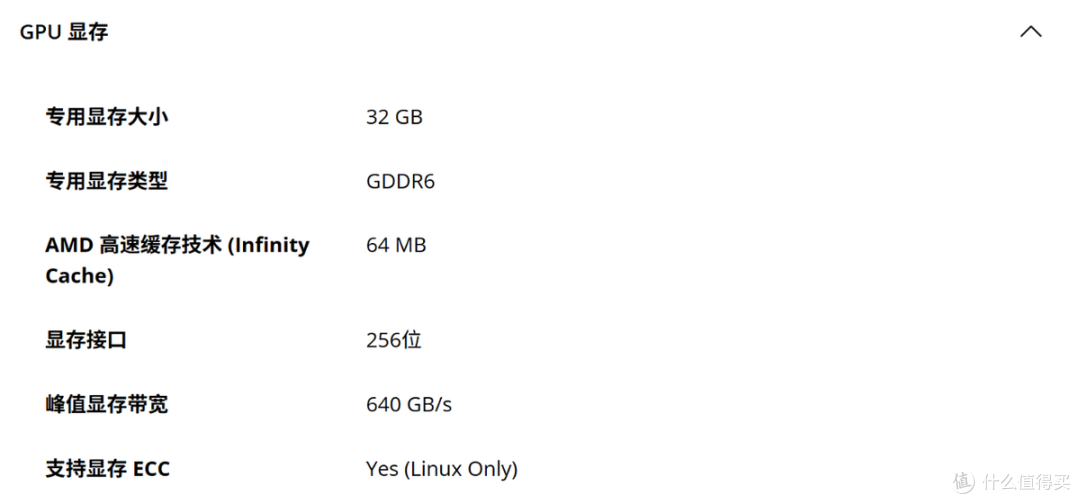
此外,该卡集成 64MB Infinity Cache与PCIe 5.0 ×16接口,标准配备4个DP 2.1输出接口,采用OTES涡轮散热模组,标准PCIE 2slot设计支持多卡并排部署。对比同价位消费级显卡,其在 ECC 功能、专业驱动认证与 7×24 小时负载稳定性上具备差异化优势。
测试平台简介
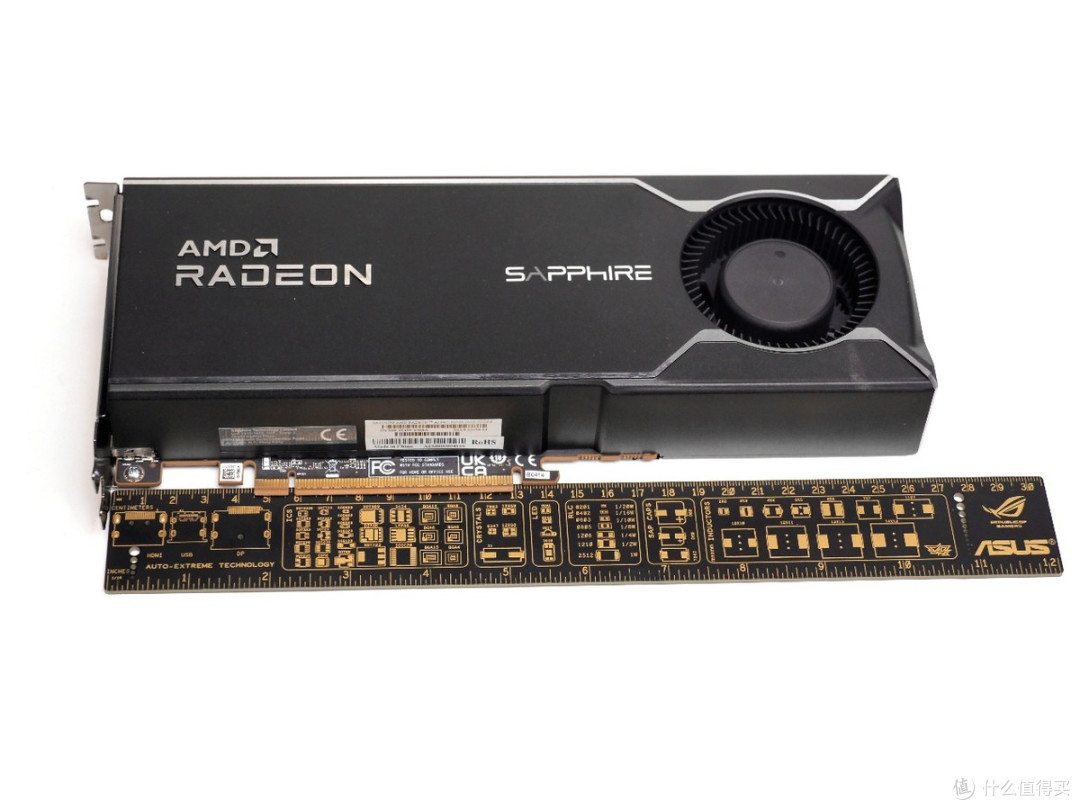
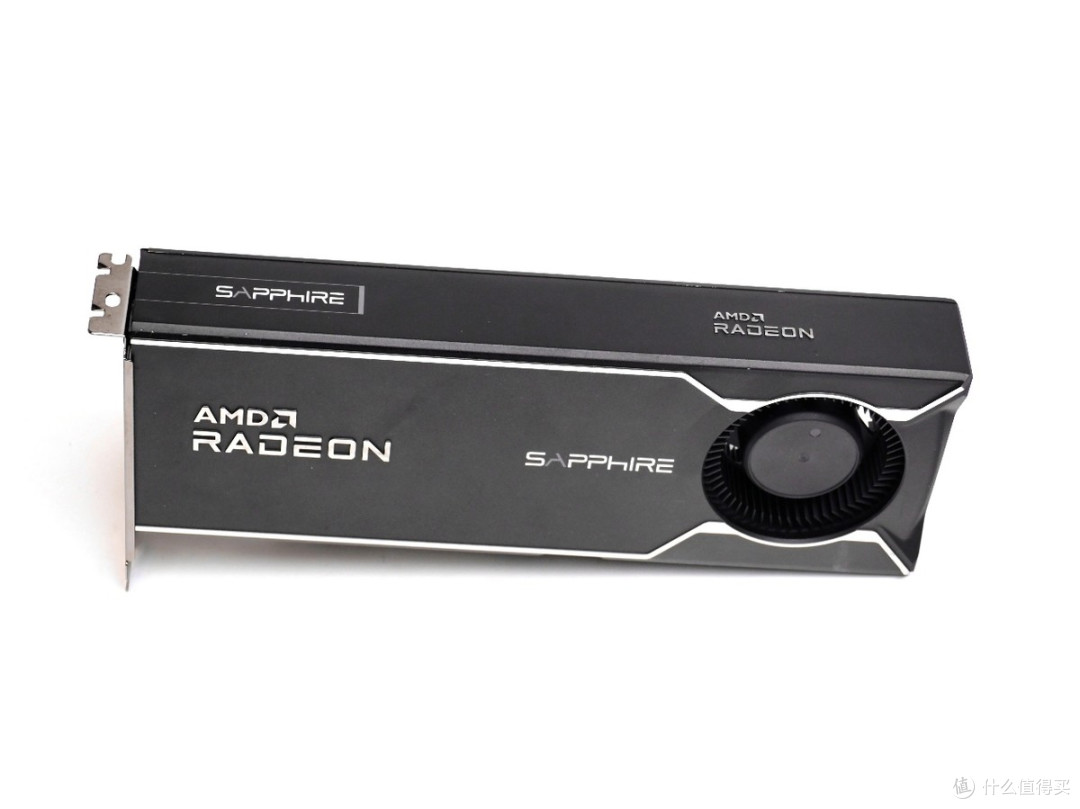
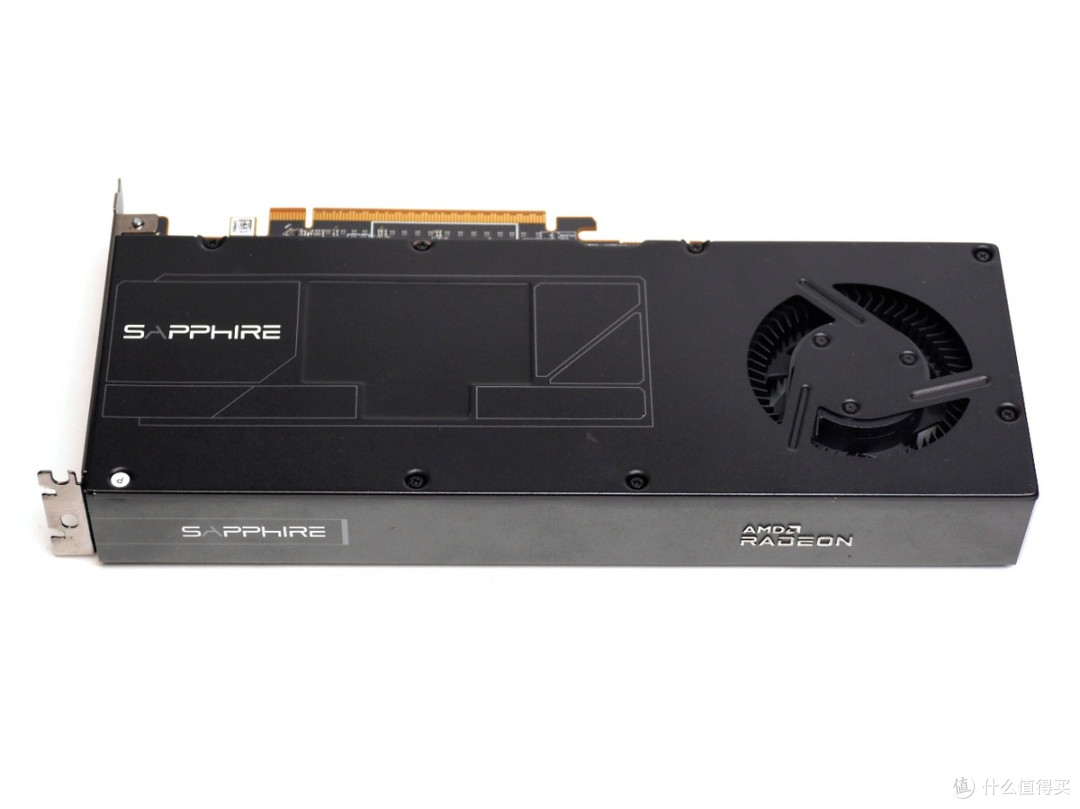
此次测试的显卡来自AMD显卡核心AIB厂商Sapphire蓝宝石,蓝宝石也是部分AMD原厂显卡和专业显卡的生产商与供应商。这张Radeon AI PRO 9700采用原厂标准设计,标准双槽10.5英寸单风扇OTES散热模组,不含挡板的显卡尺寸为268×112×40mm(含挡板为42mm厚度)
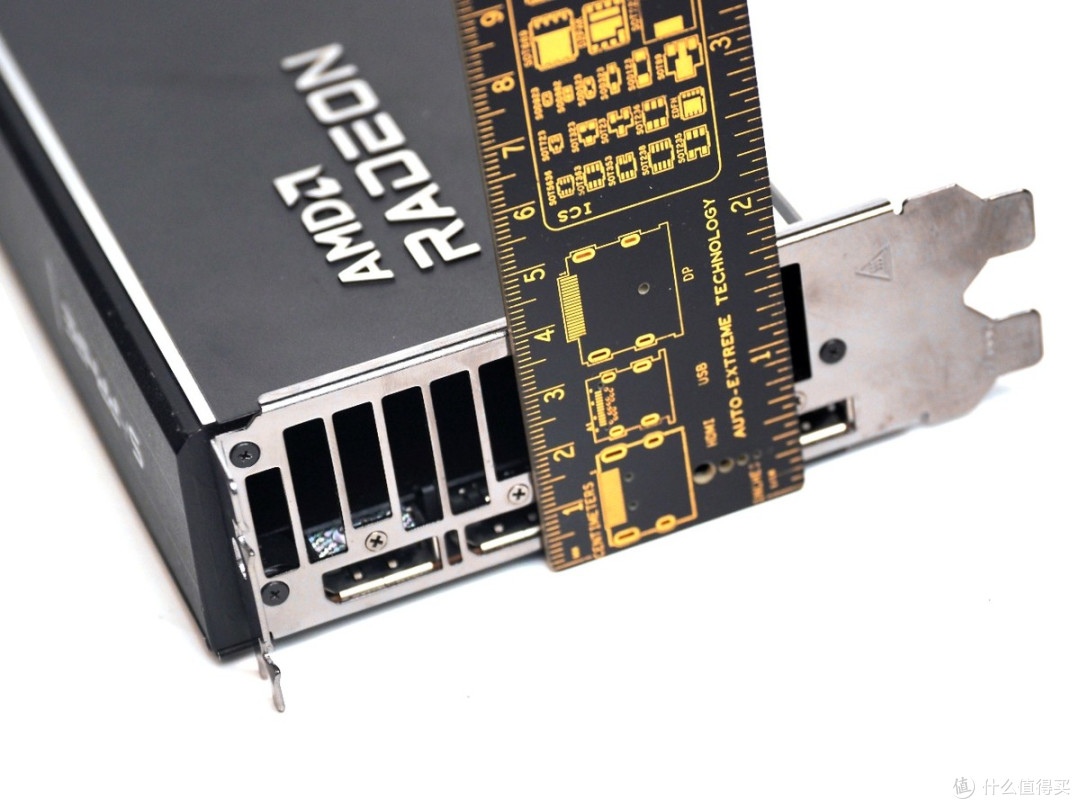
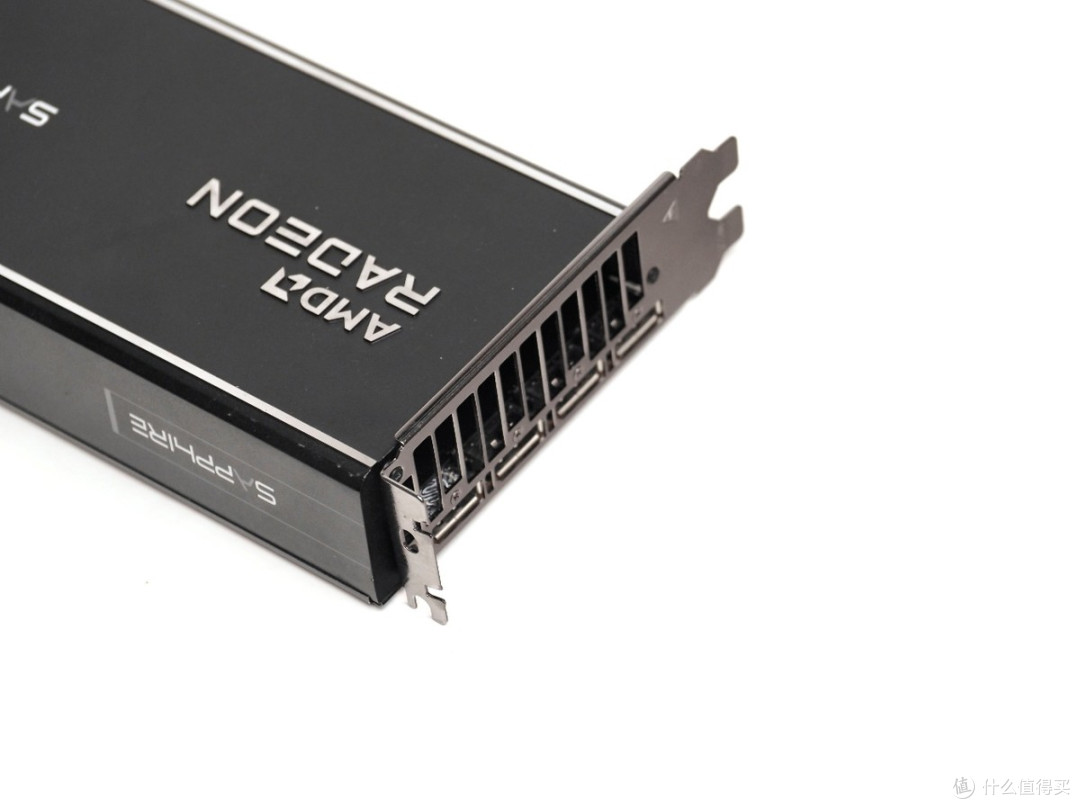
输出接口为统一的全尺寸DisplayPort 2.1×4,单接口支持8K60输出:
拥有全覆盖金属背板,加强板卡强度并辅助散热:
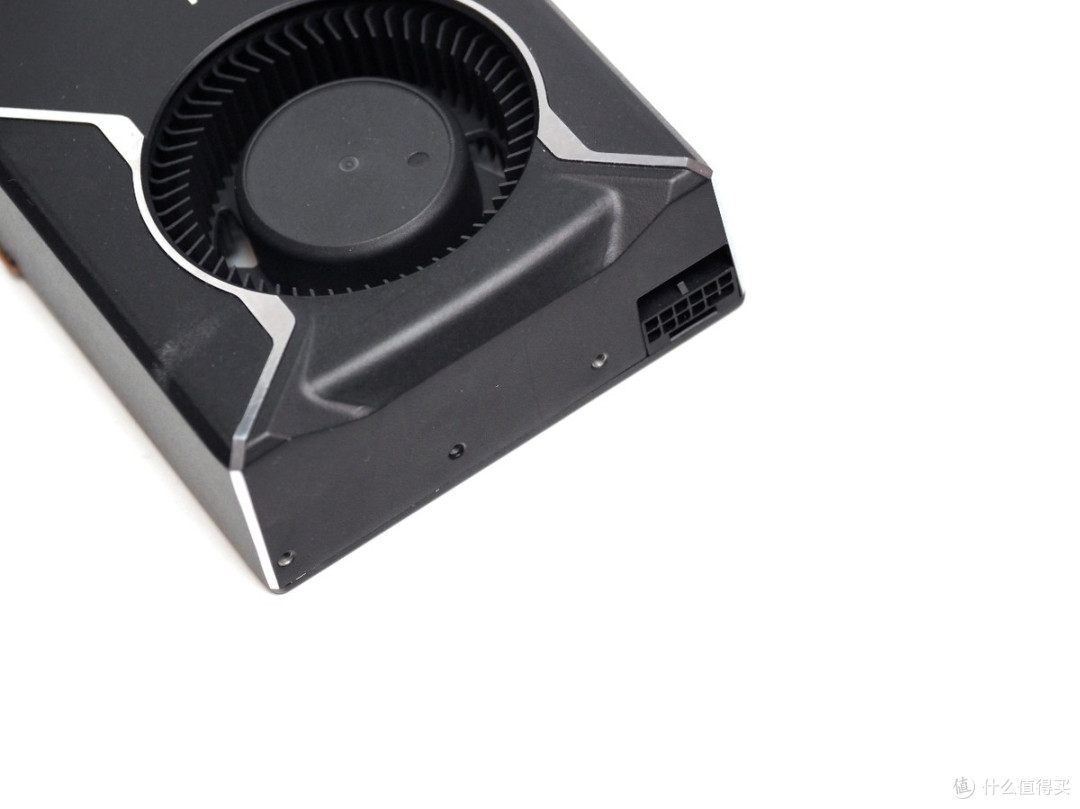
卡侧面留有工作站把手安装螺孔及ATX12V-2×6供电接口,由于该卡的TBP为300W,因此需使用标称为450W及以上的ATX12V-2×6/ATX12VHPWR供电线才可以正常运行。
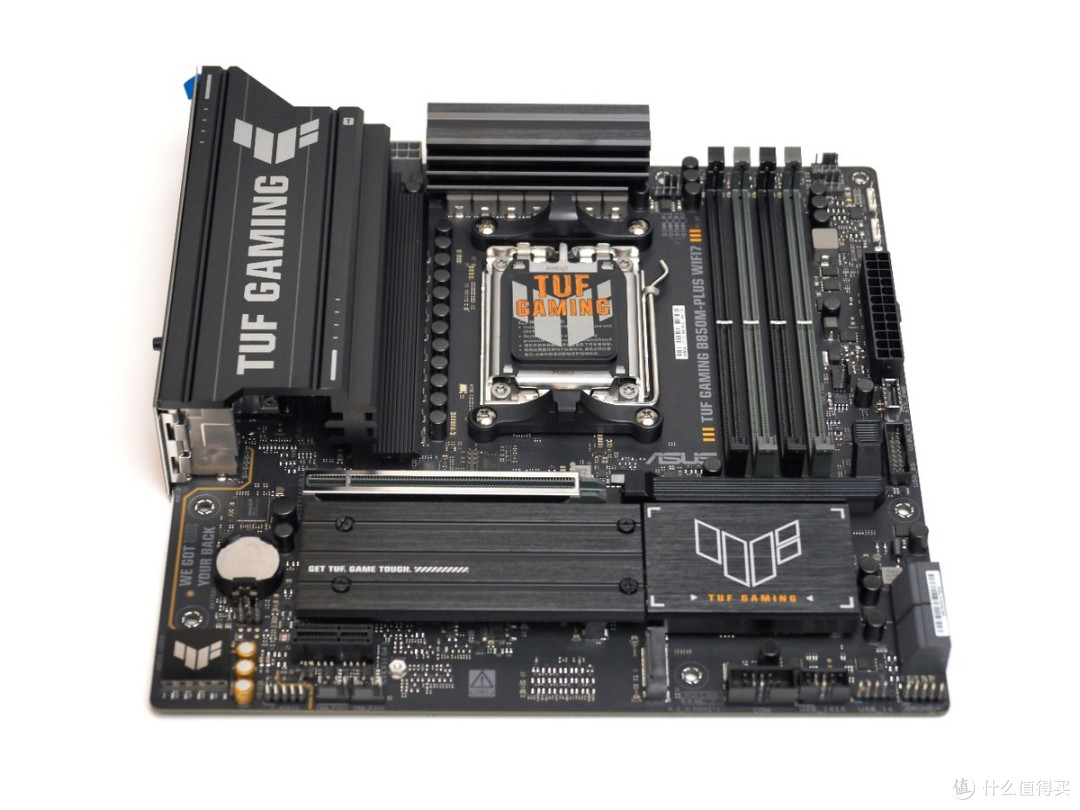
测试平台CPU使用AMD锐龙9 9950X,主板使用华硕TUF B850M PLUS WIFI7重炮手,支持PCIE 5.0 ×16,14+2+1相供电提供稳定的电源保障:
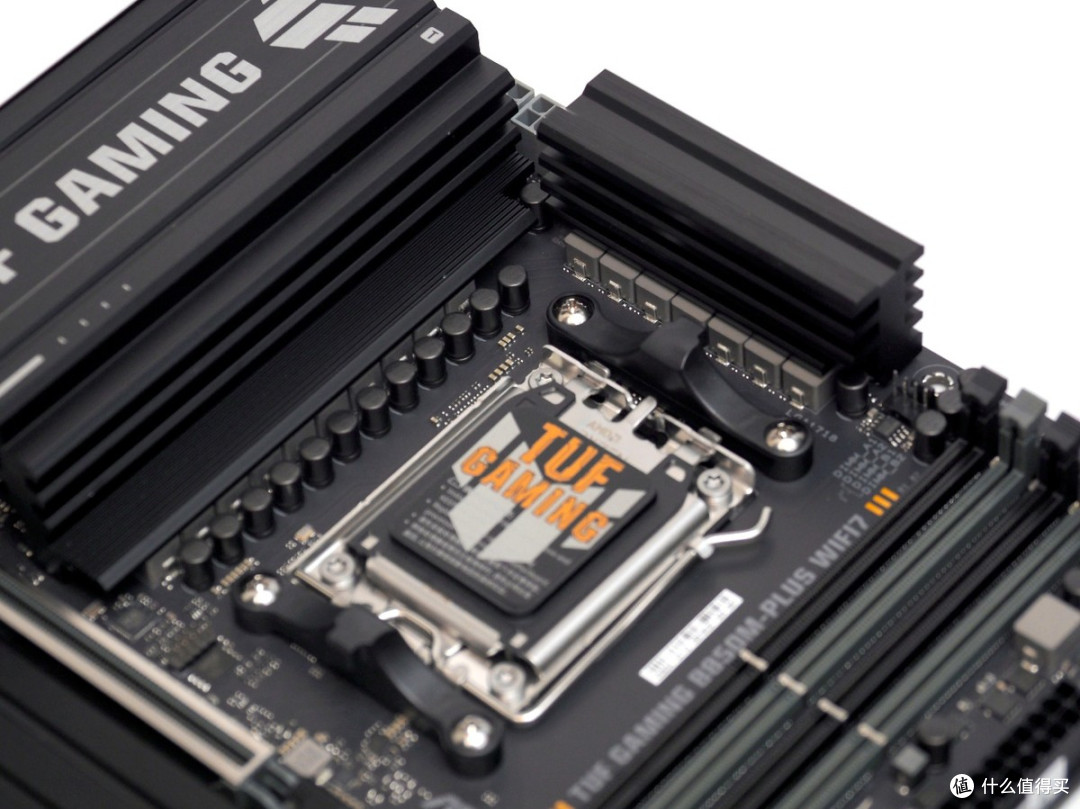
完整测试平台配置如下:
CPU:AMD Ryzen 9 9950X
主板:华硕TUF GAMING B850M PLUS WIFI7重炮手
内存:Corsair Vengeance LPX DDR5 6000C28 32GB ×2
散热器:利民Frozen Magic 280
显卡:蓝宝石Sapphire Radeon AI PRO R9700 32GB
华硕TUF Radeon RX9070XT 16GB
SSD:金邦 G7T 1TB
电源:ROG Thor II 1200W
显示器:ROG PG32UQ
显示驱动:AMD Software Pro Edition 26Q3/HIP SDK ROCm 7.2
理论性能及测试
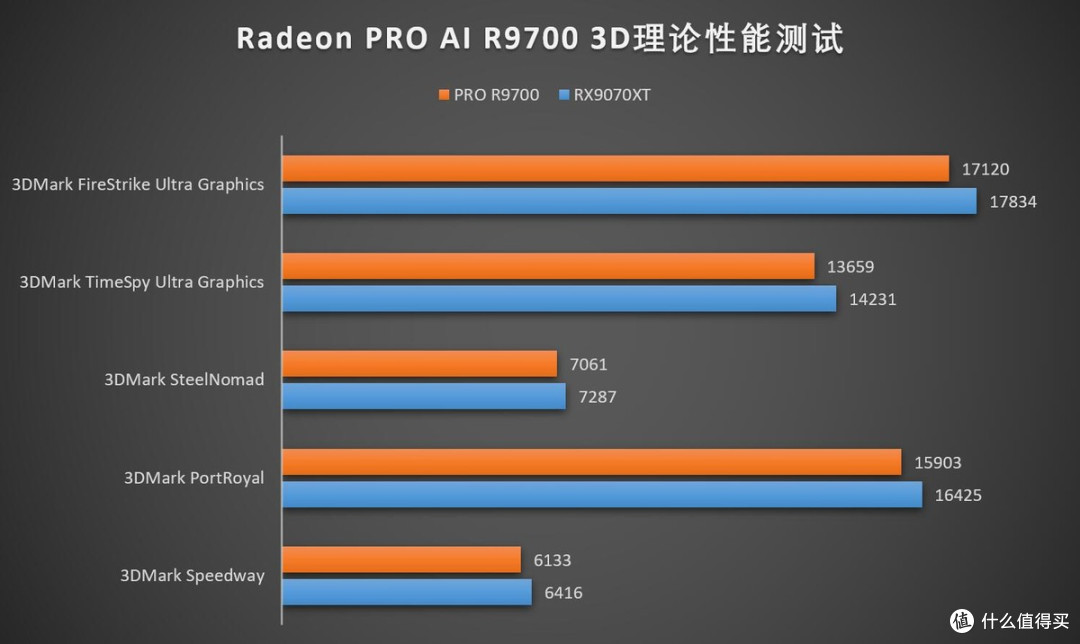
基于Futuremark 3DMark的3D理论性能方面,R9700略低于非公版的RX9070XT,主要原因是非公版采用三风扇多热管散热,且TBP为330W,显著高于R9700的OTES散热及300W TBP限制,因此成绩略高一些,但是差距不大,可以认为两卡在3D理论性能上处于同一水平。
基于SPEC GWPG的Specviewperf 15.0是测试显卡工业领域专业3D性能的套件,主要考量显卡在专业3D应用方面的性能。AMD在PRO驱动下对于消费级显卡的专业性能限制很少,因此消费级AMD显卡的专业性能也表现得相当不错,再加上功耗限制和频率都较R9700更高,因此在大部分测试中都略高一点,不过R9700依然在catia-07测试中利用大显存优势取得领先,其他测试项目也和RX9070XT差距不大。
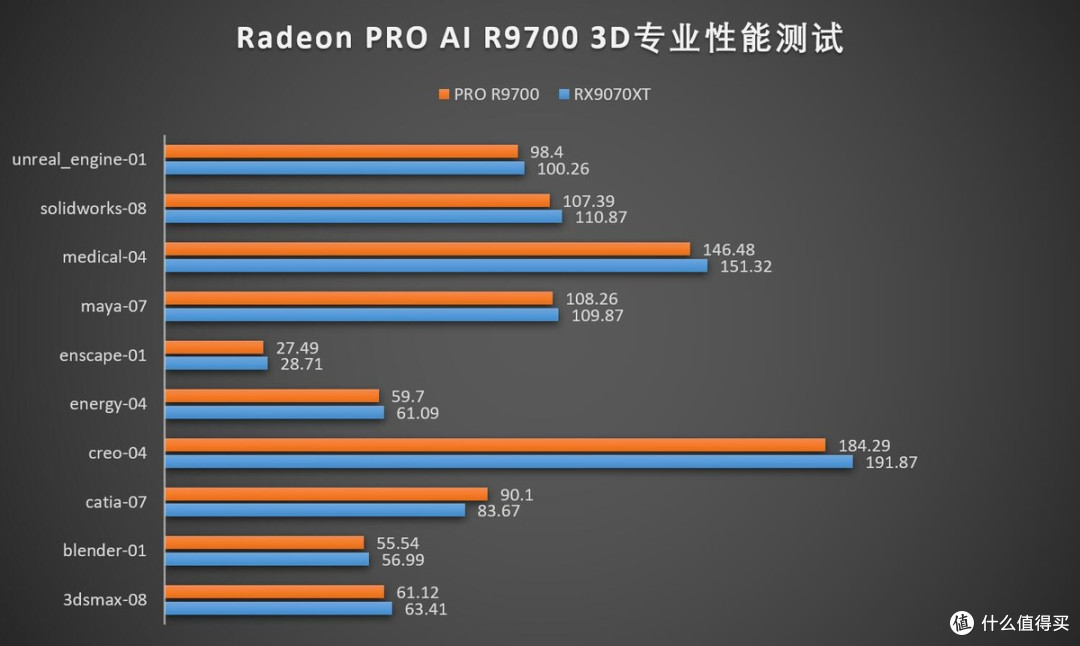
总体来说,Radeon AI PRO R9700与其消费级版本RX9070XT在理论性能测试方面的差距不大,主要原因是本身RX9070XT的16GB显存在日常理论测试中已经非常够用,R9700的大显存优势难以发挥。那么哪里能够发回R9700的大显存优势呢?接下来我们看生成式AI的测试。
生成式AI测试
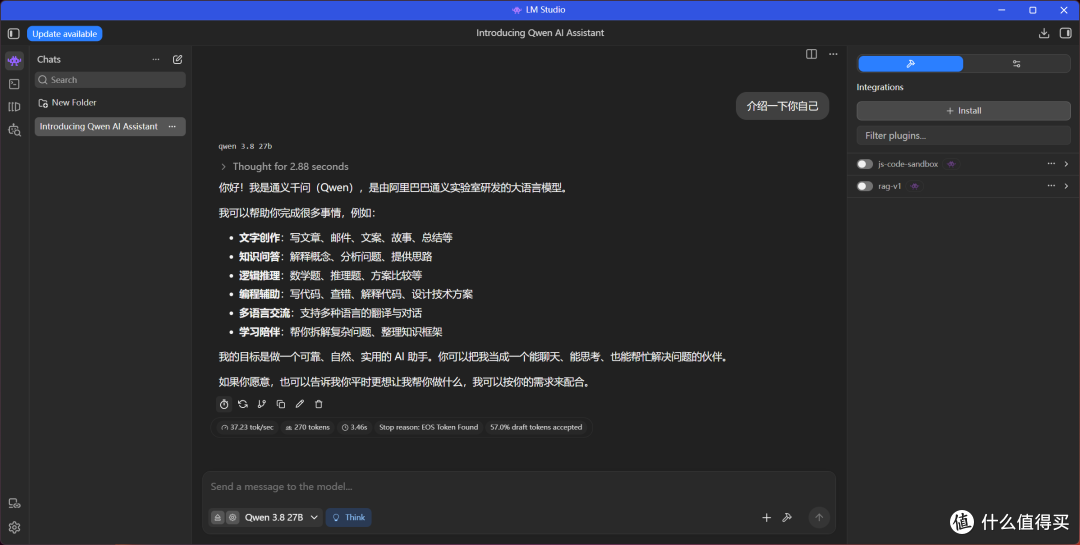
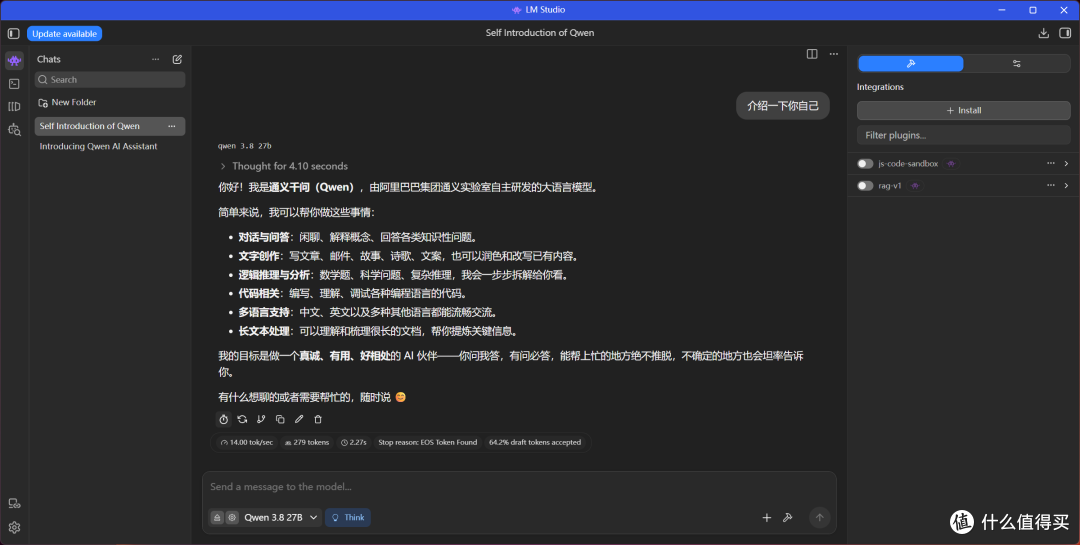
生成式AI方面,使用LM Studio加载Qwen3.8-27B-UD-Q5_K_XL大语言模型,该模型大小为19.4GB,因此理论推荐显存容量为24GB以上,使用32GB显存的R9700可以一次载入,首轮生成速度为37.23 tokens/s:
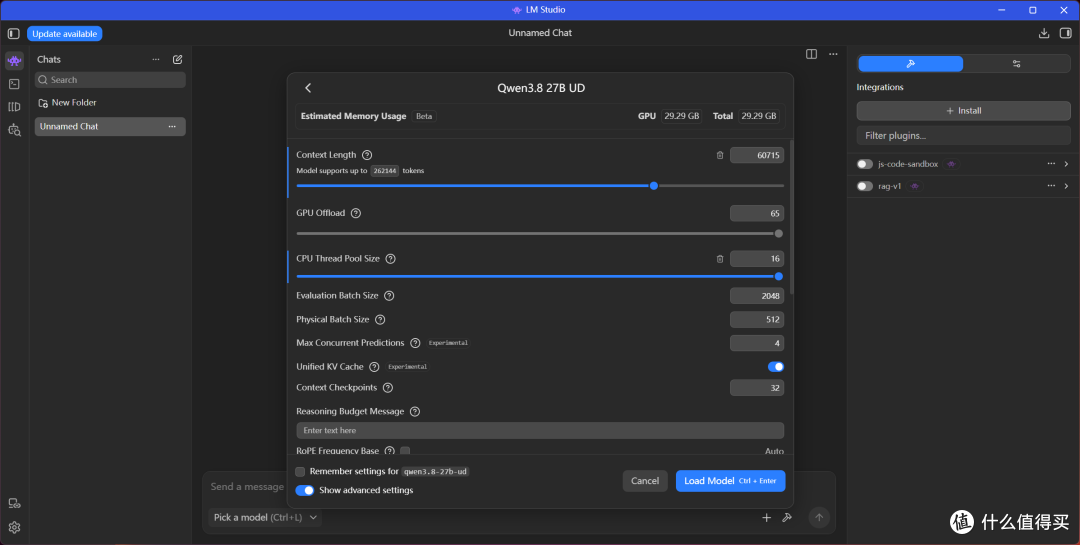
并且由于有更大的显存,R9700还支持超长的上下文长度和更高的GPU负载强度,使得本地部署的可用性大大提高:
而换成16GB显存的RX9070XT,生成速度只有14 tokens/s,相比R9700只有不到一半速度。
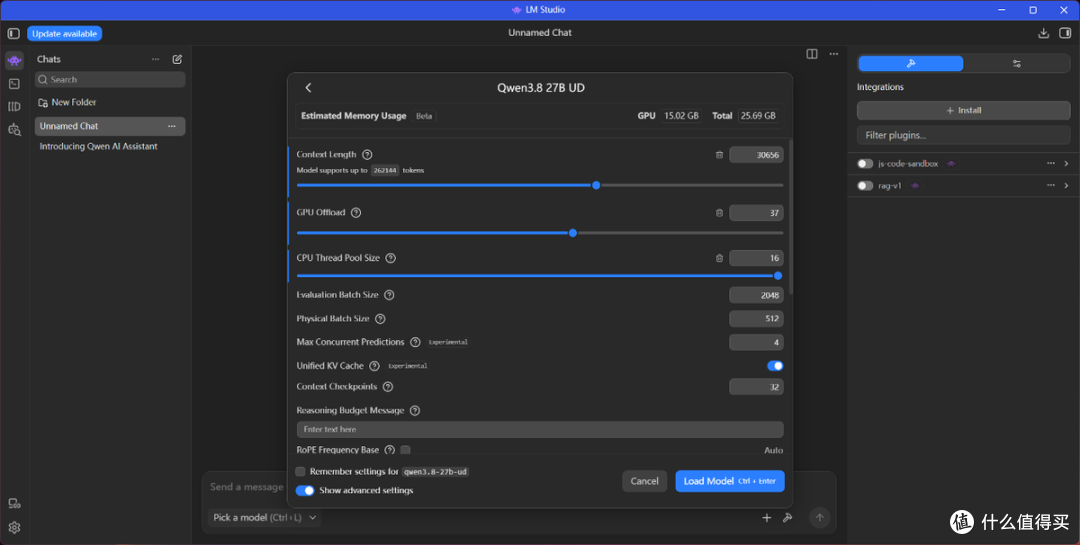
并且上下文长度也远远不如R9700,只能勉强到一半规模就已经几乎拉满了16GB显存,再加上没法拉满GPU负载,实际性能和使用体验相比R9700差距相当大。
除了LLM之外,R9700的32GB大显存还有在哪方面的生成式AI本地部署有优势呢?这里就要提到最近流行的本地部署AI新玩法——AI生成视频了。8月,MiniMax发布了最新的H3开源通用全模态生成模型,这个模型是目前本地部署上最强的AI视频生成模型,小至8GB显存即可以运行,这里我们使用B站UP机智罗制作的机智启动器加载comfyui,利用Windows下ROCm调用MiniMax H3及Qwen3.8 27B模型来生成视频进行测试。
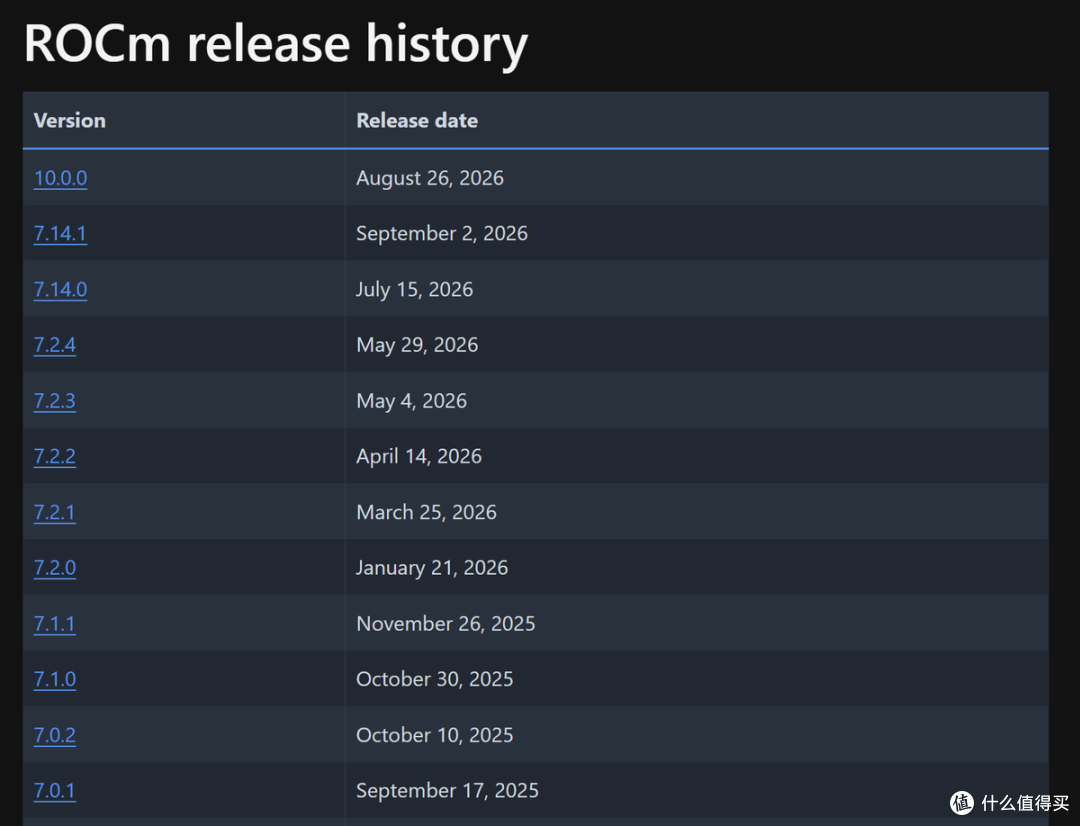
分别使用初版基于ROCm 7的版本以及最近更新的ROCm 10的版本进行测试:
首先是运行机智罗视频生成测速工作流,生成分辨率为736×1280 24fps的5秒打斗音+视频,结果如下:
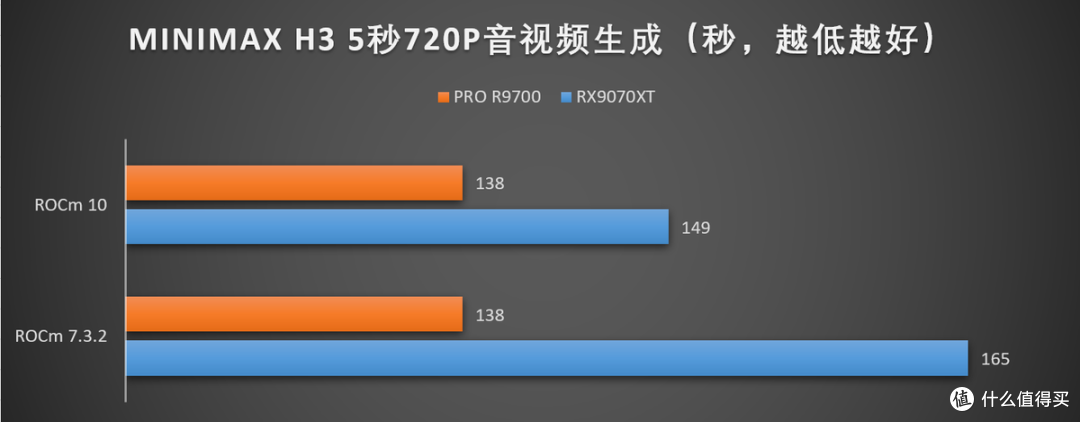
看起来差别较小,主要是因为5秒视频对显存压力不算太大,9070XT的16GB显存+内存尚可以应付,因此总体速度差别不大。不过可以看出新更新的ROCm对于RDNA4架构的GPU应用加速效果还是不小的。
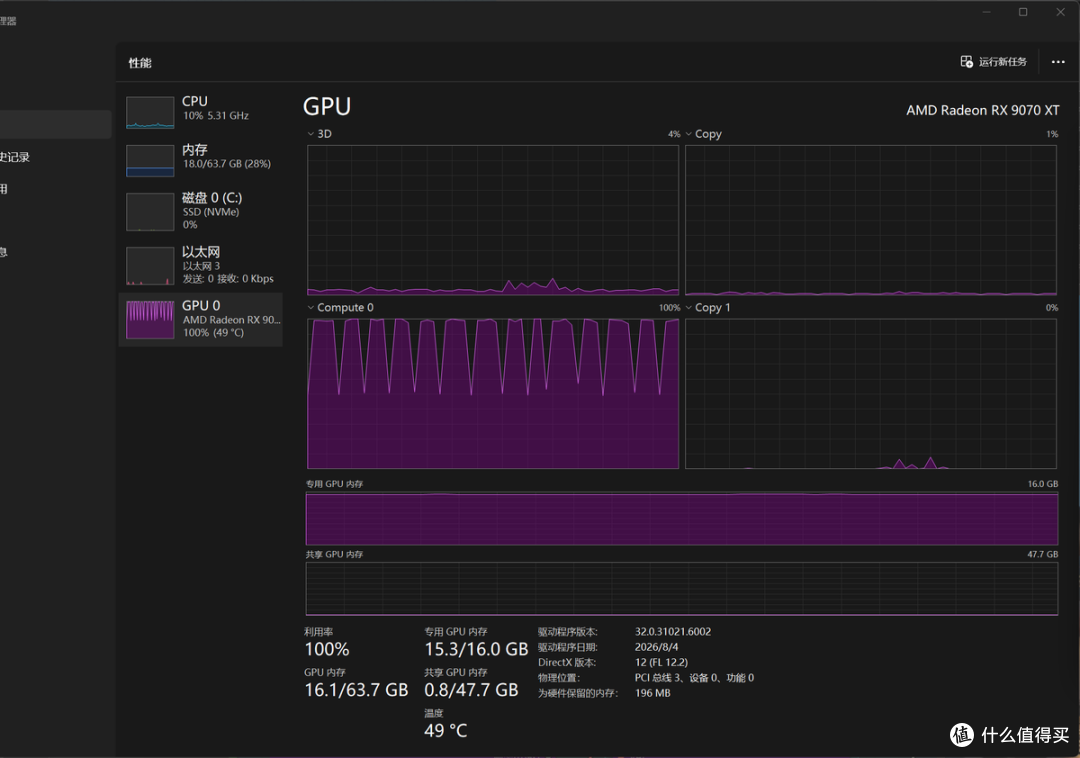
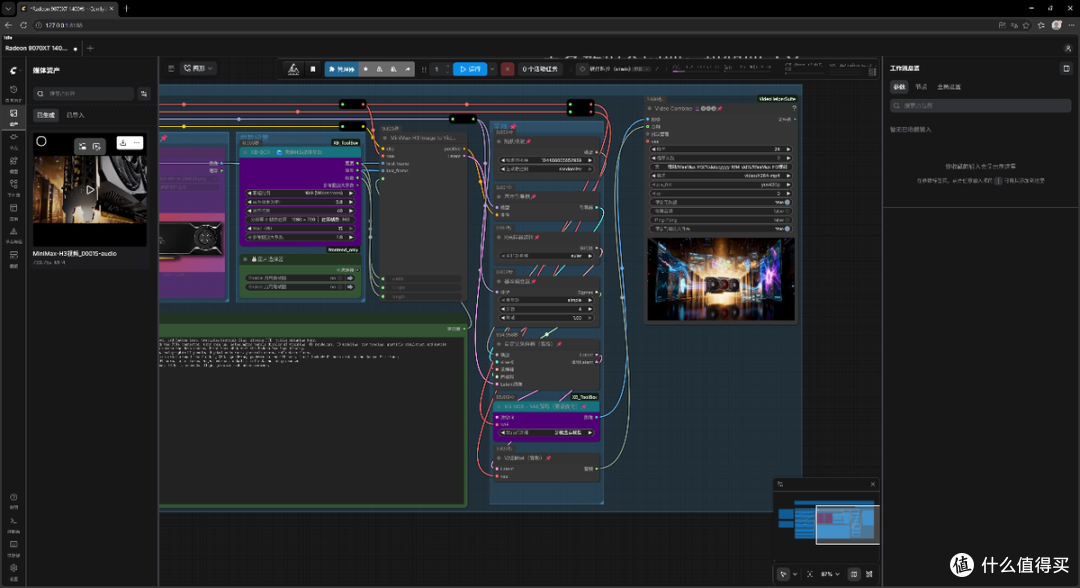
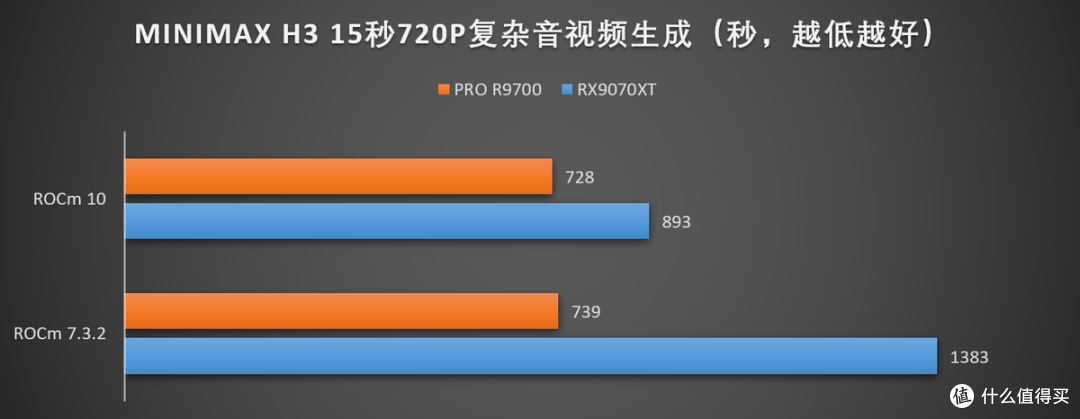
但是5秒视频的可用意义较小,因此我们加大压力,提升到15秒视频,分辨率为1280×720 24fps,并且加入了较多的关键词,生成一段Radeon显卡的特效视频,结果如下:
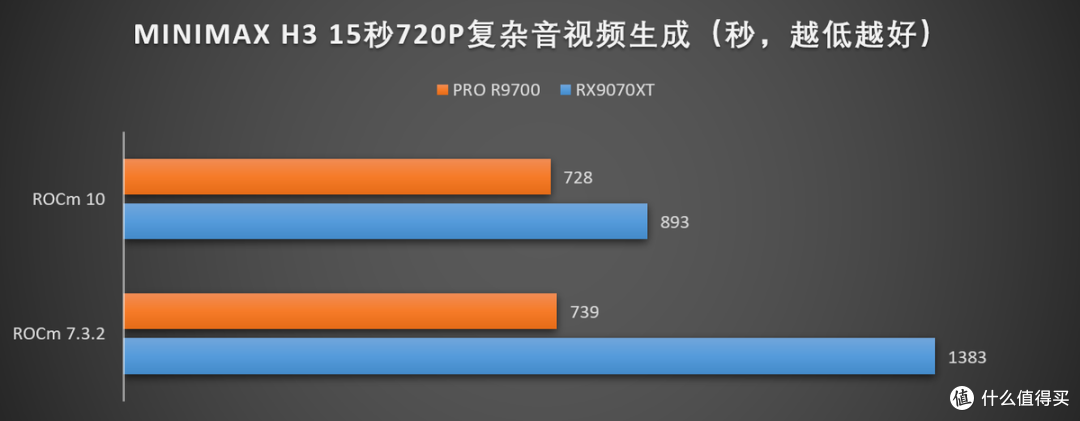
在老版本ROCm 7中,两张卡的差距十分悬殊,RX9070XT需要用到R9700近两倍时间才能生成,不过到了ROCm 10中,RX9070XT的性能提升极为显著,一下缩短了近一半,用时893秒,不过更大显存的R9700也有一些提升,达到了728秒,依然比RX9070XT强20%以上,由于视频生成是需要连续加多段“抽卡”的,这20%性能差距在实际生产中会节约大量时间及电力,进而降低总体成本。
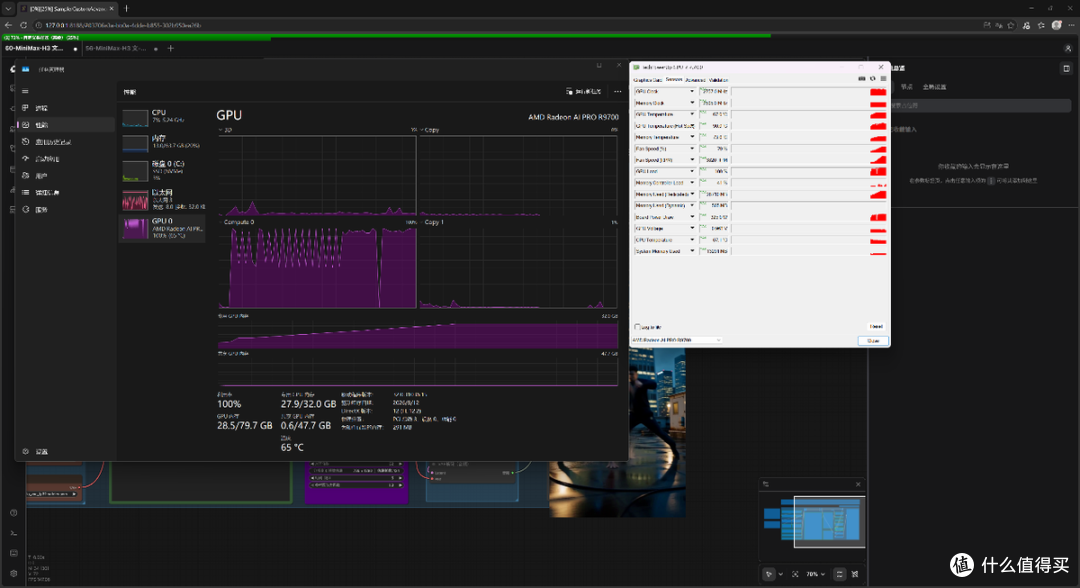
这里可以看到,拥有32GB大显存的Radeon AI PRO R9700在AI视频生成上,相比消费级显卡还是有相当大的优势的,可以开启高显存模式,尽可能的把更多数据一次加载到显存中,减少数据交换损失,同时显存占用曲线比较平滑,也没有过多占用内存,效率较高。
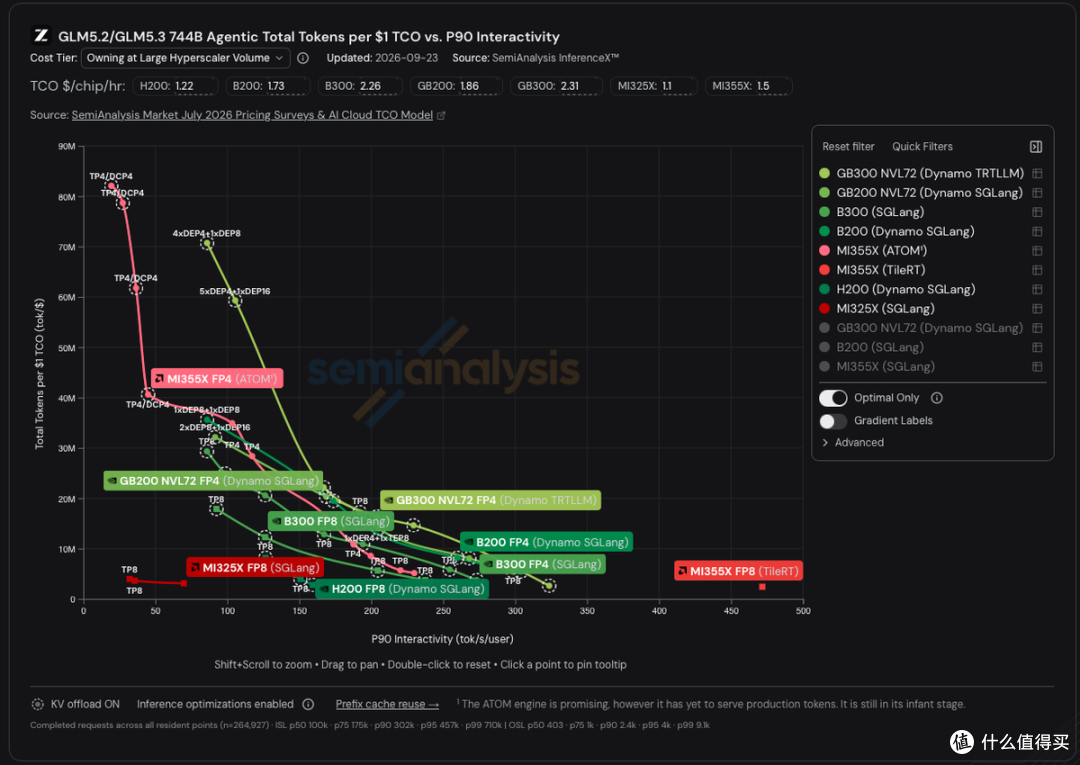
从ROCm for linux到ROCm for Windows,再到ROCm 10,一个版本的变化就可以有至高超过50%的性能提升,我们看到AMD在AI开发环境上的进步是相当大的——前两天更是有通过AMD与开发者的共同努力,将MI355X的LLM性能优化到超过B300的劲爆新闻,标志着AMD在AI领域又拿下一个第一!
总结
在当前“显存决定算力上限”的专业显卡市场,万元出头的AMD Radeon AI PRO 9700 32GB在AI模型部署使用方面,是一个综合性价比突出的务实选择。
依托越来越发强大的ROCm软件栈,该卡可流畅支撑本地大语言模型部署与AI视频生成工作流,ComfyUI等主流节点式AI生成工具已实现原生适配,搭配MultiGPU插件还可完成双卡显存池化与智能任务调度,充分释放双卡64GB显存的聚合算力,保障高负载长视频、高分辨率视频生成的稳定性与连贯性;在专业渲染领域,该卡凭借对Vulkan API的深度优化,在Enscape等主流建筑实时渲染软件中表现优于同级竞品;32GB大容量显存也精准匹配Chaos Vantage等高显存需求渲染器的运行要求,为建筑设计、三维可视化场景提供了高成本效益的算力方案。
AMD Radeon AI PRO 9700 32GB依托AMD PRO专业驱动生态与工业级硬件设计,可保障工作站场景下7×24小时稳定运行与全品类专业软件适配,既打破了传统专业卡的高溢价门槛,也弥补了消费级显卡在专业场景下的显存容量与稳定性短板,精准覆盖中小型工作室、个人创作者与 AI 开发者的核心算力需求,是当前本地AI模型部署用显卡市场中综合性价比突出的务实之选。
作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~






校验提示文案
校验提示文案