Mellum 2.1 vs Qwen 3.5-9B:本地代码模型怎么选?实测对比给你答案
09:08
精选参考来源


精选参考来源
1. qwen3.5-9b 本地部署实测:从量化选型到推理框架与场景落地-CSDN博客

CSDN博客 2026-09-27 00:00:00
2. 前沿在线的微博

新浪微博 2026-10-09 00:00:00
3. 前沿在线的微博
新浪微博 2026-10-09 00:00:00
4. JetBrains ships Mellum2.1: 12B MoE (2.5B active) open coding-agent model, SWE-bench Verified jumps 2.0→47.0 — AICoder
2026-10-09 00:00:00
5. JetBrains 开源 Mellum2,尝试 Claude Code 无法涉足的领域 - InfoQ
InfoQ 2026-06-18 00:00:00
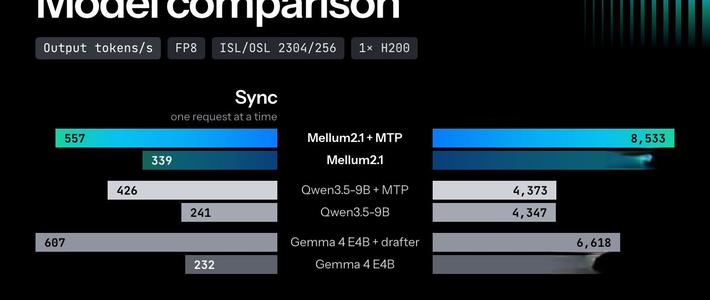
6. JetBrains 编程 AI 模型 Mellum2.1 发布:高负载推理吞吐量近 Qwen3.5-9B 两倍 - IT之家
IT之家 2026-10-09 00:00:00
7. 9B模型也能强推理?Qwythos本地部署实力惊艳

今日头条 2026-10-03 00:00:00
8. 开源决策模型Clef.Jev 之后,Cloudflare 也发布了自己的决策模型 Clef 和 Clef-flash。两款都在 Qwen 上加了 joint schema head,把整份 schema 的候选项联合打分,权重按 Apache 2.0 开放。 实现上比较有意思的是字段之间的交互。这个 head 先为各个候选项提取相关证据,再让不同字段相互关注,并回看原始输入。字段之间的关系进入同一轮计算,Qwen 只跑 prefill,不生成中间文本。 Clef 基于 Qwen3.8-27B,Flash 基于 Qwen3.5-9B,都保留了视觉输入能力。训练时冻结主模型,联合优化 schema head 和 LoRA。官方用内部合成数据做后训练,发布包包含权重和推理代码,没有附训练数据。 独立横评里,JevBench v1.5.5 在文本任务上测了 1,624 次决策,包含公开题和封存题。Intelligence 这一项,Jev 1.13.0 是 72.0,Clef 是 67.9,Flash 是 53.1。Clef 在这组任务上还没追平 Jev,Flash 和完整版的差距也不小。这组数字只对应能力分,总榜还计入了概率校准、延迟和成本。 两款都能通过 Workers AI 调用,也可以自行部署。模型卡给了 Jev / SystemOne API 的调用方式,已有这套 schema 的项目可以据此接入。对已经在用 Jev 的开发者来说,现在多了一组可以拿自己的任务做对照、也能自己部署的权重。 #AI #Cloudflare #Clef #决策模型 #jev
抖音 2026-10-03 00:00:00
9. B站把字幕翻译模型整包开源,覆盖150种语言
今日头条 2026-10-06 00:00:00
10. Qwen3.5-9B社区版实测:GGUF量化、MTP加速与部署指南-CSDN博客
CSDN博客 2026-09-25 00:00:00
11. Qwen3.5-9B社区微调版实测:GGUF量化、MTP与本地部署全解析-CSDN博客
CSDN博客 2026-09-25 00:00:00
12. 专打 Claude Code 痛点!JetBrains 开源 12B 代码大模型 Mellum2:主推本地私有化与高并发速度
21CTO 2026-08-03 00:00:00
13. Mellum2-12B-A2.5B-Instruct vs 竞争对手:10个关键性能基准测试深度解析-CSDN博客
CSDN博客 2026-06-04 00:00:00
14. 机器人能力榜头部换血,世界-动作模型正在改写具身智能的选型标尺|2026年10月10日_机器人_zplus1-DAMO开发者矩阵
DAMO开发者矩阵 2026-10-10 00:00:00
15. 实战经验帖:本地跑 Qwen3.5 踩过的坑-腾讯云开发者社区-腾讯云
腾讯云 2026-09-11 00:00:00
16. qwen3.5-9b本地部署实测:9B模型编程能力与推理速度全解析-CSDN博客
CSDN博客 2026-09-27 00:00:00
17. qwen3.5-9b本地实测:推理性能、量化收益与部署避坑指南-CSDN博客
CSDN博客 2026-09-27 00:00:00
18. #AI编程工具的未来发展方向是什么# AI编程工具的未来真的不是停留在代码补全的小打小闹了,完全是往全链路智能伙伴的方向狂奔。 就拿阿里刚出的Qwen3.5来说,原生多模态训练的底子,不用外挂视觉模块,直接把你随手画的UI草图转成能用的前端代码,连设计转开发的中间沟通成本都直接砍没了。它在SWE-bench真实软件工程基准里通过率能到76.4%,四分之三的GitHub真实Issue它都能自己读、自己写修复补丁,能力早就跳出单行补全的局限,从需求分析到部署调试全链路都能兜住。 到2026年甚至能分化出两种成熟玩法,规范派把规则定死让AI严格执行,做金融系统、老代码重构这类零容错的活稳得一批;灵活派直接用文字、草图甩需求,半天就能跑出可交互demo。智能代理模式下开发周期能直接缩40%-60%,以前30人干18个月的项目,现在6个人3个多月就能搞定,真的把编程从技术专属变成了普通人也能上手的普惠能力。
今日头条 2026-10-04 00:00:00
19. 【颠覆认知!DeepSeek Harness 加持 Qwen3.5 9B!9B 也能打!】 今天测以下 Workbuddy,让它自动部署了 DS Harness 尝鲜。很成功。 但在测试DSH时,没有配置任何外部 LLM API,直接本地拉起 Qwen3.5 9B 接入。本来只是简单测试 DSH 好不好用,没想到被这个 9B 小模型狠狠惊艳到。 模型做事条理清晰,任务规划安排都很妥当。唯一短板就是本地推理速度偏慢,其余表现都相当像样,之前居然没发现这套组合这么强。 多轮测试观察下来,整套流畅调度靠的就是 DS Harness 内置插件机制。 做 Agent 真的不能只盯着模型本身,底座的任务分配调度能力同样至关重要。 最意外的亮点:这个 9B 小模型,还**自动写出适配 DS Harness 的代码,生成了一整套配套插件**。 中小模型搭配专业 Agent 底座,潜力远超想象。本地离线运行,数据不出本机,适合喜欢折腾本地 AI 的玩家。后面再多测复杂任务,看看它的上限在哪。 #标签 #DSHarness #Qwen3.5 #本地大模型 #AIAgent #开源 AI #本地部署
今日头条 2026-10-05 00:00:00
20. 说实话,qwen3.8-max 和 glm-5.3 我用 35 道编程题测了——价格差将近 4.7 倍,有一类带函数调用链的 TypeScript 任务,结果和两家官方宣传完全反过来

知乎 2026-10-06 00:00:00
21. 9B模型也能强推理?Qwythos本地部署实力惊艳
今日头条 2026-10-03 00:00:00
22. B站把字幕翻译模型整包开源,覆盖150种语言
今日头条 2026-10-06 00:00:00
23. JetBrains ships Mellum2.1: 12B MoE (2.5B active) open coding-agent model, SWE-bench Verified jumps 2.0→47.0 — AICoder
2026-10-09 00:00:00
24. qwen3.5-9b-编程能力实测_qwen 9b-CSDN博客
CSDN博客 2026-09-21 00:00:00
25. Qwen 3.5-9B实测:Claude的有力替代,但跨文件重构仍存短板
搜狐 2026-09-15 00:00:00






已收藏
去我的收藏夹