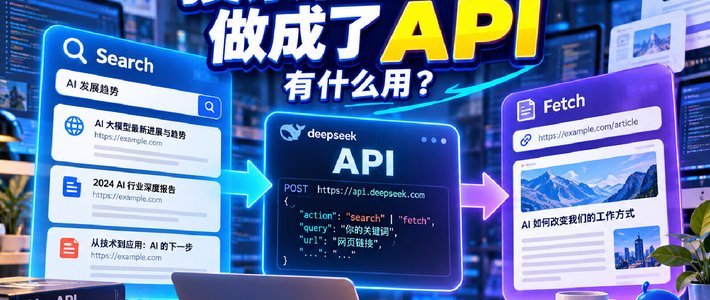
10月17日,DeepSeek把自研搜索引擎做成了两个可以单独调用的API——Search负责按关键词找网页,Fetch负责读取指定网页正文——并随V4.1-Flash-1017模型更新一并上线,开发者通过几行代码调用接口,就能给AI应用补上网能力。对开发者来说,这是把“AI自己上网查资料”接进自己程序的最便宜入口之一:官方定价每1000次成功请求5元,约为海外同类服务的十分之一,11月1日起正式收费,此前限时免费;请求失败、搜无结果、超时都不计费。但要真正“一键生成高质量报告”,接口只是第一步:上线第三天就有开发者做了63道实测题,结论相当清醒——正文抓取对国内多个主流内容平台是盲区,报告质量还得靠工作流自己兜底。21世纪经济报道36氪知乎
先分清两个接口:一个找资料,一个读正文
Search接口接收查询词,返回标题、链接、摘要等结构化结果;Fetch接口读取单个网页,返回该页的标题和Markdown格式正文,方便程序和模型继续处理。Search有个容易忽略的开关:可以通过need_content参数让搜索结果直接带回正文,Fetch则适合按指定网址读取——正文选项默认关闭,即使打开,也可能拿不到可用正文。限速规则要提前规划:Search和Fetch按账号分别限5 QPS,两个接口额度互不占用,与模型并发限制相互独立,超限返回HTTP 429;Fetch除账号级限制外,还针对目标域名另设限流。知乎小红书知乎
接入只要几行代码,难点在工作流怎么排
接入本身很轻:在DeepSeek开放平台注册后创建API key(密钥只在创建时完整显示一次),用curl或SDK向两个tools接口发POST请求即可,与主API共用一套Bearer鉴权。更大的省力来自另一条路径:在DeepSeek Harness、Claude Code、Codex等编程智能体里使用DeepSeek API时,模型判断需要联网就会由服务端自动调用这两个接口,开发者一行爬虫代码都不用写——这部分调用目前尚未收费,北京时间11月1日00:00起按次收费。36氪知乎
报告类任务的合理流水线是:把选题拆成若干查询词,先Search拿候选来源,再看现有内容够不够——已经拿到所需正文就不必机械地对每条结果再Fetch一遍,有明确网址或需要补读时再按需抓取。拿到资料后逐条核对出处、日期和版本,最后把清洗过的Markdown交给模型成稿。要警惕“结果多就等于证据多”:一条原始发布说明加上三篇转述它的文章,是四个URL、一份证据;“HTTP 200”“有结果卡”“拿到正文”“原段支持结论”是四种不同状态,报告必须建在第四种上。小红书知乎
上线首周的实测,暴露了四个坑
知乎用户“平凡”在10月18日用63个易受垃圾站和SEO干扰的问题做了开源实测,数据全部可查;他特别说明,这次未对比Google、Bing等其他商业搜索引擎,结论仅针对该API本身。四个发现对写报告有直接影响。知乎
过滤要自己做,权威度分不会替你排掉垃圾。实测中人工判为垃圾/灰产的21条结果authority得分都没超过2分,而官方机构与学术百科的平均分在3.4左右;但排序主要取决于相关性分,权威度对排位影响有限,低分站点仍会被默认返回——经验值是以authority≥2为阈值在RAG流程里自行过滤,可以滤掉六成以上黑灰产站点。知乎
防得住山寨站,防不住“借高权重的软文”。官方介绍称针对SEO作弊、GEO操纵和低质AIGC会通过识别机制过滤,但实测发现PyPI上一个第三方引流页面直接继承了该域名的4分高分,面向大模型特征编写的推广文章与真实行业报告在检索层很难划界。做选型或方案调研类报告时,多篇“相互印证”实则同源的商业软文最容易把结论带偏,需要追溯首发来源再采信。知乎
内容覆盖有明确盲区,别把“搜不到”当成“没有”。微信公众号和小红书的内容目前检索不到(加site:限定同样为空),知乎能搜到链接但正文无法通过Fetch抓取,微博和今日头条则可搜可抓;报告若依赖这些生态的信息,得另配获取渠道并把这个限制写进流程。
结果会跟着出口IP变。同一批问题在英国IP和国内IP下,前10条结果的域名重合度平均仅0.58,金融类仅0.39——用海外服务器给国内用户做检索应用时,建议显式传入localization本地化参数,否则同一句查询会在不同机器上产出不同的“事实”。知乎
11月1日前跑通流程,再把账算清
单次成功请求合0.005元;Search和Fetch分别计价,返回条数不影响单笔价格,而模型读资料、写报告的费用另按所用模型计费,通常在报告总成本里占大头——跑一份报告前,先估算“搜几次、抓几页”再上量更稳妥。可靠性是另一本账:10月20日上午DeepSeek服务异常约5小时才恢复,媒体统计这已是年内第18次宕机,官方在恢复通知中提到将全面梳理并剥离单点依赖。把报告管线投产的团队,应准备重试与降级策略——比如抓取失败时退回搜索摘要、标注证据不完整——而不是让单点服务异常直接打断交付。知乎
至于“索引全球千亿级网页、稳定处理每天数亿次搜索请求”等性能描述,属于官方披露,检索质量仍建议以自己场景的小样本实测为准。对开发者而言,这次更新的实质是:联网能力第一次以几乎可忽略的价格成为模型API的“标配水电”,趁11月1日计费前把“搜索—择需抓取—核证据—成稿”的流水线搭好,报告的质量差距就从“能不能搜到”变成了“会不会核验”。知乎