九月,对"第二大脑"玩家来说是个值得记住的月份。
第一批搭第二大脑的人还在整理仓库,但最近几周发生的好几件事串在一起,指向了一个全新的共同问题——竞赛正在从"存资料"转向"记住你"。
三件事,一个风向
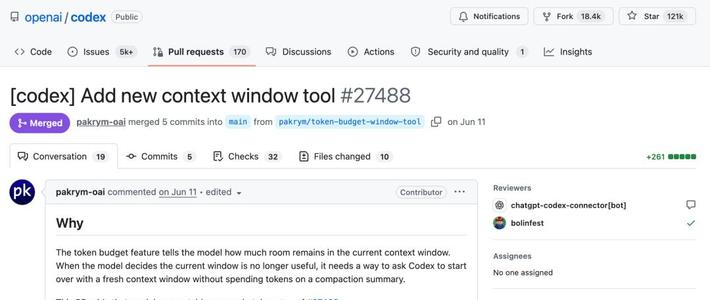
第一件:Codex 的记忆系统被悄悄改了。 Codex CLI 放弃了用了多年的 compaction(压缩)机制——以前 token 快用完就把对话压成一段 summary 继续跑;现在转向 token budget(token 预算)+ 硬性上下文切换:模型自己知道还剩多少额度,到点了主动换窗口,而历史完整保留在 history 和 notes 里,随时可搜可读。 36氪同期跟进时也提到,Codex 在代码库上新了一款 _context 工具,“它可以让Agent放弃反复压缩上下文,转向了解自己还剩多少上下文空间”。 新方案的核心思路一句话:换一个窗口,但不失忆。知乎36氪
第二件:ChatGPT 在给你建"心理档案"。 九月初一篇《ChatGPT正构建用户心理档案,建议自查》的小红书笔记被大量收藏,评论区流传的自查提问被翻译成 12 条全网转发:打开档案、看它记住了你什么、又根据你的行为推断出了什么。 往前数,六月份量子位就报道过 ChatGPT 记忆系统大升级、向部分地区的 Plus 和 Pro 用户推送; 再往前,五月传出"九月要用摘要代替已保存的记忆"时,评论区最高赞是一串"不要啊"——理由不是模型能力,是记忆本身:“就是因为记忆系统才一直没搬”。小红书量子位小红书
第三件:“删掉"不等于"忘了”。 九月流传的 MobileMem 基准测试结果给所有 AI 用户提了醒:你以为关掉开关就安全了?其实删单条≠模型没学过。 留痕比你想的深,删除比你想的难。小红书
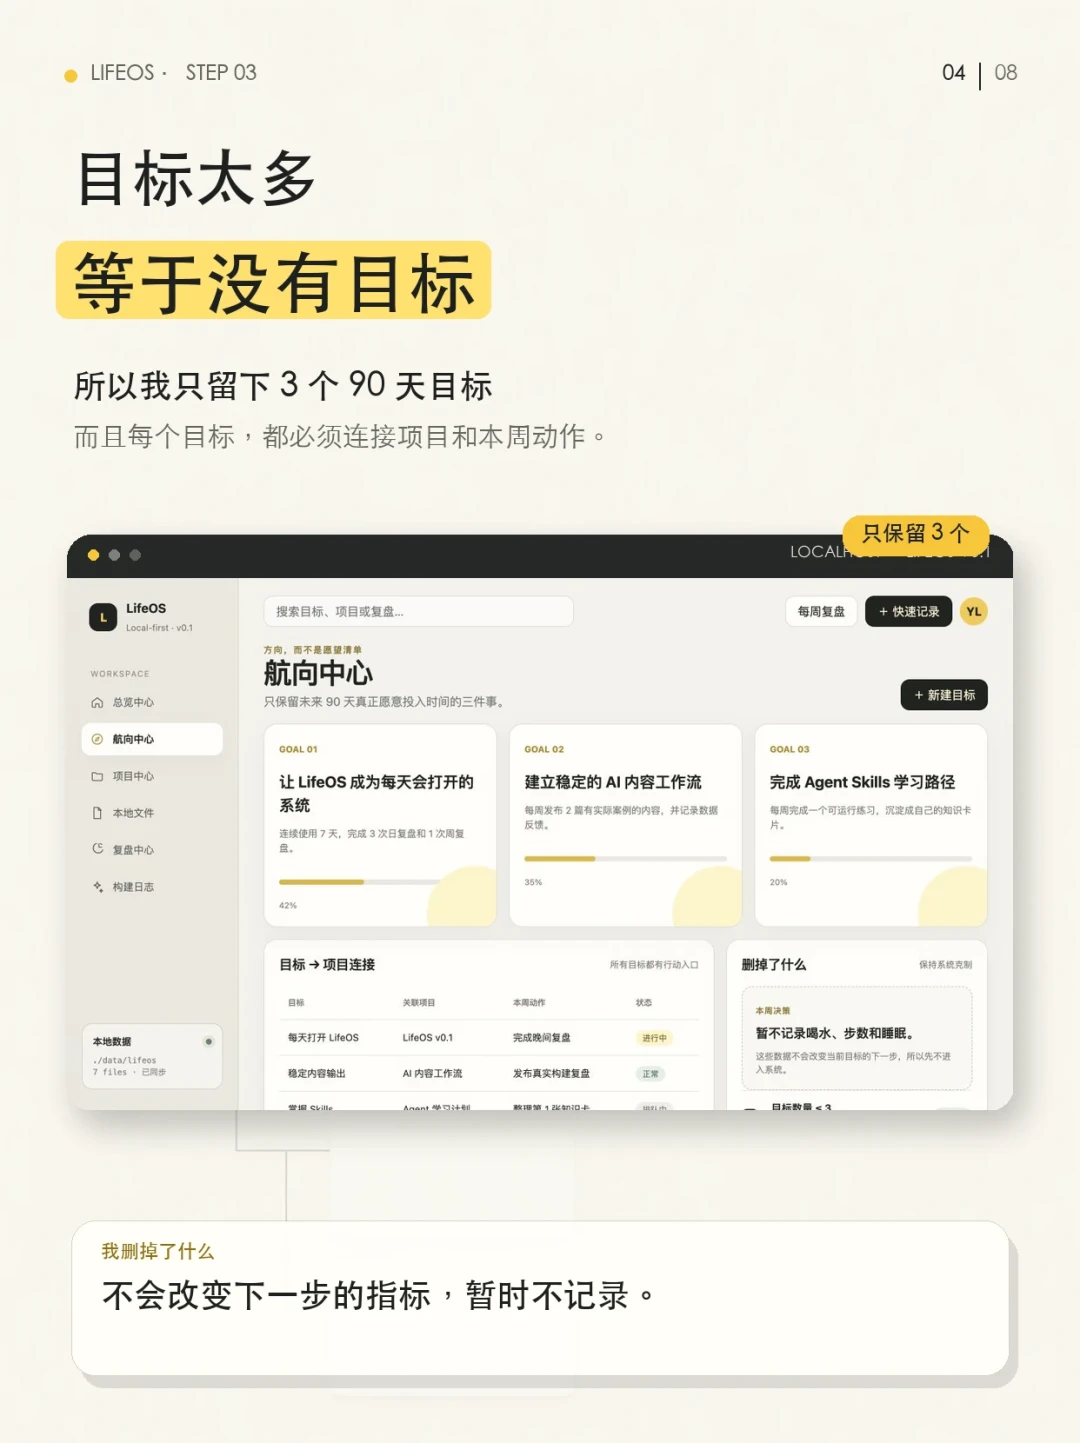
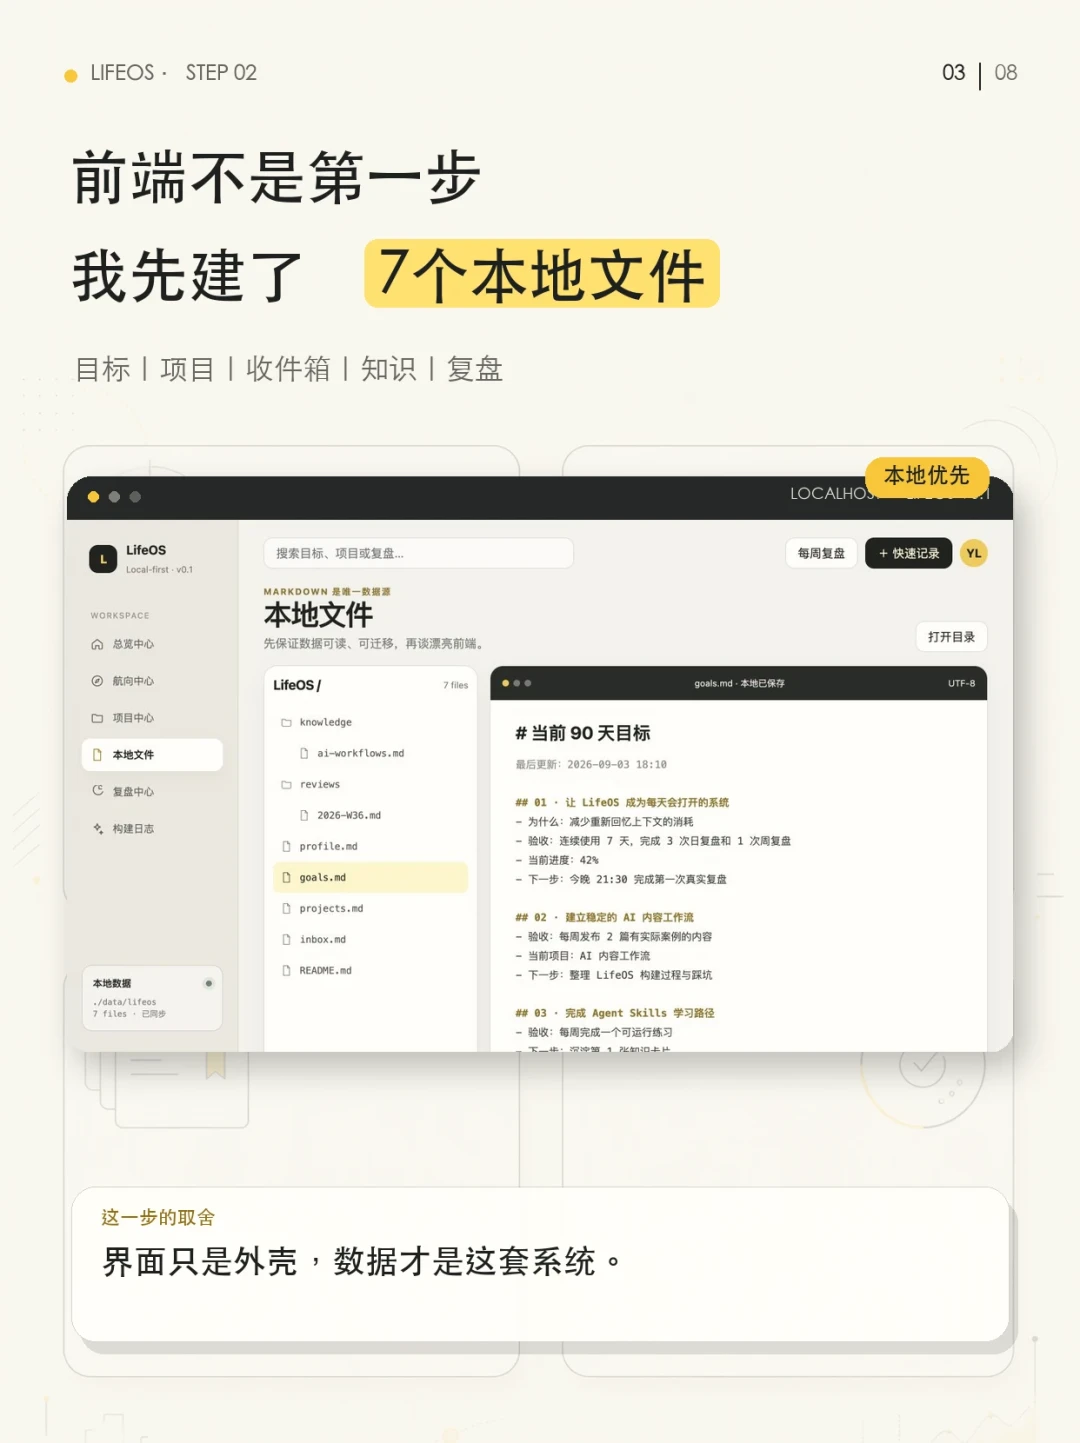
还有普通用户的现场。九月初开始,“把 Codex 变成第二大脑"的话题在小红书集中出现,被叫做 LifeOS 的玩法把第二大脑从一个"存笔记的仓库”,变成了"记住你的目标、任务与复盘"的 agent——热门笔记给的最小版本只有 5 个文件:goals.md、projects.md、inbox.md、knowledge、reviews,先连续用 7 天再考虑加功能。小红书
四件事摆在一起,风向很清楚:第一代焦虑是"存不下、找不到",第二代焦虑是"它会忘记我"。 厂商们比谁都清楚这件事的分量——模型本身早已没有护城河,微博上#AI大模型没有护城河#的话题里,用户自己就说了:真正不可复制的护城河,是日积月累沉淀下来的专属数据、私人交互记忆与亲手搭建的数字内容。 他们抢的不是功能,是让你"换不起"。微博
先搞懂:AI 卖的"记忆",其实是三种东西
这是单个帖子讲不清、但最值得整理的部分——因为你的迁移损失,完全取决于你的记忆存在哪一类里。
第一类,云端档案型(ChatGPT 增强记忆、各类 App 的长期记忆)。平台自动把你总结成"它认为的你"。体验最顺,但你权利最少:条目在它的库里,导出支持有限——有开发者整理过,部分产品提供记忆导出功能,可以把记忆条目导出后在其他平台导入,但档案里的对话痕迹基本带不走; 而 MobileMem 已经证明,想彻底删也未必删得干净。难带走,也难删净,是一把双刃剑。知乎
第二类,会话摘要型(传统 compaction 机制)。这就是"越用越笨"体感的根源:一段 10 轮的调试对话被压成三句话,丢掉的恰恰是关键上下文。Codex 这次改版的实质,就是厂商自己承认了这条路走不通——压缩是有损的,算法再好,丢掉的就是丢掉了。
第三类,明文文件型(Codex 新机制里的 history/notes、LifeOS 的五个文件、Obsidian 加本地 AI)。记忆以你能打开、能读、能搜、能复制的文件形式存在。技术圈讨论记忆系统时常用的 MemOS 分层框架正好解释了这一点:参数记忆进入模型权重,激活记忆存在于推理过程,明文记忆则保存在模型外部—— 只有保存在模型外部的那部分,才可能跟着你走。知乎
一句话总结:前两类,是你在借平台的记忆;第三类,是平台在借你的记忆。
换机账单:你以为"只是换个工具",实际在丢什么
把"换工具的成本"拆开,其实是四笔账:
损失项 | 云端档案型 | 会话摘要型 | 明文文件型 |
|---|---|---|---|
多数留在平台,导出受限 | 已被压缩,找不回 | 取决于你的导出习惯 | |
记忆条目/画像 | 有限支持迁移 | 本来就没有 | 你写的,就是你的 |
对你项目的理解 | 换平台从零重投喂 | 早已失真 | 可整体搬走 |
情绪成本 | 真实存在 | — | 几乎为零 |
第三行最容易被低估。你换了模型,损失的是重新解释背景的两个小时;你换了平台,损失的是半年对话里沉淀下来的那个"懂你的上下文"。小红书那条被疯转的帖子里写得很直白:“我难过的不是少了一个工具,是那个被它慢慢了解的’我’好像消失了。” 这不是矫情,这是第一类用户的真实账单:越用越难换,越难换越不敢换——这正是平台想要的效果。小红书
知乎那个三万多浏览的回答早就给出了判断标准:模型会升级,平台会更换,真正属于你的不是某个 AI 账号,而是那些被整理、连接并反复调用过的经验。知乎
本月行动清单:把"懂你的资产"搬回自己手里
不用等平台把规矩定下来,四步,30 分钟内能做完。
第一步,先自查档案。 用那个火遍全网的自查逻辑:直接让 AI 完整列出它通过历史对话记住的关于你的信息,以及它没被你告知却推断出的内容。过一遍,你才知道它眼中的你是什么样的,也顺手看看哪些敏感信息不该在里面。
第二步,把长期资产蒸馏成明文。 花半小时,把那些你会反复用到、值得留下的东西——你的写作偏好、项目背景、决策原则——从 AI 的记忆面板里抄出来,写进你自己的 markdown 文件。记忆条目可能随平台消失,明文不会。
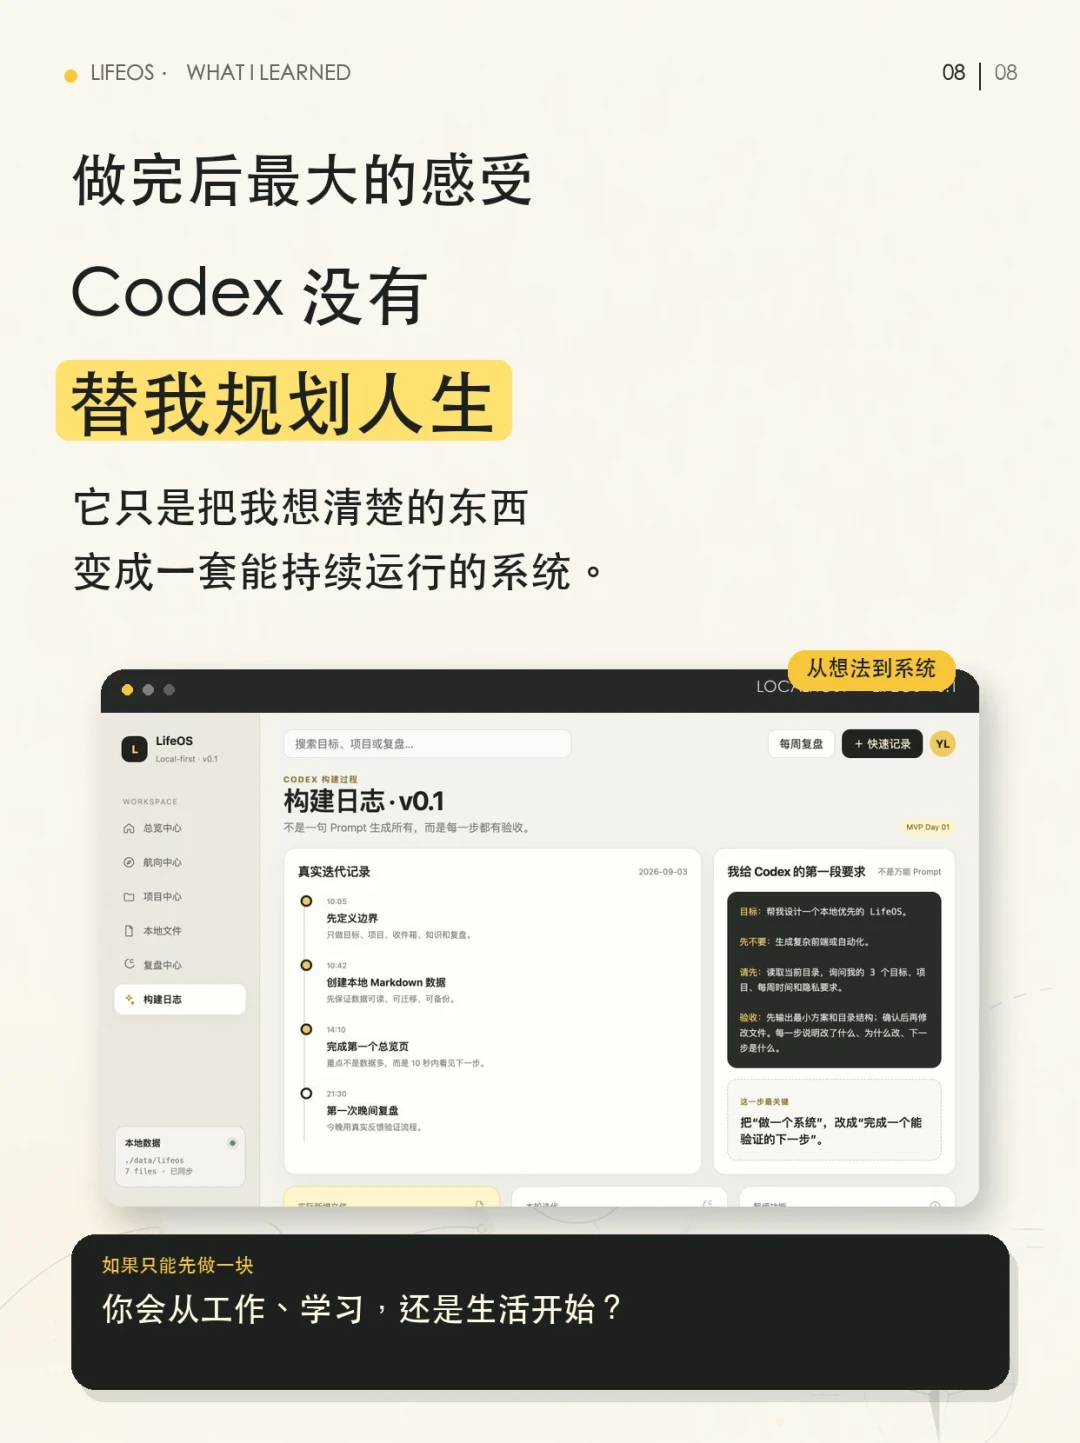
第三步,给所有 agent 类工具加一个"notes 习惯"。 Codex 的新机制其实指了路:让它把工作状态写进持久笔记,让历史变成可查询的文件,而不是一次性的聊天记录。 就算你完全不用 CLI,在普通对话里固定让 AI"把这轮的结论存成备忘",也是同一个动作。知乎
第四步,敏感话题默认临时模式。 既然"删除"和"遗忘"之间存在已被实测证明的落差,就别把不想留痕的内容喂给长期记忆。
接下来盯什么信号
ChatGPT"摘要代替已保存记忆"传闻的正式落地:一旦发生,"因为记忆没搬"的用户会被迫做第一次真正的选择题;
各家产品的记忆导出会不会进一步放开:社区已经为这件事吵了一轮,目前远没有定局;
MobileMem 式基准的发布密度:“AI 记住了你什么、能不能查、能不能删”,正在变成和价格、模型能力并列的选型参数。
第一代第二大脑问的是"知识放在哪",这一代问的是"记忆归谁管"。好消息是,风向正在从"锁住你"转向"尊重可迁移性"——Codex 们开始用文件的思路重做记忆,用户开始自查档案,测评开始量化删除。把这个趋势读明白,再把手里的经验沉淀成自己打得开的文件,你就已经站在了迁移成本最低的那一侧。