今天(9月21日),微博又被"GPT-6攻破哥德巴赫猜想"刷了一轮屏。
同一个话题底下是两种完全相反的声音:一种说"数学领域,人类正在一败涂地,就像十年前的围棋";另一种贴出长文辟谣——这次证的其实是把素数换成刘维尔函数的变体问题,“是有趣进展,但不是’哥德巴赫猜想被解决’,且需等待数学界独立验证”。微博微博
这一幕很眼熟。过去13天,AI数学新闻连着炸:9月8日,OpenAI官宣"攻克"千禧年难题纳维-斯托克斯方程,知乎单个问题播放426万,B站解读视频播放138万。三天后,陶哲轩等25位菲尔兹奖得主联名发公开信抗议。到今天,又轮到哥德巴赫上热搜。知乎专栏
标题一个比一个炸裂,信息却一个比一个混乱。我把这13天里知乎、微博、B站的时间线、数字和双方说法拼了一遍。转发下一条"AI攻克XX"之前,建议先算清三笔账。
一、这13天到底发生了什么:一条完整时间线
8月下旬:数学圈开始流传一个消息——纽约大学柯朗研究所教授 Tristan Buckmaster 和在 Anthropic 工作的数学家 Levent Alpöge,正在攻 NS 方程千禧年难题的"有限时间爆破"方向。两人把 Claude 和 Codex 当"外挂大脑"用,已经证出三维欧拉方程的有限时间爆破,8月22日在 Lean(机器可核验的证明检查器)里验完。
9月5日(周六):OpenAI 那边拿到结果——一个8月28日才开始训练的未公开内部模型,组织约1万个智能体,跑了约88小时。
9月6日(周日):OpenAI 数学负责人 Sébastien Bubeck 急召越洋电话。Alpöge 嗅到雷区拒绝参会。Bubeck 提出的方案,按 Buckmaster 后来的说法是:你们先发欧拉方程成果,第二天 OpenAI 发 NS 结果并隆重致谢;或者由 Buckmaster 牵头重写 OpenAI 的论文。但他补了一句:“要是 Levent 不是 Anthropic 的员工,这事就好办多了。”——潜台词是竞品员工不能沾。通话当场炸锅。知乎
9月7日-8日:两位数学家把论文挂上 arXiv,附了一份4页声明,公开通话内容,包括那句 “Why would you risk your career over this?(你何必为了这事赌上自己的职业前途?)”。几小时后 Bubeck 发长文澄清。
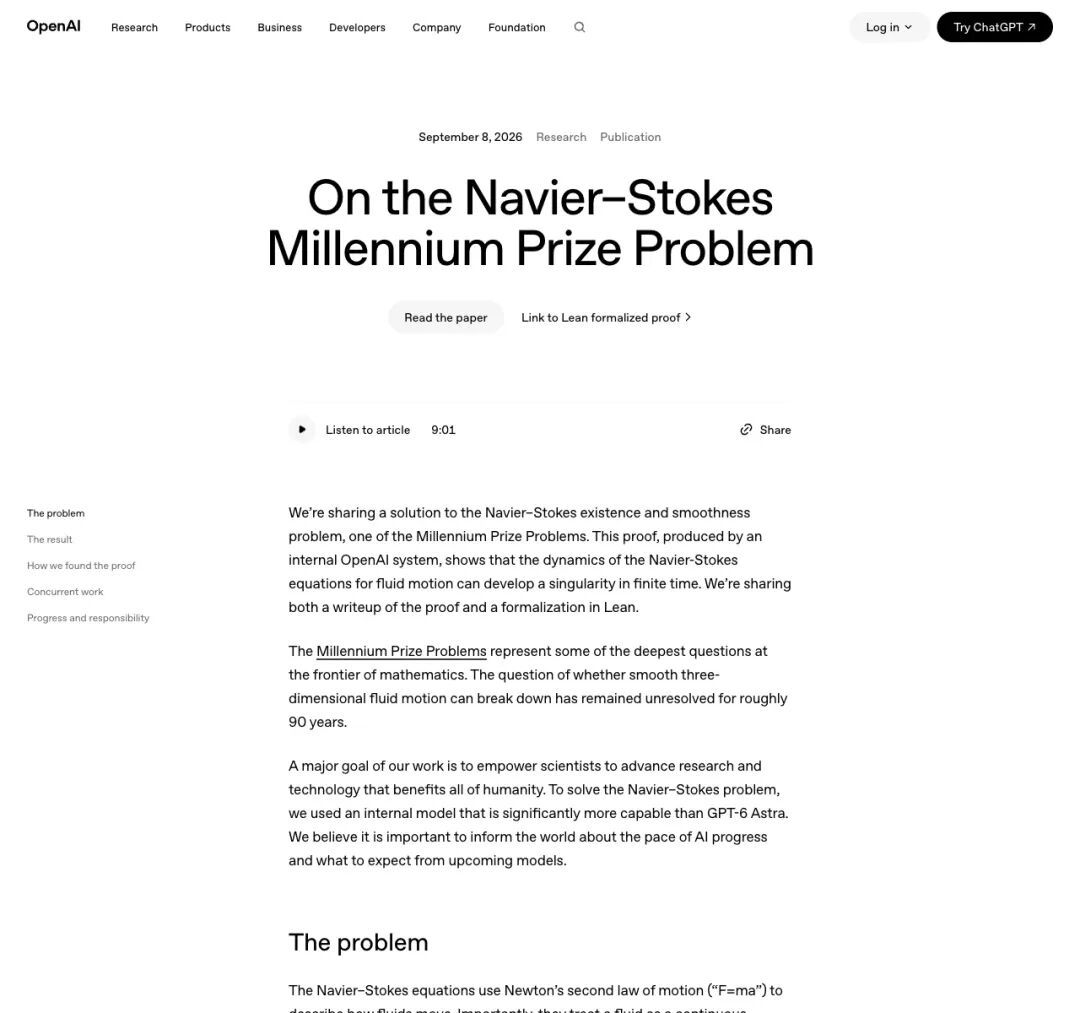
9月8日:OpenAI 正式官宣:内部模型(“明显强于 GPT-6 Astra”)产出166页证明论文 + Lean 形式化代码;全程智能体间交换约270万条消息、消耗约1300亿输出 token,花费数百万美元;不申领克雷研究所那100万美元奖金。知乎专栏
9月10日:OpenAI 发调查声明,确认两位数学家的提示词不可能影响自家系统。但对方最尖锐的那个问题——“我们的 Codex 会话有没有进你们的训练数据”——声明里没有回答。
9月11日:陶哲轩等25位菲尔兹奖得主联署声明《A Severe Misalignment of AI in Mathematics》(AI 在数学中的严重错位),次日传遍全网。
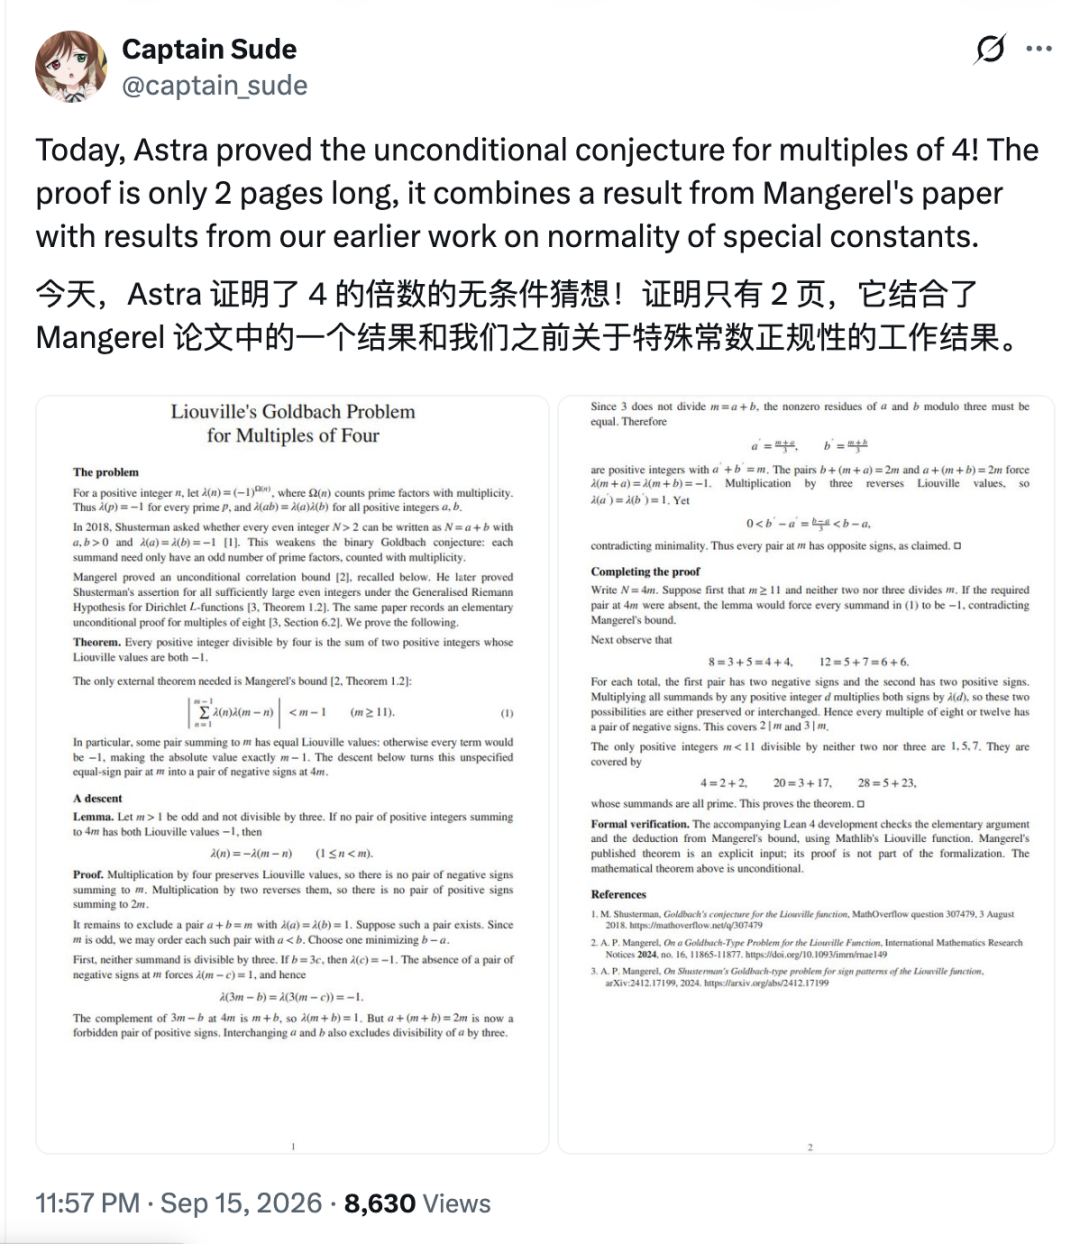
9月21日(今天):X 上一个只有百来个粉丝的匿名账号"Captain Sude"宣称,GPT-6 Astra 无条件证明了刘维尔函数版的类哥德巴赫结果、过了 Lean4 核验,话题爆了,尚无官方确认。更魔幻的是,这个账号9月7日到16日短短8天里流水线般连发6个数学证明,GitHub 上多了12个证明仓库——没有实验室背书,没有高校头衔,论文连署名都没有。夕小瑶科技说
13天,三幕戏:学术八卦、公司公关战、行业公开信,节奏比美剧还快。
二、第一笔账:到底"证"了什么——标题没告诉你的三个细节
细节一:不是"解决了千禧年难题"。 克雷研究所对 NS 问题的官方表述拆成四种情形,OpenAI 攻下的是其中 C、D 方向的"爆破"结果:构造一类光滑外力,让从静止开始的光滑流体在有限时间内局部速度无界(总能量始终有限)。说人话:证明了这类流体方程在特定条件下会"炸"。NS 问题和 P vs NP 是七道千禧年难题里仅有的两道正反方向都给奖的题,所以这条路径完全合规——但"做掉官方表述里的一个方向"和"解决千禧年难题",是两码事。知乎
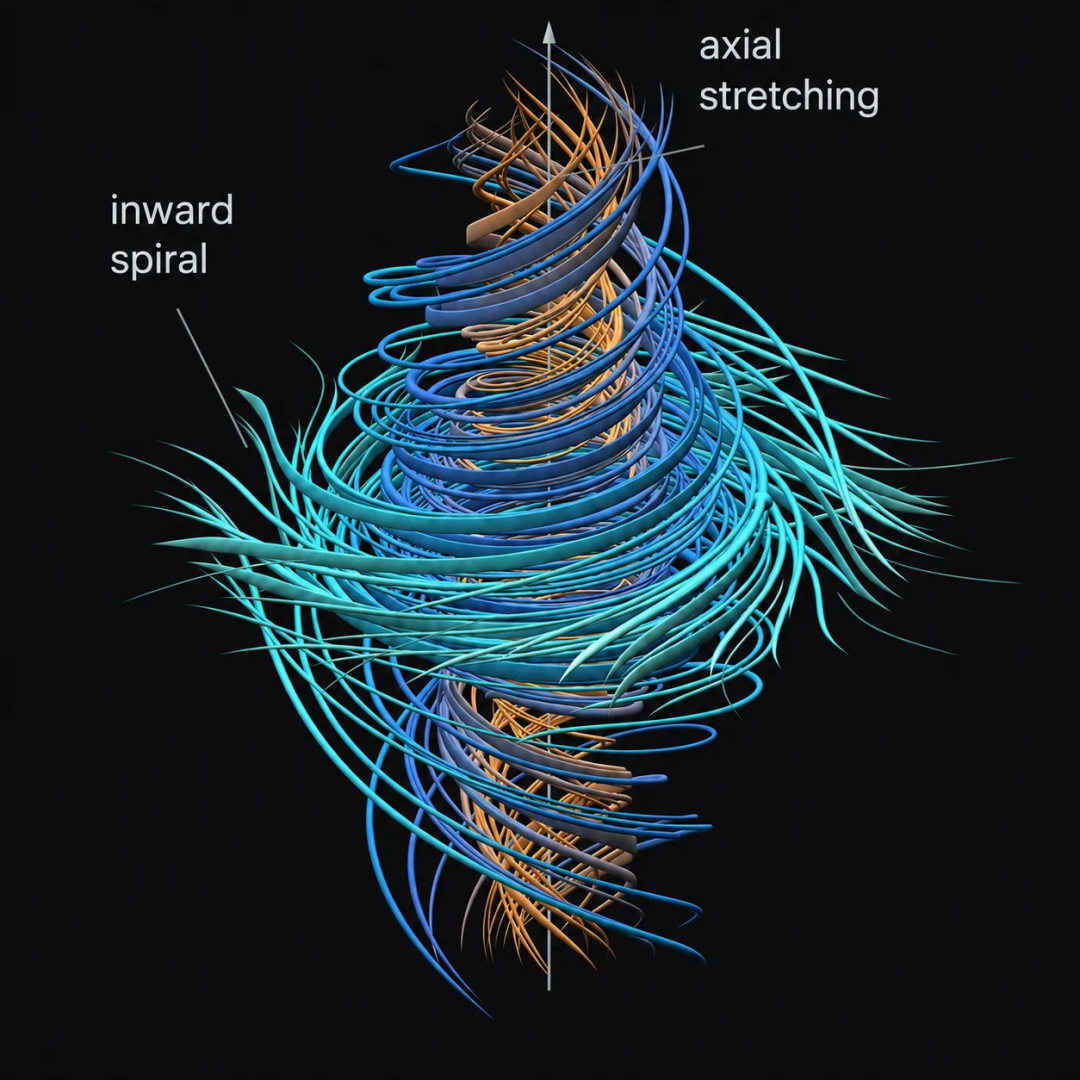
细节二:机器核验管"自洽",不管"对不对题"。 Lean 能逐步检查证明是否成立,但检查不了两件事:形式化出来的命题是否准确覆盖原题、依赖里有没有夹带影响结论的假设。这一步只能人来做。而克雷的认定规则更是"老派"到近乎故意:证明必须在同行评审期刊发表,发表后至少两年被数学界普遍接受。OpenAI 用了88小时,但离"认定"还差至少两年——这道裂缝,正是后面所有争吵的温床。知乎专栏
细节三:优先权之争没有结论,也不该由我们下结论。 双方说法只有一处重合:Bubeck 承认说过"赌上职业前途"那句话,称措辞糟糕、当场收回道歉。署名问题上,Buckmaster 的理解是"要把 Alpöge 移出作者名单",Bubeck 的说法是"讨论的是由 Buckmaster 一作重写 OpenAI 自己的论文"。没有录音,两种定性都无法证伪。OpenAI 坚称"独立推导",两位数学家咬定"路是我们开的"。材料不支持判断谁对谁错,但可以判断一件事:这种冲突以后只会更多。
三、第二笔账:菲尔兹奖得主们到底在气什么——不是"AI不会数学"
公开信最容易被误读的地方在这:签署人根本不是在否认 AI 的数学能力。别忘了 Alpöge 本人就是 Anthropic 的研究员,两位数学家的欧拉方程成果就是人类出直觉、Claude 和 Codex 平推细节做出来的。他们批评的是另一件事——把"解出著名难题"当成模型能力的基准竞赛,会挤压掉数学里解释、整理、确认前人贡献的过程。微博
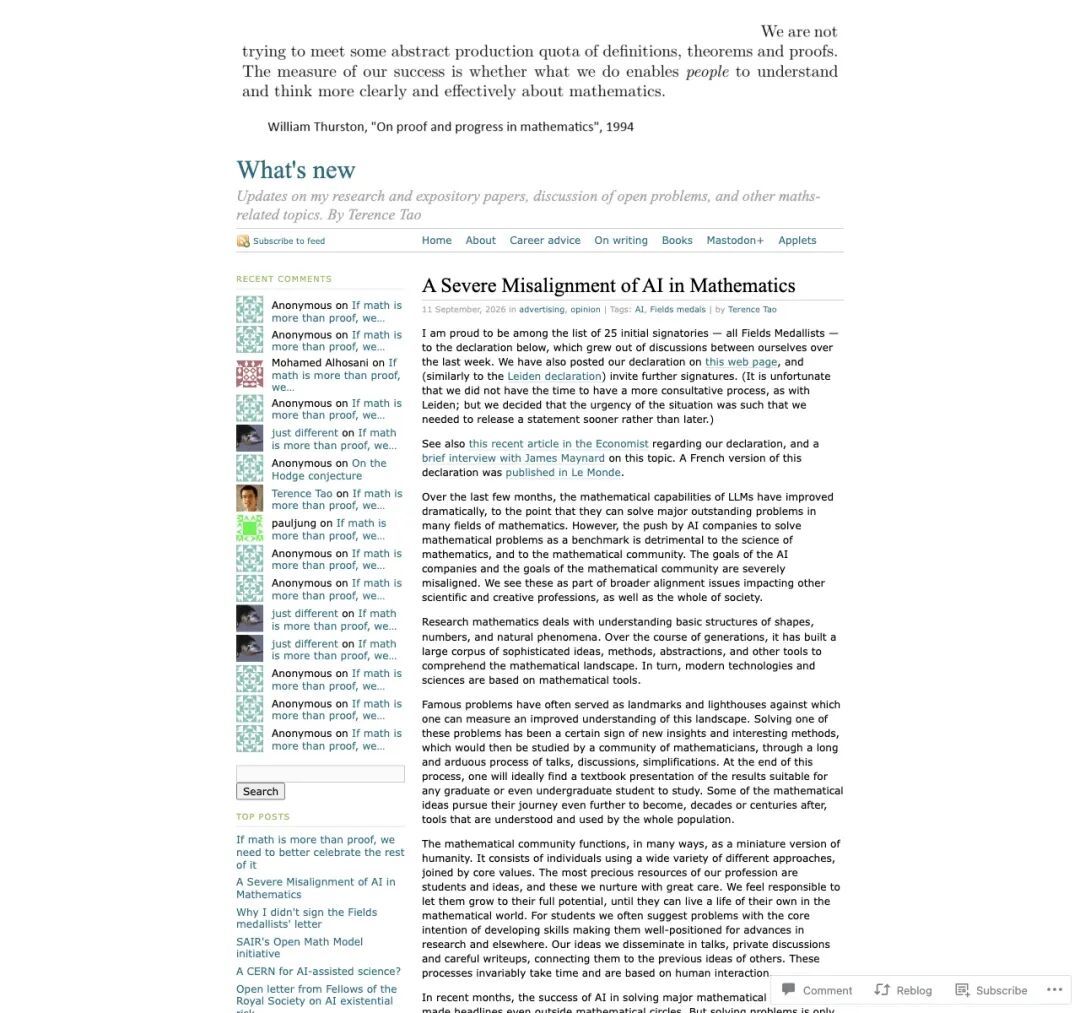
翻译一下:学术界的优先权规则跑的是"月和年",产品发布跑的是"天"。而数学家恰好是唯一能同时被雇来当选手和当裁判的群体——Bubeck 在 OpenAI 领数学,Alpöge 在 Anthropic,Ken Ono 是 Axiom 的创始数学家,陶哲轩是 DeepMind 那篇 AlphaEvolve 数学论文的共同作者,同时还在维护给全行业 AI 数学贡献"判卷"的数据库。两套时钟装在同一批人身上,撞车是迟早的事。
今天哥德巴赫这一出就是最新例证:真实结果是"每个偶数可表为两个刘维尔函数值为 −1 的数之和"——行家眼里漂亮的工作,普通人看到的话题却是"哥德巴赫猜想重大突破",还以为280年的难题一夜解决了。成果与标题之间被压扁的那一层,恰恰就是公开信里说的、正在被挤压的东西。
四、第三笔账:反常识的数字——考试97.6分,真题68道只会2道
如果整件事只记一组数字,记这组:
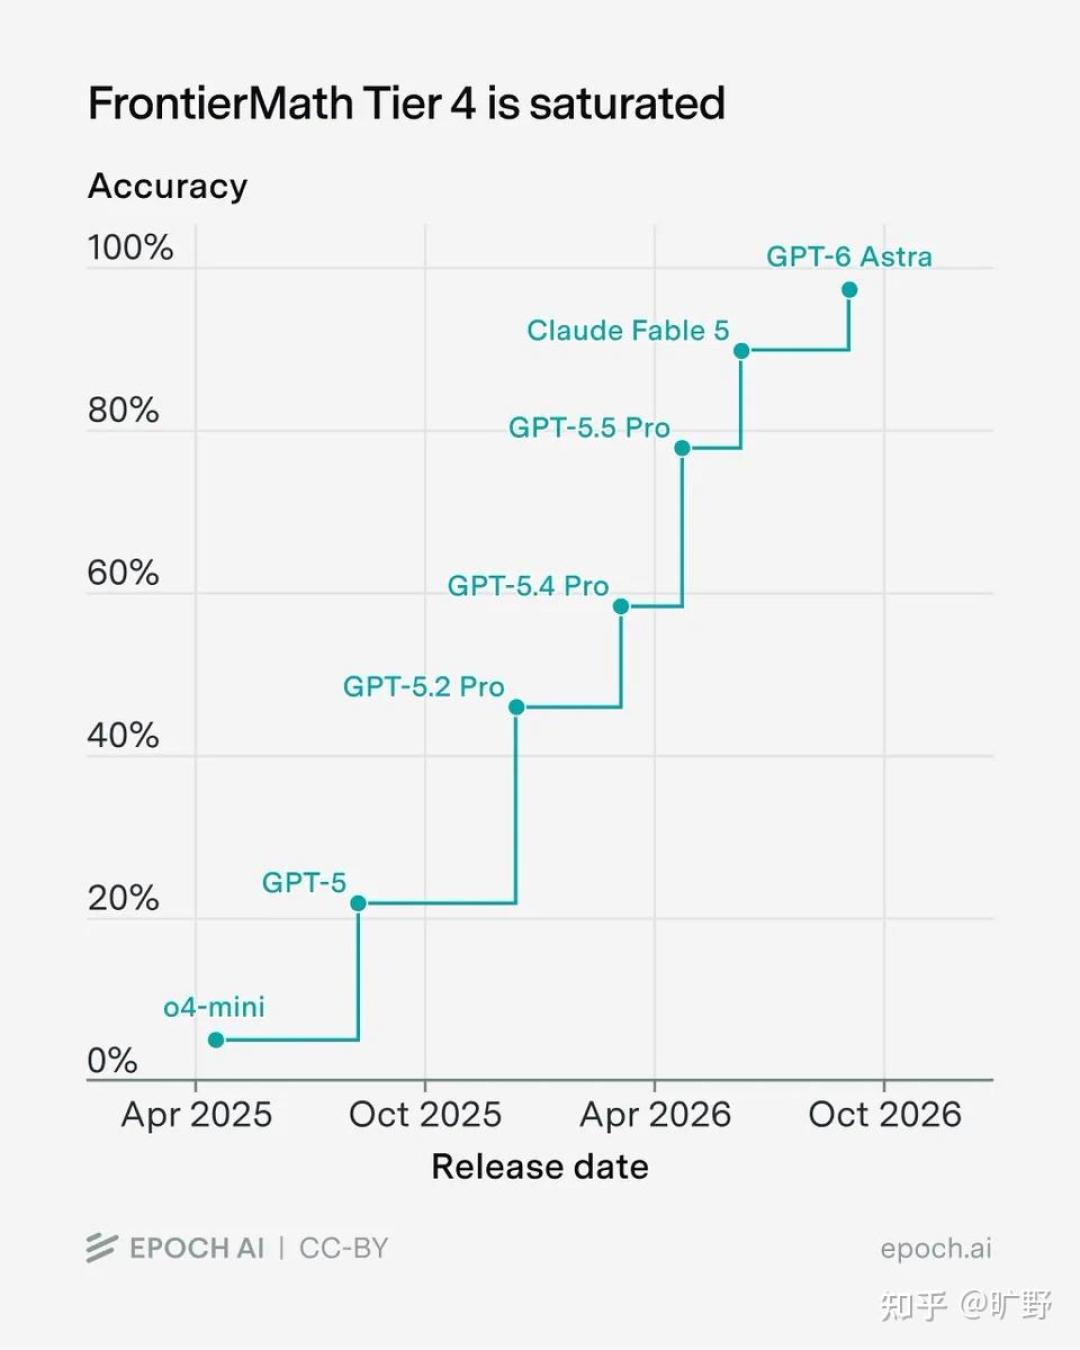
GPT-6 Astra 在 FrontierMath Tier 4 考了 97.6分。这套题2024年11月发布时,当时最好的模型得分不到2%,出题的六十多位数学家里就有菲尔兹奖得主,原话是"够 AI 啃几十年"。9月3日,Epoch AI 官方宣布 Tier 4 饱和:43道题每道都至少被某个模型解出过一次。一年零两个月,啃完了。
同一个模型,在 FrontierMath Erdős(真正的开放问题,要求交出机器可验证的完整证明)上,68道题做出来 2道。知乎
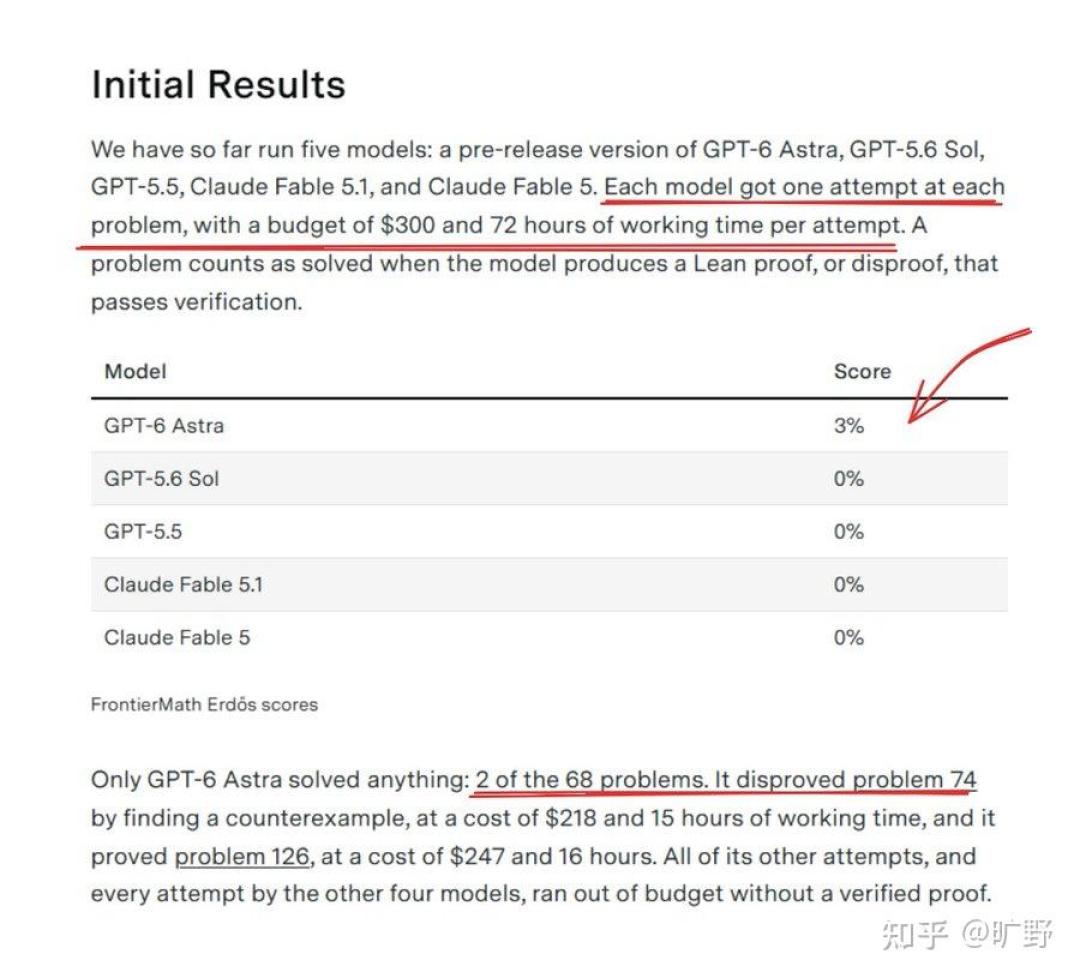
差在哪?前者是考试,答案在出题人手里;后者是无人区。AI 公司现在扎堆攻数学猜想,很大程度是因为考卷用完了。而这波热闹真正的主角不是数学,是判卷机:代码有单元测试,但模型够聪明时会学会糊弄测试;Lean 有一个极小的可信内核,证明要么通过要么不通过,没有部分分、没有"看起来挺有道理",判一次的成本是一次编译。这是人类目前造出的最强判定器,而数学恰好是唯一一门能整门塞进数据中心的科学。
看懂这一层,很多新闻瞬间通了:
Claude 花11天把费马大定理"形式化"成1300万行 Lean 代码、29500个中间定理——标题写"AI证明了费马大定理",其实怀尔斯1995年就证完了,这次是把人类已有推理翻译成机器可逐步核验的形式。真正的产出是海量带可验证标签的中间步骤:Mathlib 社区攒了十年攒到几百万行,Claude 十一天攒出它的五倍。
英伟达投了 Harmonic(1.2亿美元C轮、估值14.5亿美元),Axiom Math 三月融2亿美元、20个人的公司估值16亿——定理是训练目标,产品是"验证"。Axiom 创始人 Vlad Tenev 说得最不绕:"我们看到的世界是绝大多数软件和硬件都由 AI 生成并被形式化验证。"AI 要写走所有代码和芯片,就得有办法证明它写的东西是对的,而世界上唯一能给这种证明的技术栈就是 Lean 那一套。
Google 已经在收钱:AlphaEvolve 成了下一代 TPU 设计的常规工具,发现更高效的缓存替换策略(两天干完以前几个月的人力活),在 Willow 量子处理器上给出误差低十倍的量子线路。
所以"攻克名题"头条背后的真实竞赛是:谁囤到更多可验证的推理,谁把"可验证"做成产品。数学猜想只是这条技术路线上质量最高的训练场。
五、和你有什么关系:一个三问清单
你可能要说:我既不是数学家,也不买英伟达股票,这事跟我有什么关系?两个关系。
一个是谈资。 这周饭桌上再有人说"AI把千禧年难题解决了",你可以接:"证的是官方表述里爆破那个方向,克雷还要两年发表期验证;更大的新闻其实是菲尔兹奖得主联名抗议——因为这比赛里选手和裁判是同一批人。"信息差大概就这么多。
另一个更实际:这13天暴露的结构性矛盾——“生成快、验证慢”——砸中的是每个用 AI 干活的人。 AI 产出"看起来成立的结论"的速度,已经超过了人消化它的速度;数学界今天遇到的,你用 AI 写方案、写代码、做分析时明天就会遇到。Lean 尚且只能查自洽、查不了"这是不是你要的命题",AI 给你的报告同理:数字可能全对,回答的是不是你的问题,只有你能核。结论越漂亮,力气越该花在验证上,而不是转发上。
所以下次刷到"AI攻克XX",先过三问:
谁说的? 官方公告、arXiv 论文,还是博主转述匿名研究者?今天哥德巴赫的源头,就是一个百来粉丝、8天连发6个证明、无头衔无署名无背书的匿名账号——成果可能是真的,但核验只能等数学界跟上。夕小瑶科技说
证了什么? 完整难题、官方表述里的一个方向,还是变体弱版?(NS 是第二种,哥德巴赫是第三种。)
谁在验? 机器自洽核验、同行评审,还是时间?(克雷的答案:至少两年。)
顺便说一句给纠结数学专业、竞赛路线的学生和家长:知乎这两天"GPT-6正在堵死大学生竞赛道路"的专栏两天拿了363赞。B站今天播放最高的相关视频标题是"AI推进了哥德巴赫猜想,但数学仍然是最好的专业"。被自动化的是"解题"环节,变贵的是"提问、验证、解释"环节——瓶颈在移动,但没有消失。知乎专栏哔哩哔哩
六、值得继续盯的信号
克雷研究所对 NS 证明的官方态度,以及那份166页论文的同行评审进度;
今天这个刘维尔函数结果的 arXiv 论文和 Lean 社区复核;陶哲轩维护的 Erdős 问题 AI 贡献 wiki 怎么标注它——那个页面逐条标注每次贡献是"真新证明、文献检索还是有错",是目前全行业唯一的免费第三方判卷。知乎
OpenAI 会不会把那个"明显强于 Astra"的内部模型产品化——拿它当公关核武器是一回事,放进普通人的订阅里是另一回事,后者才真正关系到你的钱包;
下一道题已经在路上:据 The Information 9月中旬爆料,OpenAI 内部系统已非常接近第二道千禧年难题——霍奇猜想,但这一次 OpenAI 破天荒按住了公告。上一场风暴的代价他们自己最清楚,什么时候发、怎么发,本身就是观察 AI 公司和数学界关系走向的窗口。神经晶格
下一个被"排队攻下"的领域。逻辑简单粗暴:按验证成本排队,不按重要性排队。方程类理论物理、编译优化、芯片布局在第一梯队(判定器免费且即时),计算材料第二梯队,生物最后(判定器是活细胞,延迟按周计)。而临床医学、宏观经济、气候这些"判定器就是历史本身"的领域,接下来几年会显得跟不上节奏、承受不该承受的舆论压力——它们不慢,它们只是不长得像数据中心。
写在最后
佩雷尔曼当年解决庞加莱猜想后拒领百万美元奖金,很多人觉得他怪。现在回头看,那里面有大智慧:我们可能太看重谁最后砍下了那条龙,太不看重前面那些人砍出来的每一刀。
这一次,前几刀是 Córdoba、Martínez-Zoroa、Buckmaster 和 Alpöge 砍的。AI 会记得斩龙的人,因为头条需要它;但看戏的人不妨也记得砍出每一刀的人——并且记得,这条流水线上最细的那根管子,是全世界能读懂1300万行 Lean 代码、还愿意免费给全行业判卷的那几百个人。
目前为止,没有任何一家公司在给这根管子扩容。知乎