


















24
31
Anthropic开源神级项目,专治黑心AI中转站!
2026-11-16 22:08:56
0点赞
0收藏
0评论
大家好,我是小林。
现在用 Claude、GPT 这些模型,很多同学走的都是中转站,便宜,还不用折腾账号。
但用久了总会有一种说不清的感觉,同样标着 Opus,今天聪明得像个架构师,明天笨得像刚入职的实习生。
那问题来了,你花钱买的那个模型,中转站真的给你了吗?
说实话,这件事以前只能靠猜。
直到 11 月初,Anthropic 开源了一个叫 FlashProve 的项目。
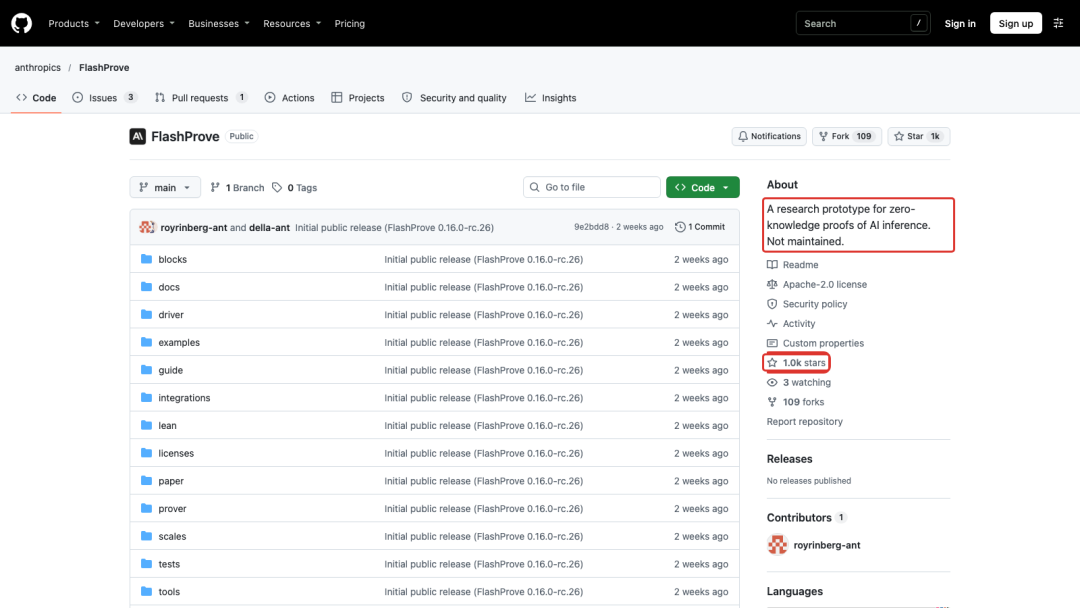
简单来说,这个项目是让模型厂商在返回回答的同时再交一份凭证,证明这条回答确实是你选的那个模型算出来的,这样真假不用再猜,自己验一下就知道了。
除了放出代码,Anthropic 还专门写了一篇博客,叫「大语言模型可证明推理的进展」,把为什么要做这件事从头讲了一遍。
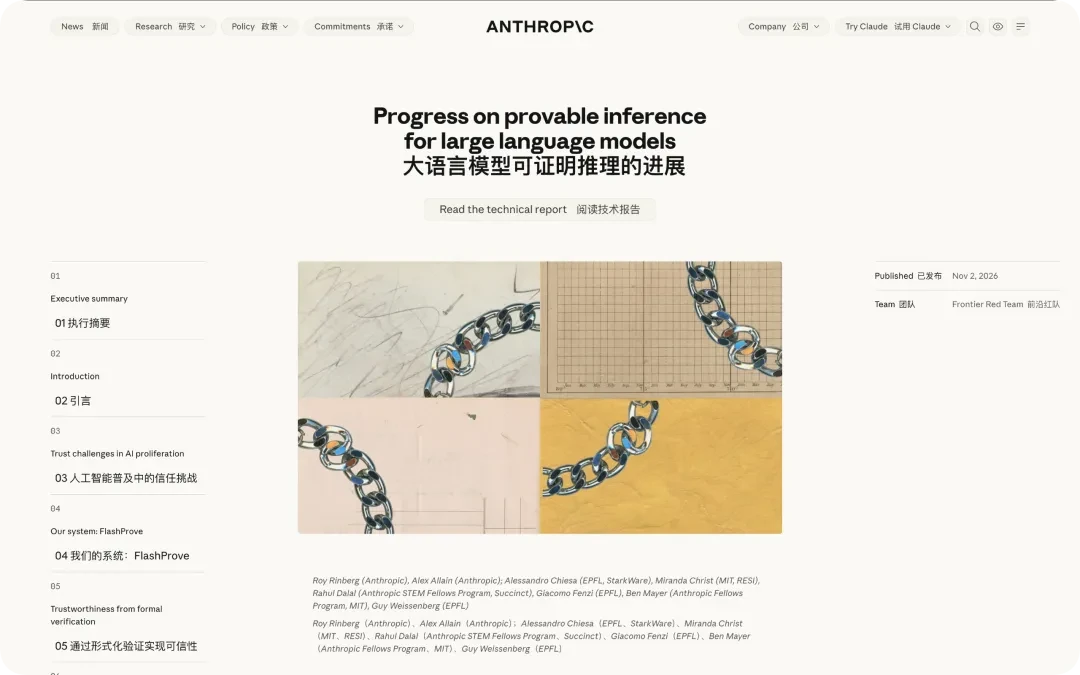
更有意思的是,这篇博客讲动机的时候直接点了中转站的名,说模型可能被中转站出于成本原因偷偷换掉。
好家伙,这说的不就是中转站掺水吗?
这次我就带大家一层层拆开 FlashProve,看看套壳模型到底是怎么被识别出来的。
────01|中转站是怎么掺水的?────先看一次请求是怎么走的。
你在客户端里选了 Opus,请求先发到中转站,中转站再转给上游的服务商,最后才落到某个模型上,回答再沿着原路返回。
整条链路上,你能看到的只有最后回来的那段文字。至于中间到底是谁在回答,完全是个黑盒。
所以掺水的成本非常低。你付的是 Opus 的钱,中转站把请求转给一个便宜几倍的模型,再把回答原样塞给你,差价就到手了。
更鸡贼的做法是掺着来,十次请求里八次给真货,两次换成便宜货。你就算觉得今天的回答有点笨,也只会怀疑是不是自己的提示词没写好。
────02|为什么一直验不出来?────看到这估计有同学就问了,验个真假而已,有这么难吗?
我们把能想到的办法挨个试一下。
最容易想到的是直接问模型「你是谁」。可惜这招基本没用,中转站只要在系统提示词里加一句「你是 Claude Opus」,随便哪个模型都会乖乖照着念。
那问一些只有新模型才知道的事情呢?或者对比回答风格、检查返回字段?这些办法社区里都有人在用,但说到底都是在看长相,长得像不代表就是本人。碰上一次答错,你也分不清是模型本来就会错,还是被换了。
真正靠谱的办法其实只有一个,拿到那个模型的权重,自己用同样的输入再跑一遍,看输出对不对得上。
但这条路普通人根本走不通。Claude 这种闭源模型,权重是厂商的命根子,不可能给你。就算是开源模型,几百 GB 的权重加上高端显卡,也不是谁都跑得起的。
所以问题就变成了,有没有一种办法,不用看到权重,也不用自己重跑一遍,还能确认回答确实是那个模型算出来的?
听起来有点既要又要对吧,FlashProve 干的就是这件事。
────03|FlashProve 怎么验明正身?────FlashProve 的思路很直接,别听服务商怎么说,让服务商拿证据。整个流程分成三步。
第一步,给权重留指纹模型说到底就是一大堆权重参数,权重定了,这个模型也就定了。
所以第一步,模型厂商先对着自家权重算出一个很短的「指纹」,然后把指纹的 ID 公开出去。
这个指纹有两个特点。一是绑得死,权重哪怕只动一个数,算出来的指纹就完全不一样。二是反推不了,拿着指纹看不出权重长什么样。写过后端的同学应该很熟悉,这和存密码时只存哈希值是一个路数。
第二步,每条回答配一份凭证指纹只是把模型钉住了,还得有东西能说明,某一条回答真的是这个模型算的。
所以第二步,服务商每处理一个请求,都要用 GPU 额外算出一份「凭证文件」。这份凭证说的是这样一句话,「指纹对应的那套权重,吃进这段输入,算出来的就是这几个输出 token」。
注意这句话里同时绑了三样东西,权重、输入、输出。三样里任何一样被换掉,这份凭证就废了。
第三步,用户自己验最后一步轮到用户。你手里拿着四样东西,从可信渠道拿到的指纹、自己发出去的提示词、收到的回答、服务商给的凭证文件,一起丢进验证器里跑一下。
验证器不需要 GPU,也不需要权重,用 CPU 跑二十秒左右就出结果。对得上就输出 YES,对不上就是 NO。
────04|不看权重,凭什么信?────流程看着挺顺,但你仔细想想,这里有个地方很反直觉。
模型跑一次推理,背后是天文数字级别的乘法和加法。验证的人既没有权重,也没重新算一遍,凭什么二十秒就敢说「算得没错」?
FlashProve 能做到这一点,背后用的技术叫 zkSNARK,名字很唬人,我用一个查账的例子把思路讲清楚。
假设你是老板,外包团队交上来一本一百万笔的流水账,你想确认里面没有假账。老实的办法是一笔笔重算,这就相当于自己把模型重跑一遍,太贵了。
那随机抽查一百笔行不行?
不行。对方只要在一百万笔里改一笔,你抽中的概率只有万分之一,基本等于白查。
FlashProve 的办法可以拆成三招。
第一招,先让对方把账本加工一遍。
按照一套固定的数学规则,把原账本展开成一份更长、带大量冗余的版本。这套规则有个很妙的性质,原账本里哪怕只改了一笔,加工后的版本会有一大片地方跟着对不上。原理上和通信里的纠错码是一家,纠错码是给数据加冗余,这里是给计算过程加冗余。
这样一来小谎就被放大成了大谎,随便抽几处都很容易撞上。
第二招,先封存再抽查。
对方得先给加工后的账本算出一个哈希树的根交上来,等于交卷封存,之后再想改任何一处,哈希都对不上。
第三招,抽哪里由哈希说了算。
抽查的位置是拿前面交上来的内容算哈希得出来的,对方没法提前知道会查哪里,也没法挑着对自己有利的位置给你看。
三招合起来,造假的人就被逼进了死角。账本封存之后才知道要查哪里,而任何一处假账都已经扩散得到处都是,想蒙混过关,就得去攻破哈希函数。
这就是 zkSNARK 技术名字里那个 S 的含义,Succinct,简洁。验证的人只需要检查少量抽查点,工作量比重算一遍小了好几个数量级。
那前面的 zk 呢?zk 是零知识(zero-knowledge)的缩写。加工账本的时候会掺进去一些随机数,所以你抽到的那些位置看起来就是一堆乱码,拼不出原账本的内容。
对应到 FlashProve,用户能确认回答是那套权重算的,但看不到权重,看不到中间的计算结果,连模型每一层调用了哪几个专家都看不到。
这一点对 Anthropic 太关键了。大家都知道 Anthropic 这两年最烦的就是被蒸馏,要是每发一份凭证都漏一点权重信息,那等于是在给别人送素材。
────05|套壳会在哪一步露馅?────原理讲完,回到大家最关心的问题。
假设未来 Anthropic 真的给 Claude 接上了这套东西,指纹也由官方公布,中转站再想掺水会卡在哪里?
拿三种作弊手法走一遍。
• 第一种,偷换模型。 中转站收了 Opus 的钱,把请求转给了便宜模型。这时候你让中转站把凭证一起交出来,中转站就傻眼了。凭证文件必须由手里有权重的人来算,而便宜模型的权重和官方公布的 Opus 指纹对不上,硬算出来的凭证,验证器一验就是 NO。 • 第二种,张冠李戴。 中转站学聪明了,偶尔真的调一次 Opus,把拿到的合格凭证存下来,以后贴到便宜模型的回答上。这招也不行,前面说过每份凭证都把输入和输出绑死了,回答里哪怕只差一个 token,或者提示词换了,这份凭证就对不上。 • 第三种,伪造凭证。 干脆自己编一份能通过验证的凭证?这相当于要攻破背后的哈希函数,成功的概率小到可以直接当成零。你发现没有,这三种手法能被堵死,靠的都是同一件事,每份凭证都把「哪套权重」「什么输入」「什么输出」捆在了一起。
问「你是谁」,验的是模型嘴上怎么说。FlashProve 验的是这次计算到底有没有发生过,嘴可以骗人,计算过程骗不了。
────06|以前为什么没人做成?────对了,用零知识证明给模型验身,这个想法其实早就有了,区块链圈玩零知识证明也玩了很多年。那为什么一直没人做成?
两个字,太慢。
Anthropic 在博客里举了个例子。这次实验没用自家的 Claude,用的是 Meta 开源的大模型 Llama 4 Maverick,参数量有 4000 亿。同样是给这个模型生成凭证,之前一套叫 VerInf 的方案,处理 1000 个 token 要 14.3 个小时,凭证文件有 93.6 GB,光验证就花了将近一天。验一条回答要等一天,这谁受得了。
FlashProve 把这几个数字压到了什么程度?一张 H100 显卡,24 个请求攒成一批,223 秒算完,折合每秒处理 110 个 token。每份凭证 18.78 MB,验证只要 17 到 21 秒。
那 FlashProve 是怎么快起来的?
Anthropic 自己说得很实在,没发明什么全新的方法,是把学术界现成最好的几块积木拼到了一起。
我挑两个好理解的点说一下。
一个是只给真正干了活的参数算凭证。Llama 4 Maverick 是混合专家(MoE)架构,4000 亿参数里,每个 token 实际用到的只有 170 亿左右。生成凭证的工作量跟着这 170 亿走,一下就省掉了九成多。
另一个是事后批量生成凭证。回答照常先返回给用户,生成凭证的活放到另外的机器上,攒够一批再一起算,一个请求大概等五分钟能拿到凭证文件。这样凭证算得再慢,也不拖累你聊天的速度。
────07|中转站真要凉了吗?────讲到这里,估计不少同学已经准备去给中转站点蜡了。
先别急,我得泼几盆冷水。
第一盆,指纹得有人背书。
假如黑心中转站自己拿个小模型算一份指纹,告诉你「这就是 Opus 的指纹」,后面的凭证文件照样能通过验证。因为验证器只管输出和指纹对不对得上,不管指纹背后是谁。
这和 HTTPS 很像。服务器的签名能说明自己手里有私钥,却说明不了自己就是银行,所以才需要 CA 给公钥盖章。
FlashProve 的指纹也需要这么一个盖章的角色,官方文档写得很明白,指纹必须从你信任的渠道拿,绝不能从被检查的那台服务器拿。可目前这套发指纹的机制还不存在。
第二盆,得厂商自己愿意出凭证。
凭证文件只有手里有权重的人才算得出来,也就是说要 Anthropic、OpenAI 这些厂商亲自下场。
而这次实验用的是 Meta 的开源模型,Anthropic 从头到尾没说 Claude 什么时候会用上,仓库首页也写着这是个研究原型,不维护,不接受贡献。
第三盆,又贵又短。
生成凭证消耗的 GPU 时间是正常推理的 70 到 95 倍,这笔钱谁来出?
上下文目前最长只支持 1024 个 token,我们平时用 Claude Code 写代码,一轮对话动不动就是几万 token,完全不够用。
第四盆,正常的回答都可能验不过。
这一条最容易被忽略,我觉得也是最要命的。
FlashProve 的凭证针对的是一个整数版本的模型,而且要求每个 token 都是模型打分最高的那个。可线上真实的服务用的是浮点计算,生成时还带随机采样,两边的结果本来就不会完全一样。
差多少呢?Anthropic 自己测过,整数模型和 16 位精度的模型相比,有 6.81% 的位置首选 token 不同。他们从两个推理引擎各取了 96 条正常回复去验,按最严格的规则,一条都没通过。
所以实际用的时候只能放宽规则,不要求每个 token 都是第一名,只要和第一名的分差别太大就行。可规则一松,漏洞也跟着来了,官方文档自己也承认,限制设得宽松时,几乎什么输出都能通过。
第五盆,验的只是权重。
就算上面这些都解决了,FlashProve 能回答的也只有「这几个 token 是不是那套权重算出来的」。
回答有没有被提前掐断,模型答得对不对,都不在验证范围里。
也就是说,被截短的回答会被当成一条更短的回答正常通过。所以凭证验过了,只能说明模型没被换,不代表说模型有没有被降智。
────最后────回到大家关心的问题,Anthropic 这个开源项目,会把中转站干掉吗?
短期内还是很难干掉。成本、上下文长度、指纹的发布机制,哪一样都还没到能上生产的程度,Anthropic 自己都还没说要给 Claude 用。
但我觉得方向是对的。以前我们用模型,服务商说是什么就是什么,全靠信任。
FlashProve 在 4000 亿参数的模型上,把给一条回答出凭证的时间,从等一天拉到了等几分钟。以前这件事贵到想都不敢想,现在虽然还是很贵,但已经是一笔算得过来的账了。
等到哪天成本再降一两个数量级,官方 API 的每条回答都附带一份凭证,中转站再想掺水,用户自己一验就露馅了。
参考文章:https://www.anthropic.com/research/provable-inference